DeepSeek V4.1 Flash-1017 更新:價格不變,搜尋 API 11 月起收費
DeepSeek V4.1 Flash-1017 分數全面上升,API 價格不變。新開放的搜尋與抓網頁 API 每千次 0.75 美元,經 Claude Code 等工具的呼叫 11 月 1 日起計費。
10 月 17 日,DeepSeek 把 API 上的 deepseek-flash 換成了新版本 DeepSeek-V4.1-Flash-1017。模型名稱沒變,價格沒變,分數在官方列出的 11 項測驗裡全部上升。
同一天還有第二件事,影響可能更直接。DeepSeek 把自家的網路搜尋和抓網頁功能開放成獨立的 API,每 1,000 次成功請求收 0.75 美元。DeepSeek 也寄了一封信給 API 使用者:如果你是透過 DeepSeek Harness、Claude Code 或 Codex 在用 DeepSeek,這些工具在伺服器端做的搜尋和抓網頁,其實早就在打這兩支 API。現在不收錢,北京時間 11 月 1 日 0 點起按次計費。
這篇把兩件事放在一起看。資料來自 DeepSeek 的公告頁、定價頁、Search & Fetch 指南、更新日誌、Claude Code 接入說明,以及 Hugging Face 上的模型卡,這幾頁我在 10 月 19 日逐一打開核對過;搜尋價格的比較另外用了 Claude Platform 的定價頁。文中的分數都是 DeepSeek 自己公布的,我沒有自己跑。
這次換掉的是哪個模型?
 圖 1:DeepSeek 10 月 17 日的公告(來源:DeepSeek API Docs)
名字有點繞,先理一下。DeepSeek 在 9 月 10 日發表了 V4.1-Flash,那次公告說它是新架構家族裡最小的模型,552B 參數的 MoE,輸入端啟用 8B、輸出端啟用 16B,並且原生支援看圖。這次的 V4.1-Flash-1017 是它的小改版,Hugging Face 模型卡的原話是「a minor update to DeepSeek-V4.1-Flash」。
對 API 使用者來說,最重要的一句在更新日誌裡:呼叫方式和價格都不變,繼續用 deepseek-flash 就會拿到新版本。網頁版和 App 也一起換了。舊的模型名稱 deepseek-v4-flash 和 deepseek-v4-flash-vision-exp 還能用,但定價頁的註腳寫得很清楚,這兩個名稱的請求現在都由 1017 版處理,照 Flash 的價格計費。
所以你什麼都不用改,就已經在用新模型了。這是好消息,也是要注意的地方:如果你的產品對輸出格式很敏感,這次的升級是默默發生的,最好跑一下自己的回歸測試。
權重同步放上了 Hugging Face 和 ModelScope,模型卡寫的授權是 MIT。有一個數字我對不起來:Hugging Face 頁面自動顯示的大小是「763B params」,跟 9 月公告的 552B 不一樣。前者是平台依權重檔計算的數字,可能把視覺模組或其他元件也算進去了,但模型卡本身沒有解釋,我不確定差在哪裡。
模型卡還提到推薦的取樣參數:temperature 1.0、top_p 1.0,最大輸出建議設在 256K 以上。另外這個版本沒有附 Jinja 格式的對話範本,改成提供一份 Python 的參考實作,自己部署的人要留意。
分數漲了多少?
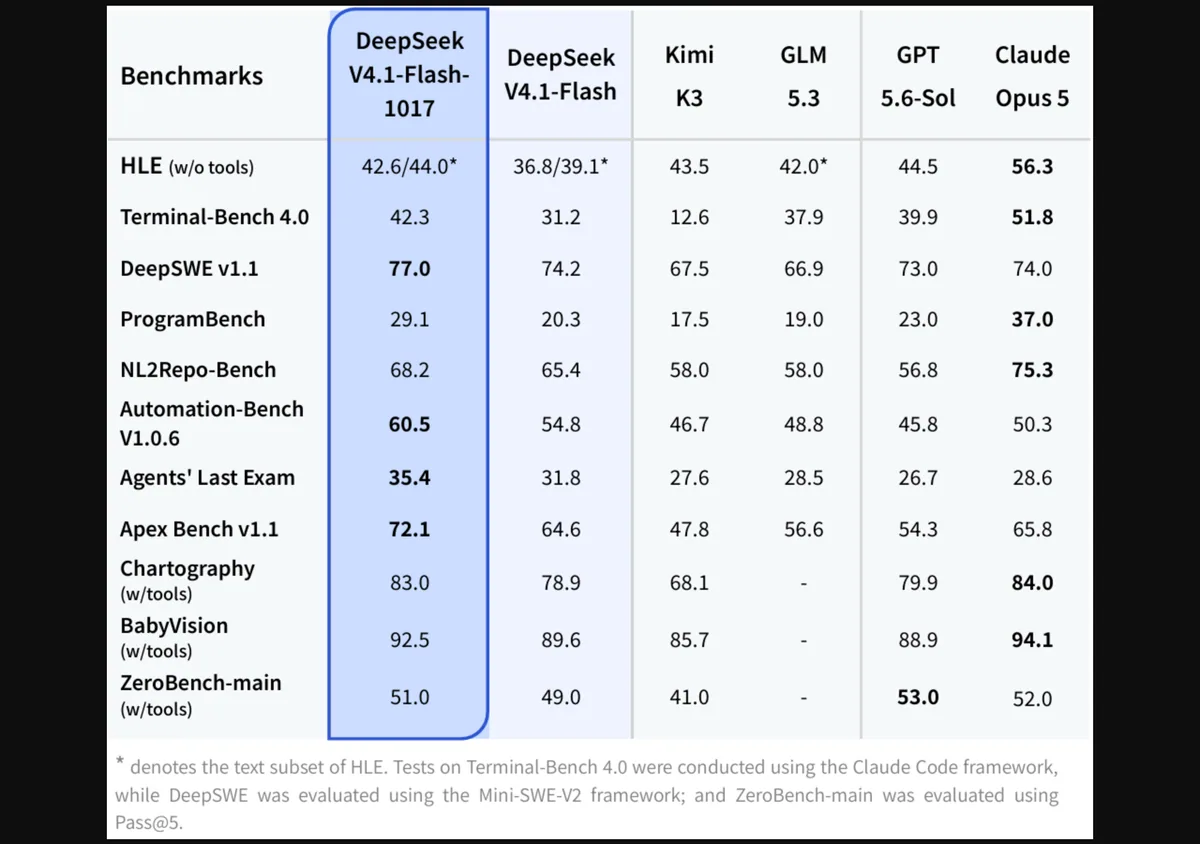 圖 2:DeepSeek 官方的分數表(來源:DeepSeek API Docs)
官方表格放了六欄。我把 1017 版和 9 月版逐項相減,整理成下面這張。
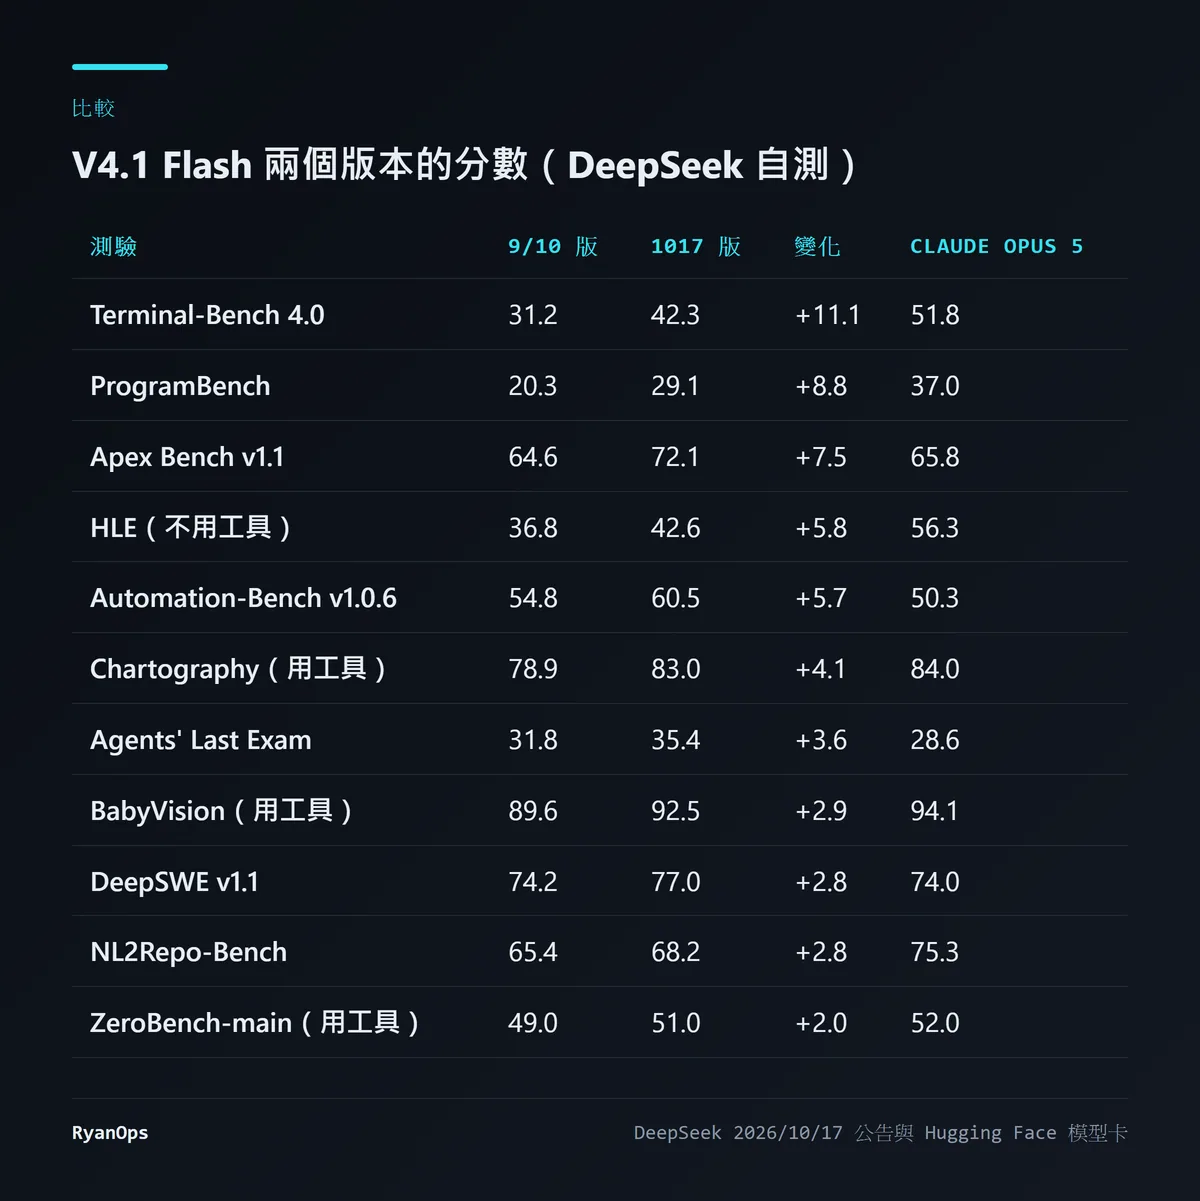 圖 3:兩個版本逐項相減的結果(資料來源:DeepSeek 公告、Hugging Face 模型卡)
11 項全部上升。漲最多的是 Terminal-Bench 4.0,從 31.2 到 42.3,多了 11.1 分;其次是 ProgramBench 多 8.8 分、Apex Bench v1.1 多 7.5 分。漲最少的是 ZeroBench-main,只多 2 分。整體看起來,進步集中在終端機操作和從零寫完整專案這類代理任務,這也跟公告第二段「從零做出完整專案」的主題對得上。
跟表裡的 Claude Opus 5 比,1017 版贏了 4 項:DeepSWE v1.1(77.0 對 74.0)、Automation-Bench(60.5 對 50.3)、Agents’ Last Exam(35.4 對 28.6)、Apex Bench(72.1 對 65.8)。其他 7 項還是落後,HLE 差了 13.7 分,Terminal-Bench 4.0 差 9.5 分。
讀這張表有幾件事要先知道:
- 這些都是 DeepSeek 自測的數字。 表格註腳寫,Terminal-Bench 4.0 用的是 Claude Code 這套代理框架,DeepSWE 用的是 Mini-SWE-V2,ZeroBench-main 算的是 Pass@5,也就是五次裡有一次對就算過。換一套框架,分數可能就不一樣。
- HLE 的格子有兩個數字。 42.6/44.0 裡,帶星號的 44.0 是只算純文字題的子集。
- 比較對象是 Opus 5,不是現在在賣的 Opus 5.5。 Anthropic 目前的主力是 Opus 5.5,本站整理過它的價格怎麼算。表裡沒有它,所以「贏過 Claude」這種說法要打折聽。
基準測試分數本來就只是參考,要等獨立的評測出來才比較準。
「輸出更短」到底省多少?
公告說新版完成任務更快、輸出更短,但文字裡沒有給數字。數字藏在公告附的一張圖裡。
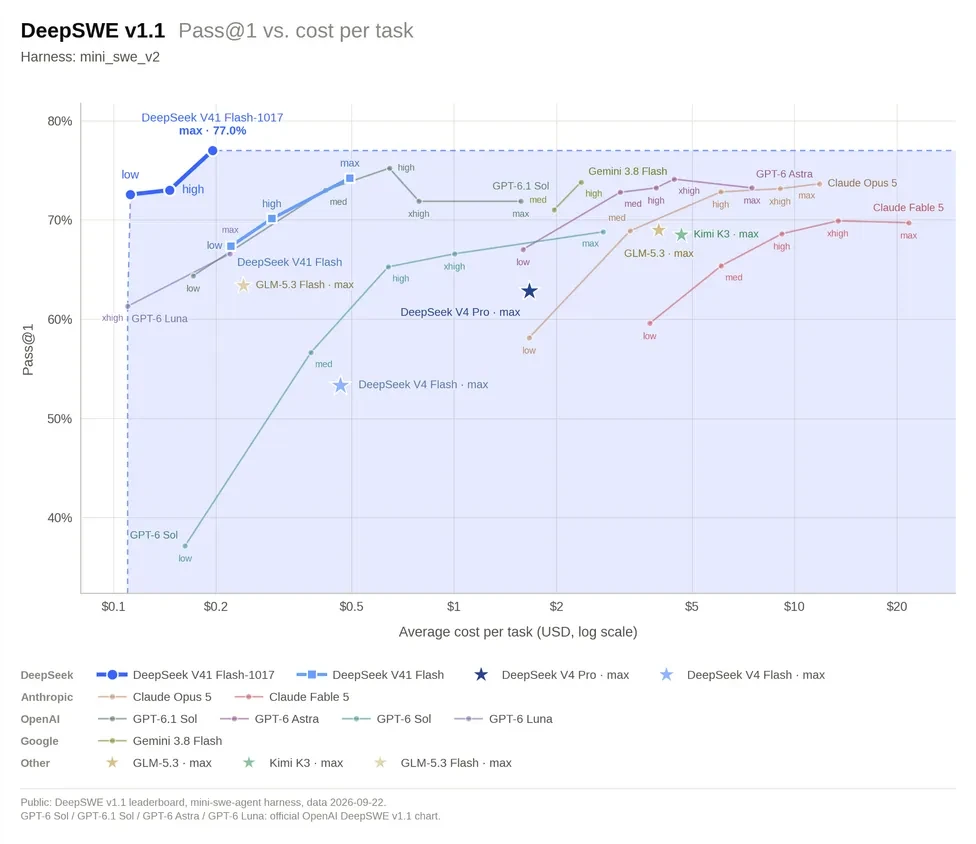 圖 4:每個任務的成本對解題率(來源:DeepSeek API Docs)
這張圖的橫軸是每個 DeepSWE 任務的平均花費,用對數刻度,縱軸是一次就解出來的比率。我照圖上的位置讀:1017 版在 max 思考檔位大約落在每題 0.2 美元,拿到 77.0%;9 月版在同一個檔位大約 0.5 美元,解題率 74% 左右。如果我讀得沒錯,同樣的價目表下,每題的花費少了一半以上。這就是公告說的「效能和成本同時改善」。
圖上其他模型的點,註腳寫是取自 9 月 22 日的 DeepSWE v1.1 公開排行榜,OpenAI 的幾個模型則來自 OpenAI 自己的圖表。同樣照位置估,Claude Opus 5 從 low 檔位每題約 1.7 美元到 max 檔位約 12 美元,Claude Fable 5 大約在 4 到 22 美元之間,兩者的解題率都沒有超過 74%。
要提醒的是,這些數字都是我從圖上的位置估的,不是官方給的數值。而且每題成本取決於每百萬 token 的單價,DeepSeek 的單價本來就低很多,這張圖比較的其實是「價目表加上輸出長度」的總效果。
價格沒變:每百萬輸出 token 還是 0.6 美元
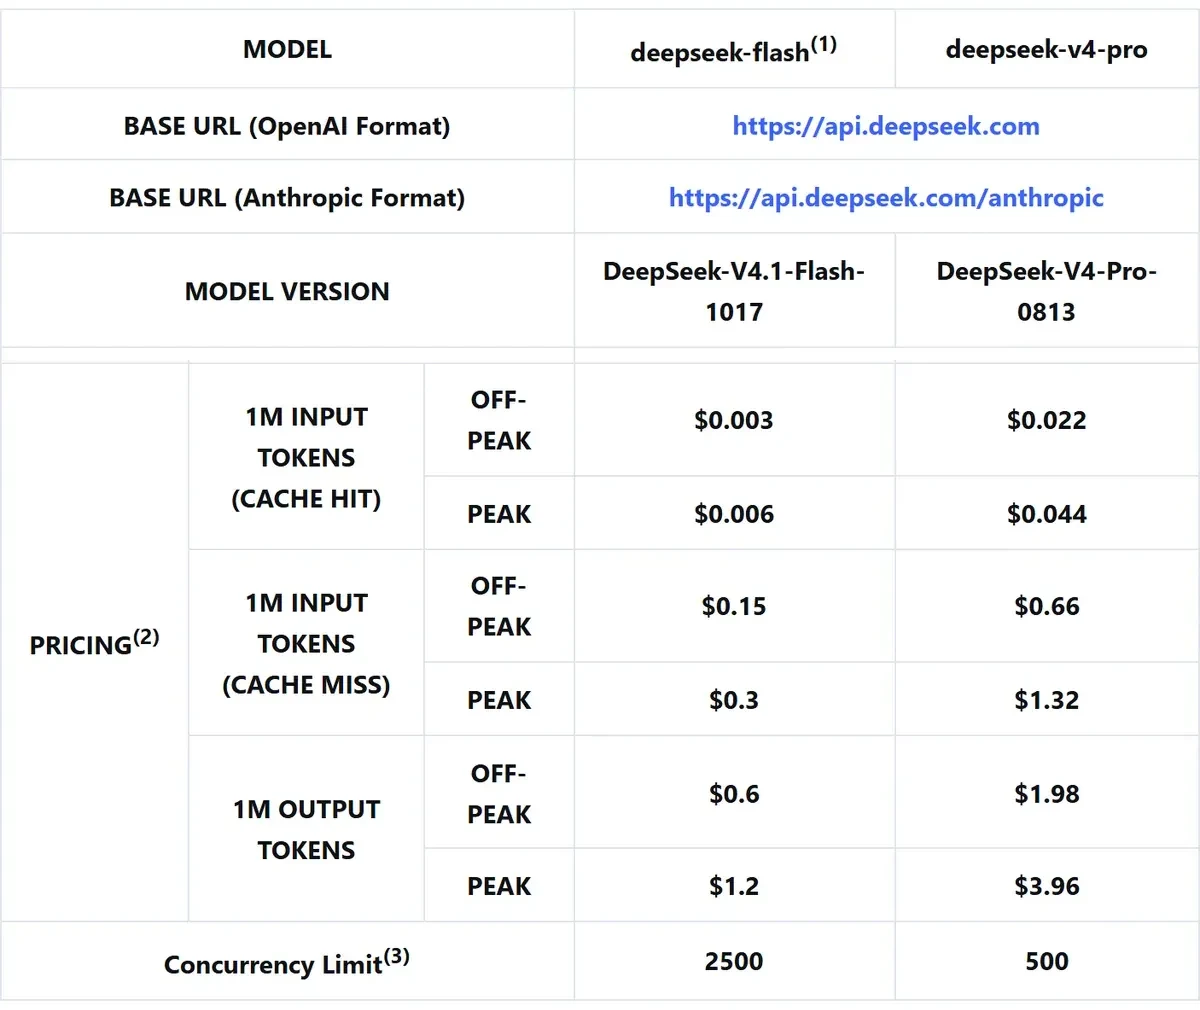 圖 5:定價頁上的兩個模型與價格,中間的功能列已省略(來源:DeepSeek API Docs)
我打開定價頁確認,deepseek-flash 那一欄已經寫著 DeepSeek-V4.1-Flash-1017,價格跟 9 月一樣。每百萬 token,離峰時段的快取命中輸入 0.003 美元、快取未命中 0.15 美元、輸出 0.6 美元;尖峰時段全部加倍,也就是 0.006、0.3、1.2 美元。
尖峰時段是週一到週五 UTC 01:00 到 04:00,以及 06:00 到 10:00,中國的國定假日除外。換成台灣時間,是平日的早上 9 點到中午 12 點、下午 2 點到 6 點。其他時間,包括整個週末,都算離峰。這套制度的來龍去脈,本站在 V4.1 Flash 首發時寫過一篇。
表上另一欄是 deepseek-v4-pro,版本是 DeepSeek-V4-Pro-0813。9 月 10 日的公告原本說要讓 V4-Pro 退場,9 月 14 日起把請求轉給 Flash;但更新日誌後來補了一句,因應使用者需求,9 月 14 日之後會繼續提供 V4 Pro 的 API,計費方式不變。所以它還在,而且離峰輸出是每百萬 1.98 美元,是 Flash 的 3.3 倍,並發上限也只有 500,Flash 是 2,500。
這兩個數字放在一起,再加上 9 月的公告本來就說,多方測試顯示 V4.1-Flash 在效能、成本和速度上都勝過 V4-Pro,我自己的看法是:除非你有特定理由,新專案沒什麼必要選 V4-Pro。後面講到 Claude Code 時,這一點會變得很實際。
搜尋和抓網頁 API:每千次 0.75 美元
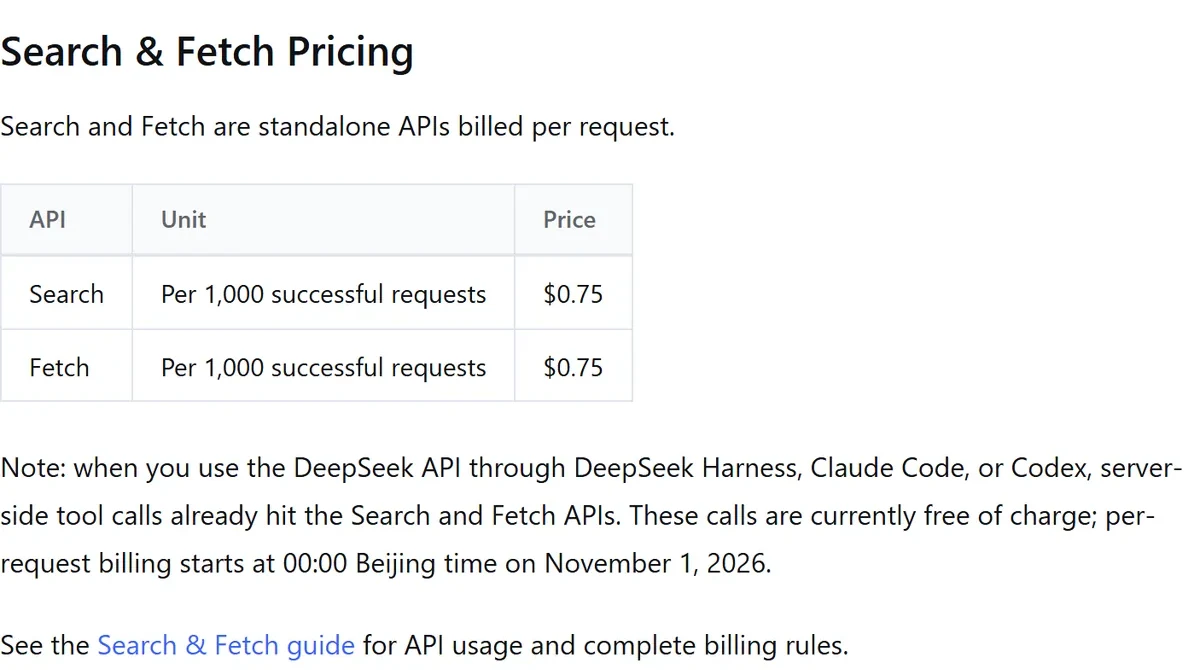 圖 6:搜尋與抓網頁的價格(來源:DeepSeek API Docs)
公告說這兩支 API 由 DeepSeek 自家的搜尋引擎支撐,全球每天處理數億次請求。我讀了 Search & Fetch 指南,整理出你真的會用到的規則:
- 兩支端點。 搜尋是
POST /v1/tools/search,抓網頁是POST /v1/tools/fetch,用的是跟模型 API 同一把 key。 - 搜尋一次最多回 50 筆,價格一樣。
count預設 10,可以設 1 到 50,指南寫明它不影響單次價格。每筆結果有給介面用的短摘要(約 100 到 200 字),也有給模型讀的長摘要(約 600 到 800 字)。 - 支援搜尋語法。
site:、lang:、after:、before:、精確片語和排除詞都能用。 - 抓網頁回傳 Markdown。 給一個網址,回傳標題和轉成 Markdown 的內容。網址最長 8,192 字元。
- 只收成功的請求。 要回傳 HTTP 200 而且真的有結果才算錢:搜尋要有非空的結果,抓網頁要有內容。失敗、沒有結果、逾時都不收。
- 速率限制很緊。 搜尋和抓網頁各自是每個帳號每秒 5 次,不管你有幾把 key。抓網頁另外還有針對單一網域的限制,超過會回 429。
- 餘額不足會直接擋。 指南列的錯誤碼裡,402 代表餘額不足。費用從儲值餘額或贈送餘額扣,兩者都有的時候先扣贈送的。
每秒 5 次這一條,我覺得比價格更值得注意。如果你用的代理工具會開好幾個子代理同時查資料,很容易撞到這個上限。我沒有實測,但從規則來看,大量平行搜尋的工作流得自己做排隊或重試。
用 Claude Code 接 DeepSeek 的人,11 月起會多一筆
DeepSeek 提供 Anthropic 格式的端點,所以很多人是把 Claude Code 的請求導到 DeepSeek 來省錢。官方的接入說明就是設幾個環境變數:ANTHROPIC_BASE_URL 設成 https://api.deepseek.com/anthropic,ANTHROPIC_AUTH_TOKEN 填 DeepSeek 的 key,模型都指向 deepseek-flash。
同一頁也寫了搜尋的事。Claude Code 判斷需要上網時,會呼叫 Web Search 工具,由 DeepSeek 的 API 執行搜尋。說明頁講得很直白:整理搜尋結果會產生額外的模型 token 費用,而搜尋請求本身也要照 Search API 計費。信裡說的「目前免費」,指的就是後面這一段。
計費開始的時間,定價頁寫北京時間 11 月 1 日 0 點,公告寫 10 月 31 日 16:00 UTC,兩個是同一個時刻。台灣跟北京同時區,所以就是 11 月 1 日凌晨 0 點。
會多花多少?先算單次。一次成功的搜尋或抓網頁是 0.00075 美元。拿 Flash 的價目表換算,這等於離峰時段 5,000 個沒命中快取的輸入 token,或是 1,250 個輸出 token。單看很便宜,但它是按次算,而且搜尋結果的摘要還會變成輸入 token 再收一次。
舉一個假設的例子,數字是我設的,不是誰的帳單:一個工作階段裡查了 40 次、抓了 60 個網頁,共 100 次請求,就是 0.075 美元。一個人每個工作天跑 5 個這種工作階段,一個月 22 天,就是 8.25 美元,還沒算模型本身的 token。對個人來說不多;如果是團隊共用一個帳號跑自動化,就值得先看一下用量。
還有一件跟 Opus 有關的事,我在 DeepSeek 的 Claude Code 說明頁看到前後不一致。環境變數的範例把 ANTHROPIC_DEFAULT_OPUS_MODEL 設成 deepseek-flash[1m],但同一頁下方的對應表寫,模型名稱以 claude-opus 開頭的請求會對應到 deepseek-v4-pro,照 V4 Pro 的價格計費。我的理解是:如果你沒有照範例把 Opus 那一格也設好,Claude Code 送出的 Opus 請求會跑到 V4-Pro,輸出價格是 Flash 的 3.3 倍。設定完最好去 DeepSeek 平台的用量頁確認,扣款的模型是不是你以為的那一個。
這個價格算便宜嗎?
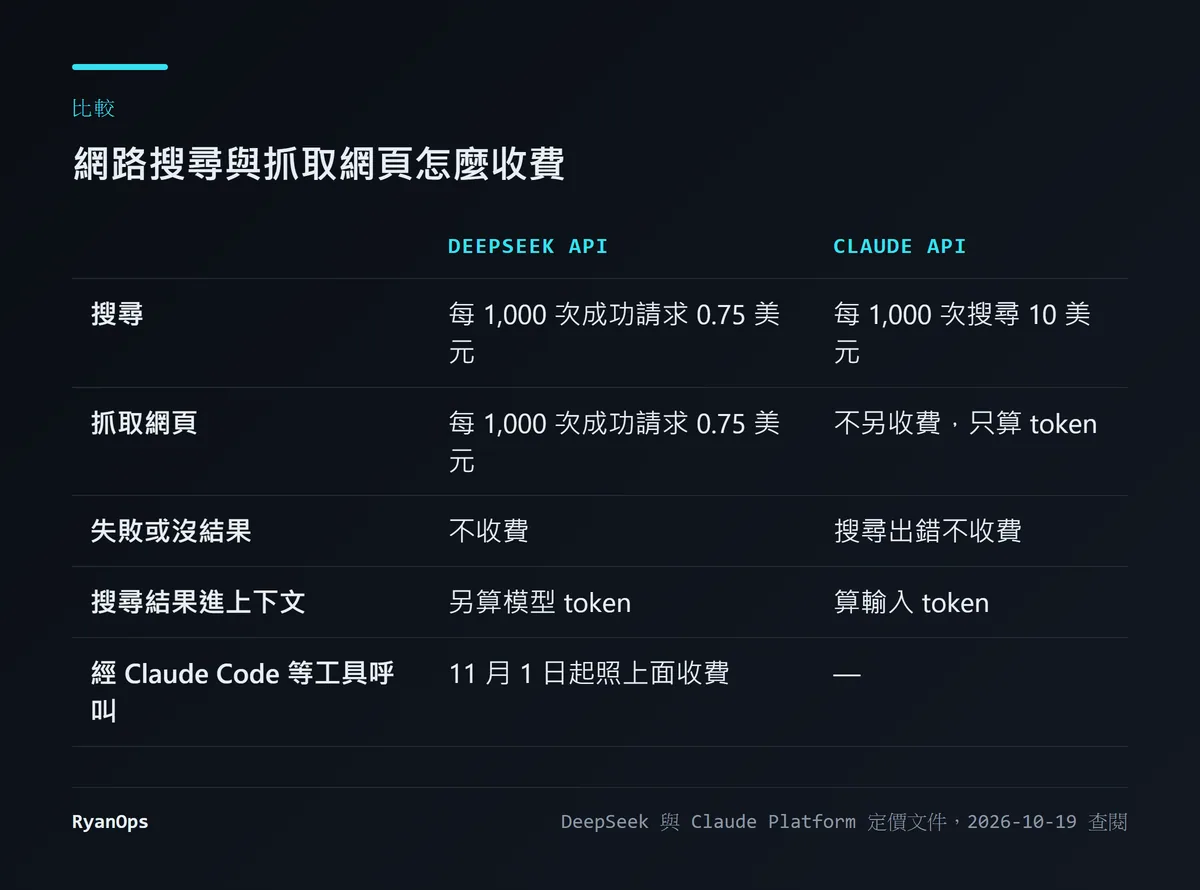 圖 7:兩家的搜尋與抓網頁收費(資料來源:DeepSeek 定價頁、Claude Platform 定價頁)
拿 Claude API 來比最直接,因為很多人本來就在兩邊之間切換。Claude Platform 的定價頁寫,網路搜尋工具每 1,000 次 10 美元,加上搜尋結果算成輸入 token 的費用;出錯的搜尋不收費。網頁抓取工具則不另收費,只算抓回來的內容占用的 token。
所以單看搜尋,DeepSeek 便宜很多,10 美元對 0.75 美元,大約是十三分之一。但抓網頁剛好相反:Claude 那邊這一項不另外收錢,DeepSeek 要按次收。如果你的工作流主要是讀文件、讀 GitHub 頁面,而不是搜尋,DeepSeek 這筆是多出來的新成本。
其他專門做搜尋 API 的廠商,我沒有逐一去查定價頁。Startup Fortune 的報導引了一份發表當天的比較,每 1,000 次大約是 Brave 5 美元、Exa 4 到 7 美元、Perplexity 1 到 5 美元、Tavily 8 到 16 美元。那份比較沒有標出處,報導自己也說只能當粗略參考,我在這裡也只能這樣轉述。
同一篇報導提到另一件事:DeepSeek 的隱私權政策寫明,個人資料會在中華人民共和國境內蒐集、處理和儲存,而 Search & Fetch 指南沒有提到資料保留期限或處理地區。你的搜尋關鍵字和要抓的網址都會送到 DeepSeek。這點我沒有自己去讀隱私權政策原文,是轉述報導的說法;如果你的專案有資料落地的要求,這一條比價格更要緊。
我的看法,以及什麼會讓我改觀
模型的部分沒什麼好猶豫的。同樣的價格、同樣的呼叫方式,DeepSeek 自己的 11 項測驗全部上升,每題成本照圖上看還降了一半以上。你在用 deepseek-flash 的話,已經自動拿到了;要做的只是跑一下自己的測試,確認輸出變短沒有影響到你依賴的格式。
搜尋 API 就要分人看。直接呼叫 API 的開發者,多了一個便宜、規則清楚的搜尋來源,只收成功請求這一點對使用者很友善。但對用 Claude Code、Codex 接 DeepSeek 的人來說,這是一個 11 月 1 日起才會出現在帳單上的新項目,而且很多人根本不知道自己的工具在背後打了這支 API。我覺得 DeepSeek 寄信通知、留兩週緩衝是負責任的做法,只是信寫得很短,很容易被當成廣告略過。
我給的具體建議是三件事:10 月底前看一下自己的工具多常觸發搜尋和抓網頁;確認 Claude Code 裡 Opus 那一格沒有落到 V4-Pro;需要大量平行搜尋的話,先處理每秒 5 次的上限。
什麼會讓我改觀?如果獨立評測顯示 1017 版的分數提升在別的框架下看不到,那「免費升級」就要打折扣。如果 DeepSeek 之後調高搜尋價格,或者把每秒 5 次放寬到能支撐大量代理平行跑,這兩支 API 的定位都會跟著改變。反過來,如果 11 月之後的帳單證明一般使用者每個月只多幾美分,那這整件事就只是一個好消息。


