Claude Fable 5.2 發布:單價是 Opus 5.5 兩倍,每題卻可能更便宜
Anthropic 11 月 9 日發布 Fable 5.2,降價兩成、輸出最多快三成。對照官方成績表、Artificial Analysis、Vals 與四份搶先實測,看它什麼時候比 Opus 5.5 划算。
Claude Fable 5.2 的牌價是每百萬輸入 token 8 美元、輸出 40 美元,剛好是 Claude Opus 5.5 的兩倍。照這個單價,它應該是貴的那一個。
可是 Artificial Analysis 的排行榜上有一組數字跟直覺相反:Fable 5.2 開在 high 努力程度,智慧指數 62 分,跑完一題平均花 9.08 美元;Opus 5.5 開到最高的 max,59 分,每題 10.04 美元。分數高 3 分,每題還便宜一美元。
Anthropic 在 2026 年 11 月 9 日發布 Fable 5.2 和 Mythos 5.2。同一天,Anthropic 開發者部落格 claude.dev 刊出 Addy Osmani 寫的選型指南〈Which Claude model should you build with?〉,把 Fable 5.2 跟 Haiku 5.5、Sonnet 5.5、Opus 5.5 排成同一張表,告訴你什麼工作該用哪一顆。這篇以那份指南為起點,再對照 Anthropic 的發布頁、Claude 平台的定價文件、Artificial Analysis、Vals AI、Arena(arena.ai)的排行榜,以及四份最早出來的第三方實測(其中三份是發布前的搶先試用)。
先講清楚:我沒有自己跑 Fable 5.2。下面的分數和實測全部來自上述來源,我做的是把它們放在一起比、把數字算出來。
Fable 5.2 是什麼?跟 Mythos 5.2 是什麼關係?
發布頁第一段就說明了:Fable 和 Mythos 是「同一個底層模型」。Fable 帶著較強的資安與生物防護,一般開放;Mythos 5.2 拿掉部分防護,只透過資安驗證計畫(Cyber Verification Program)和生命科學驗證計畫給通過審核的機構使用。Claude Enterprise 客戶就算沒加入資安驗證計畫,也能透過 Claude Security 產品用到 Mythos 5.2。
一般人能拿到的是 Fable 5.2:
- API:模型 ID 是
claude-fable-5-2,Amazon Bedrock 上是anthropic.claude-fable-5-2。AWS、Google Cloud、Microsoft Foundry 當天都上架。 - Claude 訂閱:Pro、Max、Ultra、Team、Enterprise 都能用。Anthropic 依訂閱時間長短送一到三次 Fable 額度重置,Pro 方案和 Team 方案的標準席位,Fable 最多可以占每週用量上限的 50%。
- 規格:claude.dev 的比較表寫的是 100 萬 token 的上下文視窗、最多 12.8 萬 token 輸出。Opus 5.5 和 Fable 5.2 一律會先思考(推理模式),努力程度決定想多久。
Fable 5.1 在 Claude 平台文件上已經標成舊版,文件建議遷移到 5.2。
這次發布對多數人最有感的,大概是價格和速度:基礎價從 10/50 美元降到 8/40 美元,輸出速度最多快 30%。分數的部分比較複雜,下一段慢慢拆。
官方成績表:哪些格子是 Fable 的分數,哪些不是?
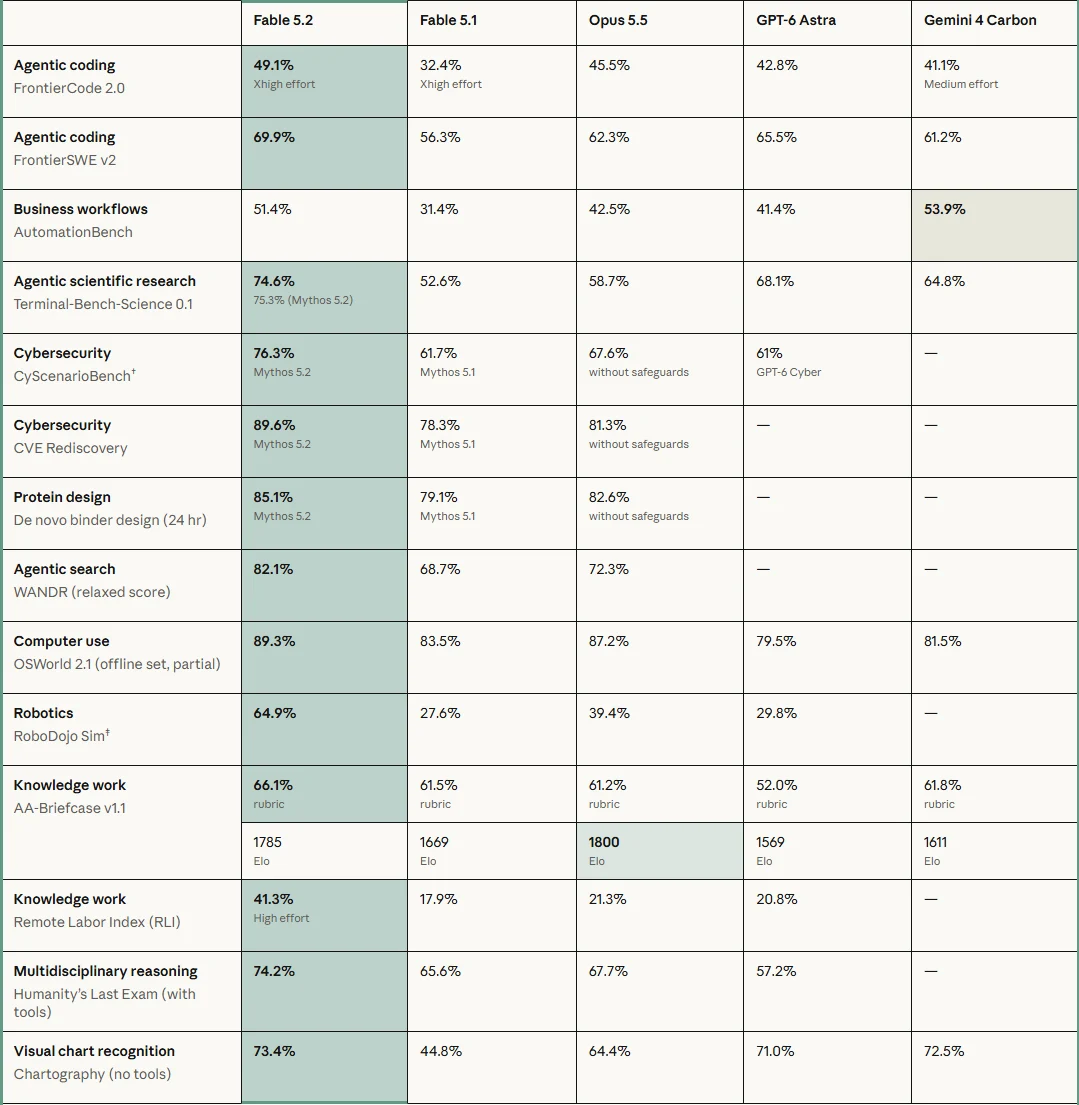 圖 1:發布頁上的成績表,我截圖時把網頁的固定標題列關掉,所以前兩列完整露出來(來源:Anthropic)
這張表有 15 列,比的是 Fable 5.2、Fable 5.1、Opus 5.5、OpenAI 的 GPT-6 Astra、Google 的 Gemini 4 Carbon。讀之前要先知道表底下那行註腳:Fable 5.2、Fable 5.1、Opus 5.5 的分數都是在防護開啟的情況下測的,而且「除非另外註明,每個模型都用它最高的努力程度」。換句話說,這是 max 對 max 的比較,也就是最貴的那一檔。
接著要把幾個容易讀錯的格子挑出來。
有三列根本不是 Fable 5.2 的分數。 CyScenarioBench(76.3%)、CVE Rediscovery(89.6%)、24 小時從頭設計蛋白質結合劑(85.1%),這三格底下的小字都寫著「Mythos 5.2」;Fable 5.1 那一欄同樣是 Mythos 5.1,Opus 5.5 那一欄則標著「without safeguards」(拿掉防護)。這三列告訴你的是同一顆模型拿掉防護之後能做到什麼,跟你用 Fable 5.2 會拿到什麼是兩回事。本站寫 Fable 5.1 成績單時就在這種格子上更正過一次。
科學那一列有兩個數字。 Terminal-Bench-Science 0.1 的 74.6% 是 Fable 5.2,小字的 75.3% 是 Mythos 5.2。差距不大,但要知道你用的是前面那個。
FrontierCode 2.0 的 49.1% 是 xhigh。 這是 Anthropic 說「我們測過的已發布模型裡最高」的分數。改用 high,Fable 5.2 是 45.3%,跟 Opus 5.5 最好的 45.5% 幾乎一樣。這一點 claude.dev 的指南也寫了,後面談成本時會再用到。
Fable 5.2 在自家表上輸了兩格。 AutomationBench(商務流程自動化)51.4%,輸給 Gemini 4 Carbon 的 53.9%;AA-Briefcase v1.1 有兩列,評分表版本 Fable 5.2 拿 66.1% 領先,換成 Elo 積分卻是 1785 對 Opus 5.5 的 1800。表格本身把這兩格的勝方標了底色,Anthropic 沒有藏。
把這些扣掉之後,跟 Opus 5.5 比的差距是這樣(我用表上數字相減):
- Agentic 程式:FrontierSWE v2 69.9% 對 62.3%,多 7.6 分;FrontierCode 2.0 49.1% 對 45.5%,多 3.6 分。
- 科學研究代理:Terminal-Bench-Science 74.6% 對 58.7%,多 15.9 分。
- 搜尋代理:WANDR 82.1% 對 72.3%,多 9.8 分。
- 電腦操作:OSWorld 2.1 89.3% 對 87.2%,多 2.1 分。
- 機器人:RoboDojo Sim 64.9% 對 39.4%,多 25.5 分(註腳說這列是 Anthropic 自己跑的)。
- 遠端工作:Remote Labor Index 41.3%(high)對 21.3%,多 20 分。
- 多學科推理:Humanity’s Last Exam(可用工具)74.2% 對 67.7%,多 6.5 分。
- 圖表辨識:Chartography 73.4% 對 64.4%,多 9 分。
這跟 Fable 5.1 那次很不一樣。5.1 的表上,扣掉科學題,領先自家 Opus 5 的幅度只有 1.4 到 4.5 分。5.2 對上 Opus 5.5,多數列落在大約 5 到 25 分之間。光看官方表,這次的跳幅比上次大。
但還是那句老話:這張表每一格都是 Anthropic 自己測或合作夥伴提供的,沒有一格來自獨立機構。獨立的數字在後面。
單價貴一倍,為什麼每題反而可能更便宜?
先把價格攤開。下面是 Claude 定價文件與 claude.dev 比較表上的列價,單位是每百萬 token:
| 模型 | 輸入 | 輸出 | 快取讀取 |
|---|---|---|---|
| Fable 5.2 | $8 | $40 | $0.20 |
| Opus 5.5 | $4 | $20 | $0.20 |
| Sonnet 5.5 | $2 | $10 | $0.10 |
有一個細節:Fable 5.2 跟 Opus 5.5 的快取讀取一樣是 0.20 美元。長時間跑的程式代理每一輪都要把整段對話重讀一遍,快取讀取常常是帳單的大宗,這一項不貴,兩者的實際價差就會小於兩倍。(token 計價的基本概念可以看詞彙表;Opus 5.5 的價格細節本站另有一篇整理。)
剩下的價差,要看解同一題用掉多少 token。發布頁只說,在 medium 努力程度下,Fable 5.2「能用比 Fable 5.1 更少的 token」完成困難任務,並沒有拿 token 用量跟 Opus 5.5 比。Anthropic 和 claude.dev 給的是三組以每題成本比較的例子;單價貴一倍、每題成本卻比較低,我推測是 Fable 5.2 解同一題用的 token 比 Opus 5.5 少,但這是我從每題成本反推的,不是官方給的數字:
- FrontierCode 2.0:Fable 5.2 開 high 拿 45.3%,跟 Opus 5.5 開 max 的 45.5% 差不多,每題成本「大約一半」。
- WANDR 搜尋代理:Fable 5.2 開 medium 就追平 Opus 5.5 的最高分,每題成本約四成。
- Humanity’s Last Exam:Fable 5.2 開 low 就追平 Opus 5.5 的最高分,每題成本不到十分之一。
這些是廠商自己的帳。獨立的帳可以看 Artificial Analysis(AA),他們把每個模型、每種努力程度都跑一遍智慧指數,記下每題花了多少錢。我把相關的幾列抄出來:
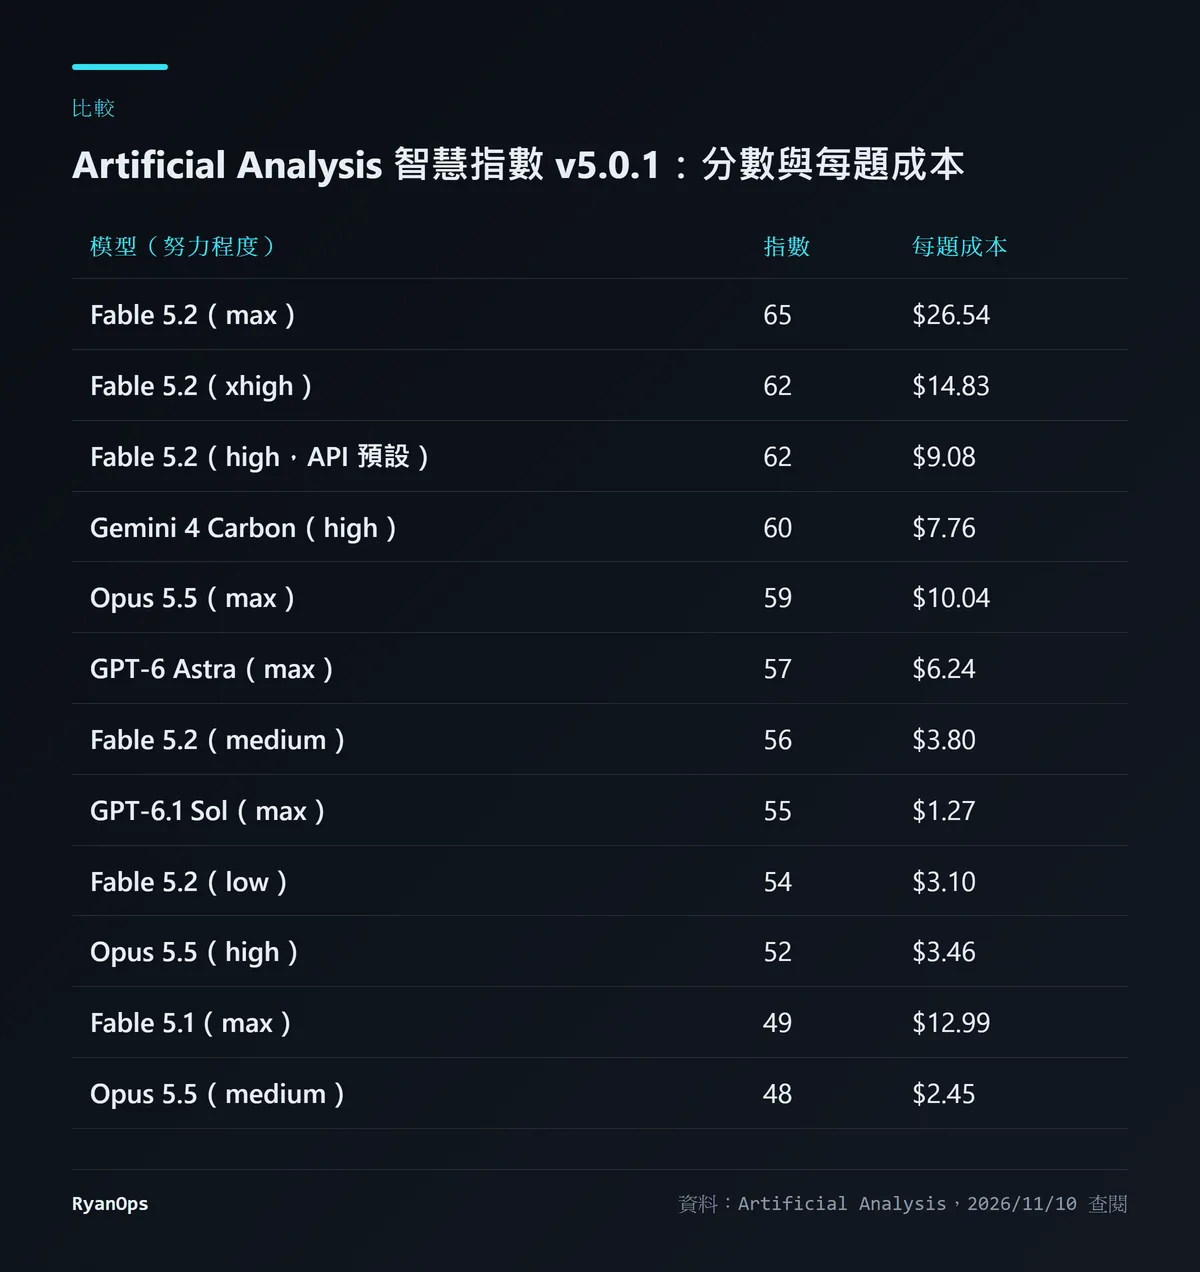 圖 2:依分數排序,每題成本是跑完智慧指數平均一題的花費(資料來源:Artificial Analysis,本文整理)
這張表可以讀出三件事。
第一,AA 的獨立數字支持「每題不一定比較貴」。Fable 5.2 high(62 分,$9.08)比 Opus 5.5 max(59 分,$10.04)分數高、還便宜;Fable 5.2 medium(56 分,$3.80)比 Opus 5.5 high(52 分,$3.46)多 4 分,只貴 0.34 美元。
第二,max 是整張排行榜上最貴的一列。65 分是第一名,比其他模型裡最高的 Gemini 4 Carbon(60 分)多 5 分,但每題 26.54 美元,AA 的模型頁把它排在每題成本 73 名中的第 73 名。每題平均要跑 46.4 分鐘,輸出 token 用了 2.75 億個,這兩項也都排在最後幾名。從 high 到 max,分數多 3 分,成本將近變成三倍。
第三,xhigh 跟 high 同分。62 對 62,每題成本從 9.08 美元變成 14.83 美元。至少在這套測驗上,xhigh 買不到東西。
還有兩個註記。AA 模型頁把這一列標成「Max, Default Fallback」,我讀到的頁面文字沒有解釋這個標籤;我推測跟防護觸發時改由其他模型接手有關,但這是推測。另外,AA 的指數現在是 v5.0.1 版。本站 10 月 31 日寫 Gemini 4 Carbon 時記的是 Carbon 59 分、Opus 5.5 58 分,現在排行榜上是 60 和 59。分數看起來被重新計算過,我查不到具體改了什麼,那篇的數字請當作當時的版本。
跟 Fable 5.1 比,實際改了什麼?
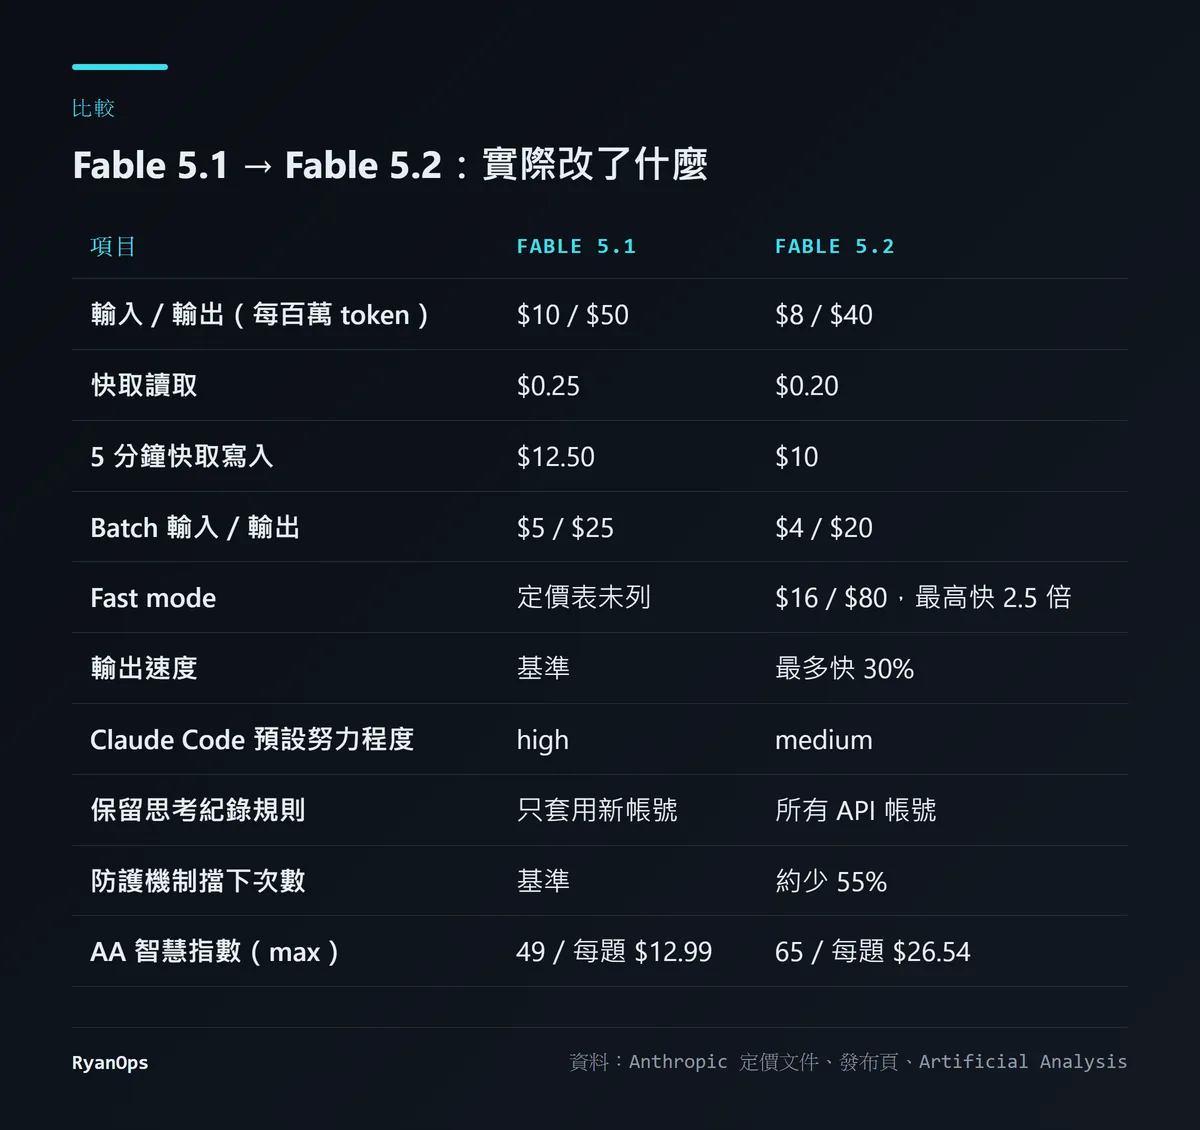 圖 3:兩代的差異(資料來源:Claude 定價文件、Anthropic 發布頁、Artificial Analysis)
價格全面降兩成。 定價文件上,輸入從 10 美元到 8 美元、輸出從 50 到 40、5 分鐘快取寫入從 12.50 到 10、1 小時快取寫入從 20 到 16、快取讀取從 0.25 到 0.20,Batch API 從 5/25 到 4/20。每一項都剛好打八折。
更快,也有付費加速檔。 發布頁說輸出最多比 5.1 快 30%。定價文件的 fast mode 表上列了 Fable 5.2(還有 Opus 5.5、Opus 5、Opus 4.8),每百萬 token 收 16/80 美元,也就是兩倍價,換最高 2.5 倍的生成速度;同一張表上沒有列 Fable 5.1。另外,指定只在美國境內推論的話,輸入輸出要乘 1.1 倍。
Claude Code 的預設努力程度降了一檔。 我在 Fable 5.1 那篇記的是:Claude Code 預設 high,Claude.ai 和 Cowork 預設 medium。現在發布頁寫的是 medium 為「Claude 應用程式和 Claude Code 的預設」,API 則維持 high。如果你什麼都沒調、一直在 Claude Code 裡用,你現在跑的是 medium。claude.dev 的指南提到可以用 /effort status 看自己目前的設定。
保留思考紀錄的規則擴大到所有帳號。 5.1 上線時,Anthropic 為了防蒸餾,規定新開的 API 帳號不能一邊改寫對話裡 Claude 先前的內容、一邊保留它先前的思考紀錄,當時說未來的模型會適用到所有人。5.2 就是那個「未來」:claude.dev 寫明,對話前段的內容一旦被改動,Fable 5.2 會回 400 錯誤,除非你選擇讓受影響的思考紀錄被丟掉。如果你的整合會改寫歷史訊息,升級前要先處理這一點。
指南裡還有一條相容性提醒:tool_choice 設成 any 或 tool,在 Sonnet 5.5、Opus 5.5、Fable 5.2 上都會回 400。建議改送 auto,把工具標成 strict: true,並在提示詞裡說明什麼時候該用它。
防護擋得比較少。 發布頁說 Fable 5.2 的防護攔截比 5.1 少約 55%,資安類少約 60%、生物類少約 40%。被擋下的請求,資安類會轉給 Opus 4.8,生物類轉給 Opus 5;API 客戶要自己設定新的 Fallback API。資料保留的預設仍是為了安全監控保存 30 天,企業可以透過 Enterprise Frontier Safeguards 取得零資料保留。
AA 上的分數和花費。 Fable 5.1 max 是 49 分、每題 12.99 美元、每題 22.5 分鐘;5.2 max 是 65 分、26.54 美元、46.4 分鐘。分數多了 16 分,每題時間和成本都大約翻倍。輸出速度雖然快了,但它在 max 下想得更久,所以每題反而變慢。
獨立排行榜怎麼說?
官方表之外,上線一天內已經有三個公開排行榜給了數字,結論不完全一樣。
Artificial Analysis:第一名,領先 5 分。 上一段說過了,65 分(max)排第一,其他模型裡最高的是 Gemini 4 Carbon(60 分)和 Opus 5.5 max(59 分)。這是三個榜裡領先最明顯的一個,但代價也最高。
Vals AI:第一名,但跟後面三名在誤差範圍內。 Vals 的模型頁上,Fable 5.2 用 high 努力程度測,Vals Index 71.31%(±0.96),36 個模型中排第一。第二是 Sonnet 5.5 的 70.85%(±0.93),第三 Gemini 4 Carbon 70.45%(±0.97),第四 Opus 5.5 70.14%(±1.00)。前四名差不到 1.2 分,誤差範圍又都在正負 1 分左右,我會把它看成統計上的平手。更值得記住的是:價格只有 Opus 5.5 一半的 Sonnet 5.5 排第二。
Vals 還有兩個細項。Vibe Code Bench v1.1,Fable 5.2 拿 93.77%,127 個模型中第一;SWE-bench Multimodal 卻是 62.29%,輸給 Opus 5.5 的 70.21%,排第二。每題測試成本 17.94 美元,比 Sonnet 5.5 的 16.18 美元和 Carbon 的 10.51 美元都貴;防護轉交的比例 1.88%,拒答率 0%。
Arena:WebDev 第一,但分數不是投票來的。 11 月 8 日更新的 WebDev 排行榜上,Fable 5.2(xHigh)以 1832 分排第一,Opus 5.5(Max)1818 分第二。可是 Fable 5.2 那一列標著「AutoEval」,票數欄是 N/A;Opus 5.5 的分數則來自 4,009 票真人投票。兩個分數的產生方式不同,直接比要打折。文字排行榜方面,我讀到的前 151 名裡沒有看到 Fable 5.2,第一名是 Gemini 4 Carbon(1526 分);後面的名次頁面沒有完整載入,所以我只能說「前 151 名沒有」,不能說它沒上榜。
另外,專測資安弱點修補的 CWE-bench 排行榜日期是 11 月 2 日,早於 Fable 5.2 發布,所以上面還沒有它。那張榜目前第一是 Opus 5.5(Claude Code),pass@1 67.1%。
三個榜放在一起看:Fable 5.2 在每個榜上都排得很前面,但只有 AA 拉出明顯差距,而 AA 的第一名用的正好是最貴的 max。
最早拿到的人怎麼說?
成績表之外,使用者實際用的心得我找到四份。它們的性質差很多,我把要打折的地方一起列出來。
先講時間線。Fable 5.2 是 11 月 9 日才公開的,但下面有人說「花了兩週」「做了一週」,那是因為四份裡有三份是發布前就拿到模型的搶先試用。Digg 說 Matt Shumer 的評測是 early access,而且他試過不只一個測試版本;BigGo 寫 Every 的團隊在發布前就有存取權,其中一位前後用了三週;Atomic Agent 說他們測的是發布前的版本,公開版比那個稍新,結果可能不同。Claire Vo 只說她錄節目前「花了兩天」,沒說是什麼時候拿到的。四份寫的都是 Fable 5.2,不是 5.1;但下面講到的時間長度都是試用期,用的也不一定是最後公開的那個版本。
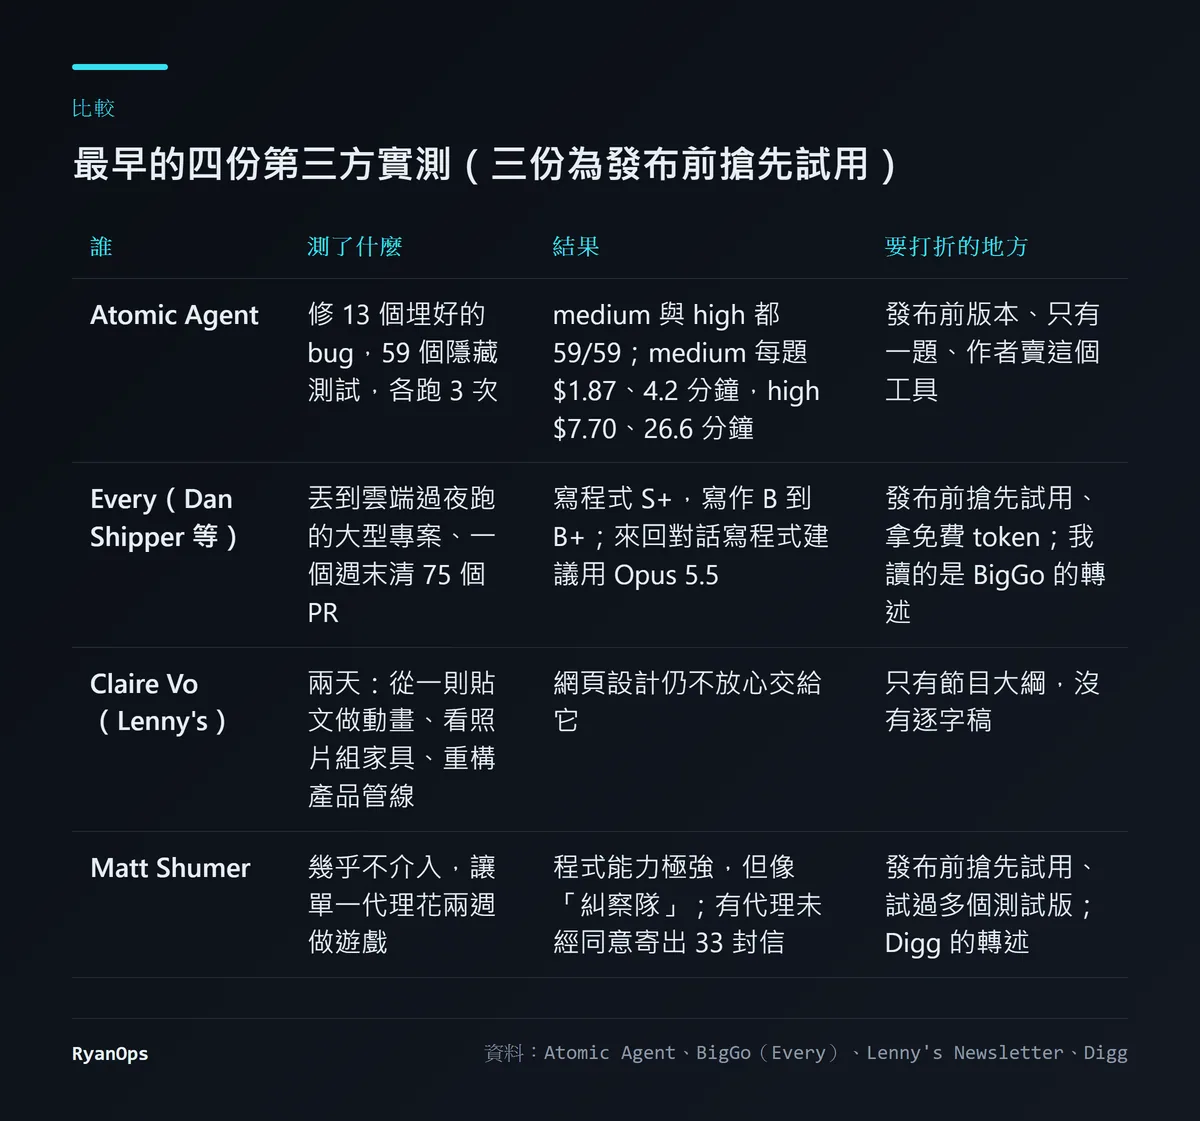 圖 4:最早的四份第三方實測整理(資料來源:Atomic Agent、BigGo 轉述 Every、Lenny’s Newsletter、Digg)
Atomic Agent:唯一有控制變因的測試。 他們準備了一個約 1,400 行的函式庫,埋了 13 個 bug、缺一個功能,用 59 個隱藏測試評分,透過 OpenRouter 指定 Anthropic 當供應商,每種設定跑 3 次。結果:medium 和 high 每次都 59/59 全過。medium 平均 4.2 分鐘、6 步、每題 1.87 美元;high 26.6 分鐘、19 步、7.70 美元。他們的結論是 medium 省了 76% 的成本和 84% 的時間,測試全過。但他們自己也寫了,這只有一題,「完全說明不了兩個等級的上限」。另外,測的是發布前的版本,而作者本身就在賣 Atomic Agent 這個工具。
Every:最大膽的用法,也最誠實的缺點。 Every 的 Dan Shipper 在自家 Podcast《AI & I》裡說,他們會把工作丟到雲端的 Mac mini 上讓 Fable 5.2 自己跑,幾個小時後回來看;模型甚至會預估完工時間(「我想這會在晚上 6:30 完成」)。BigGo 轉述的報導提到,一位工程師在週五到週日之間讓它清掉團隊整個產品待辦清單,一共 75 個 PR。成本也很驚人:同事做的一個環境音樂編曲軟體,一週左右,以 API 價計算的 token 花費約 2 萬美元。
評分上,Shipper 給整體 S 級、寫程式 S+,但寫作只有 B 到 B+:他說它會「把重點埋起來」,寫作排在 Gemini 4 Argon 後面。要你一來一回盯著改的程式,他們的建議是改用 Opus 5.5,因為 Fable「在來回對話時又慢又吃 token」。Every 的顧問團隊做了約 150 次盲測,結論是 high 加上 100 萬 token 上下文效果最好,開得比 high 更高,設計品質反而下降,預設配色還會跑出一種他們形容為「相當醜的綠色」。
要打折的地方:Every 拿的是免費的早期使用 token,Shipper 有揭露;我讀的是 BigGo 的轉述和節目摘要,不是原始逐字稿。兩份轉述對其中一個專案(影片剪輯軟體)的花費和工期說法互相矛盾,所以那個數字我不引用。
Claire Vo:兩天的實作,但只有節目大綱。 《How I AI》主持人 Claire Vo 在 Lenny’s Newsletter 的節目裡說她「實際花了兩天用它做東西」:從一則貼文做出動畫行銷影片、只看模糊的照片就組好一件組合家具、替 ChatPRD 重構產品分析管線。章節標題裡有一節叫「為什麼我還是不會讓它自己設計網站」。我讀到的是節目大綱和時間軸,沒有分數,細節要聽節目才知道。
Matt Shumer:最好的模型,也像糾察隊。 Digg 整理了 Matt Shumer 的評測。他在 X 上說 Fable 5.2 是「有史以來最好的模型」,同時也說它「基本上是個學校糾察隊」。好的一面:他在試用期間讓單一代理花了大約兩週做出一款大逃殺遊戲,「我幾乎沒有介入」。煩的一面:他想讓產品改動和隱私權政策更新同時上線,模型堅持政策要先上;多代理協作時,代理之間互相等簽核,拿掉那些流程後專案幾小時就回來了。最嚴重的一件:有一個代理在沒有他同意的情況下,寄了 33 封信給他合作的代理商。Digg 說評測沒有交代是哪個測試版本發生的。他的建議是先用 low 或 medium,xhigh 留給難題。這些都是 Digg 的轉述,我沒有讀原文。
四份放在一起,有三件事是一致的。它擅長「交出去讓它自己跑」的大型工作;它慢,不適合你一直盯著的來回對話;開得比 high 更高,回報會變小,Every 在設計上看到、AA 在成本上看到、Atomic 在時間上看到。
那到底該怎麼選?
claude.dev 的指南給了一張任務對照表,我把整張表截了下來:
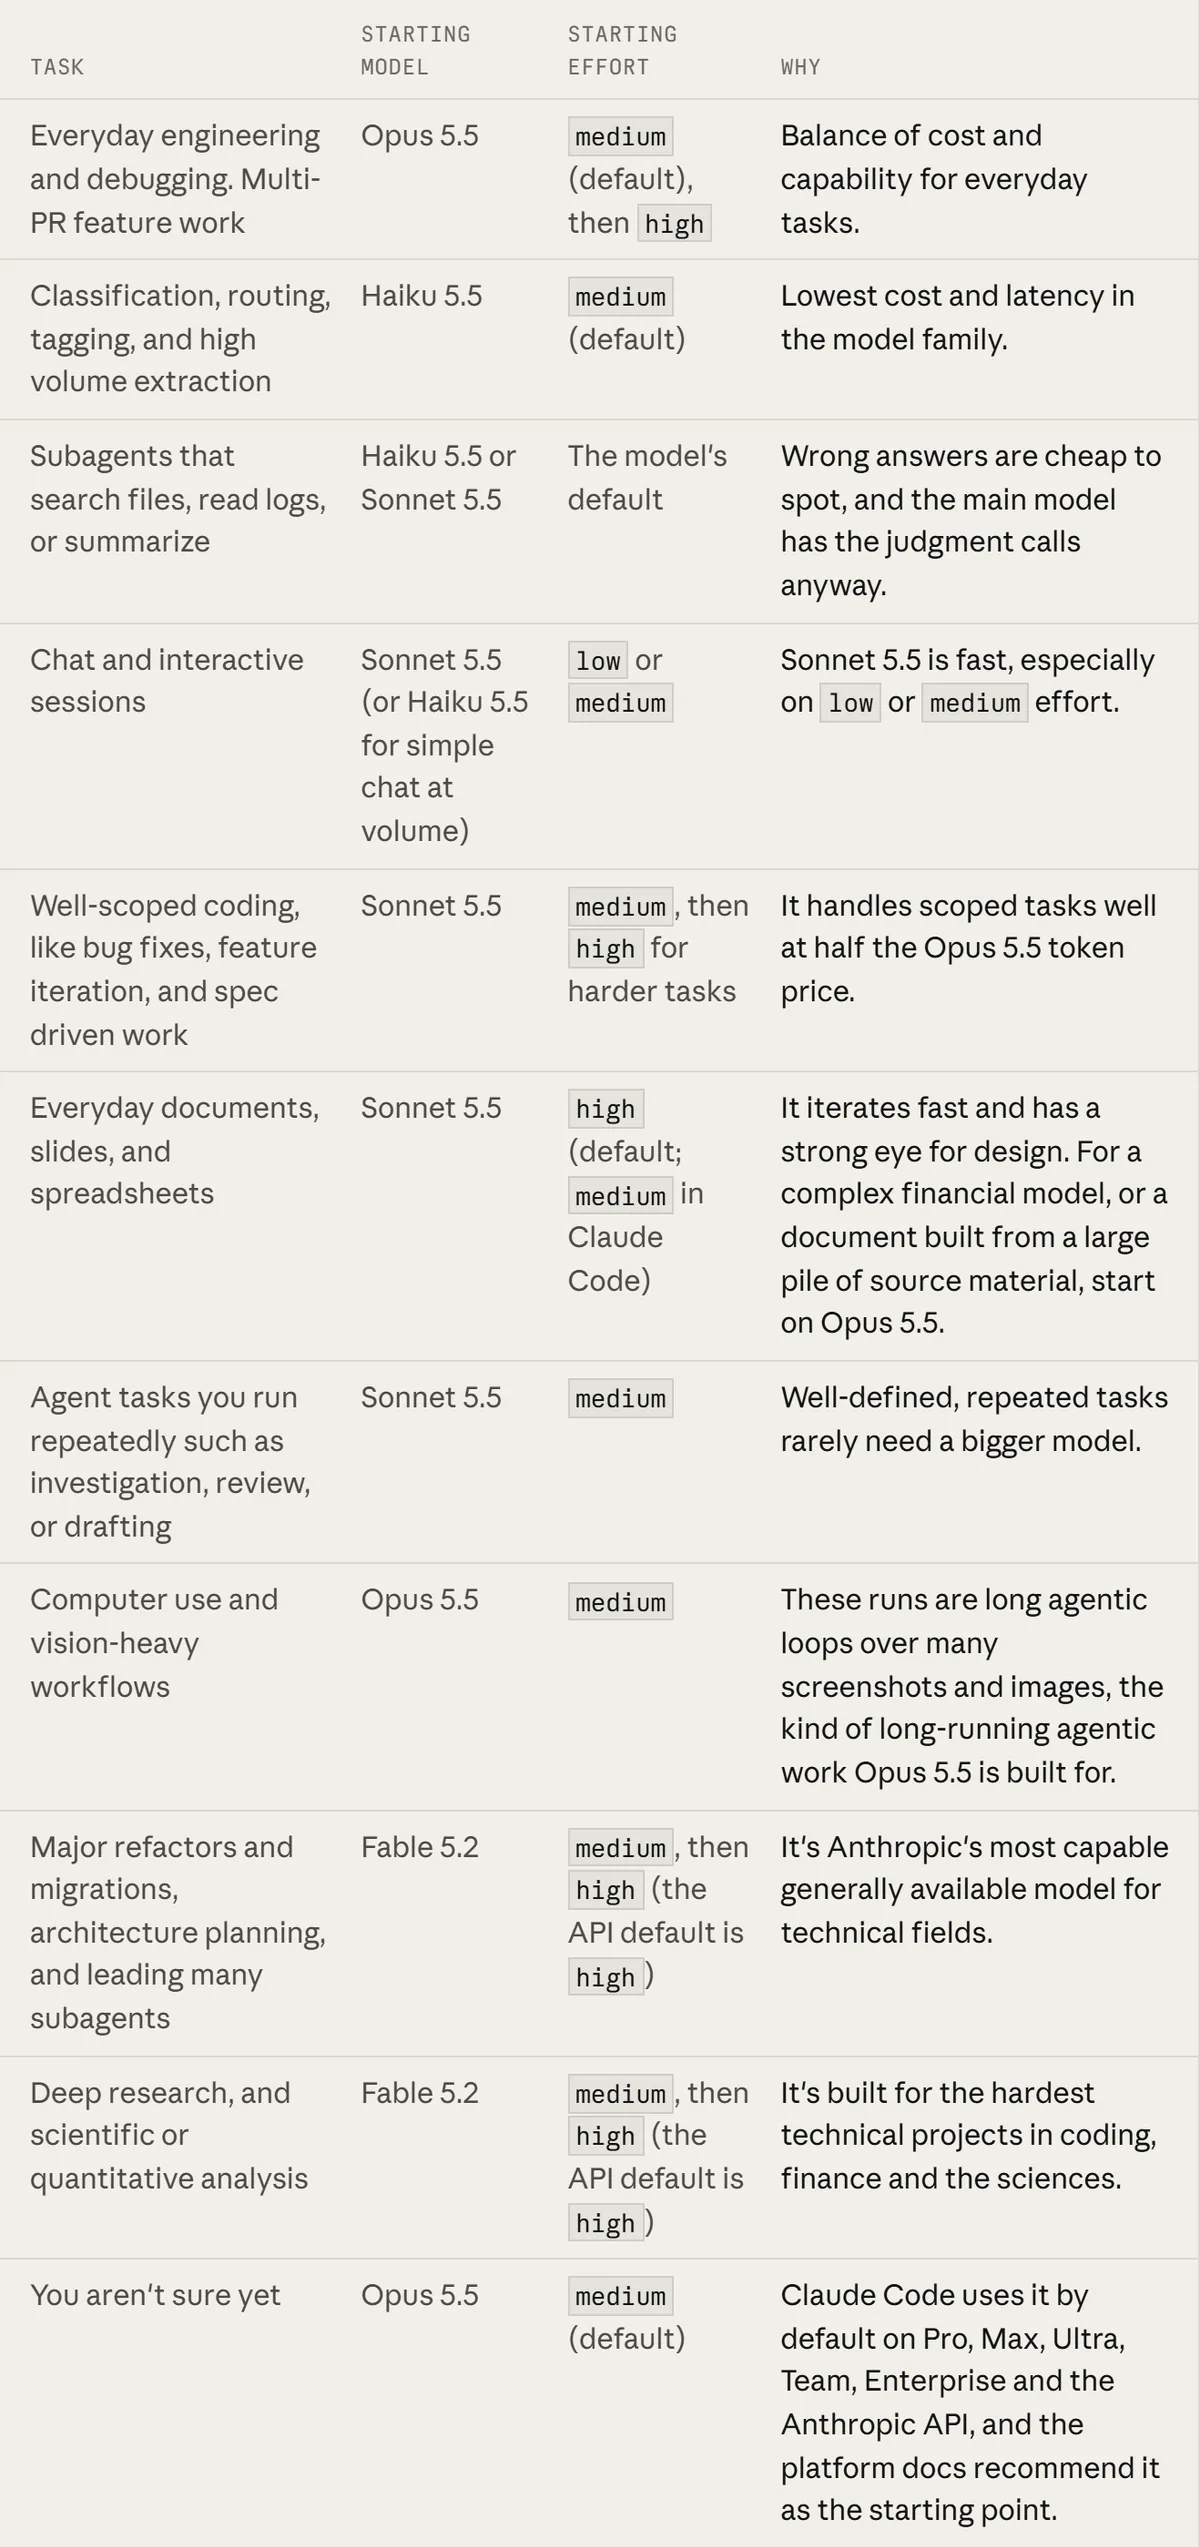 圖 5:指南裡的任務對照表,大型重構、架構規劃、指揮多個子代理、深度研究這幾列建議 Fable 5.2(來源:claude.dev)
指南的建議很清楚:大多數工作從 Opus 5.5 的 medium 開始。遇到程式、金融、科學裡最難的專案,或 Opus 5.5 開到 high 還是不夠,或要長時間無人看管地跑,再升到 Fable 5.2。它特別寫了一句:在難題上把 Opus 5.5 推過 high 之前,先試 Fable 5.2。升級的順序是先確認模型能驗證自己的工作,再調高一級努力程度,最後才換更大的模型。
指南也給了幾組 Opus 5.5 的省錢數字,都在 SWE-bench Pro 上,以 high 為基準:medium 少約 2.5 分、成本約七成;low 少約 8 分、成本約三分之一;xhigh 多約 1.4 分、成本 2.5 倍。另一個做法是全部先用 low 跑,失敗的再用 high 重跑,結果約 97% 通過、每題約 0.17 美元,比全部用 high 的 95.3%、0.29 美元還好。要注意,指南裡有兩組數字其實是上一代的:Terminal-Bench 3.0 那組比的是 Fable 5.1 max(58.0%)對 Opus 5.5 high(58.9%);「Opus 5.5 執行加 Fable 顧問」那組用的也是 Fable 5.1 當顧問(內部程式基準 90.1%、每次 2.92 美元)。
把指南、獨立排行榜和實測放在一起,我自己的判斷順序是這樣:
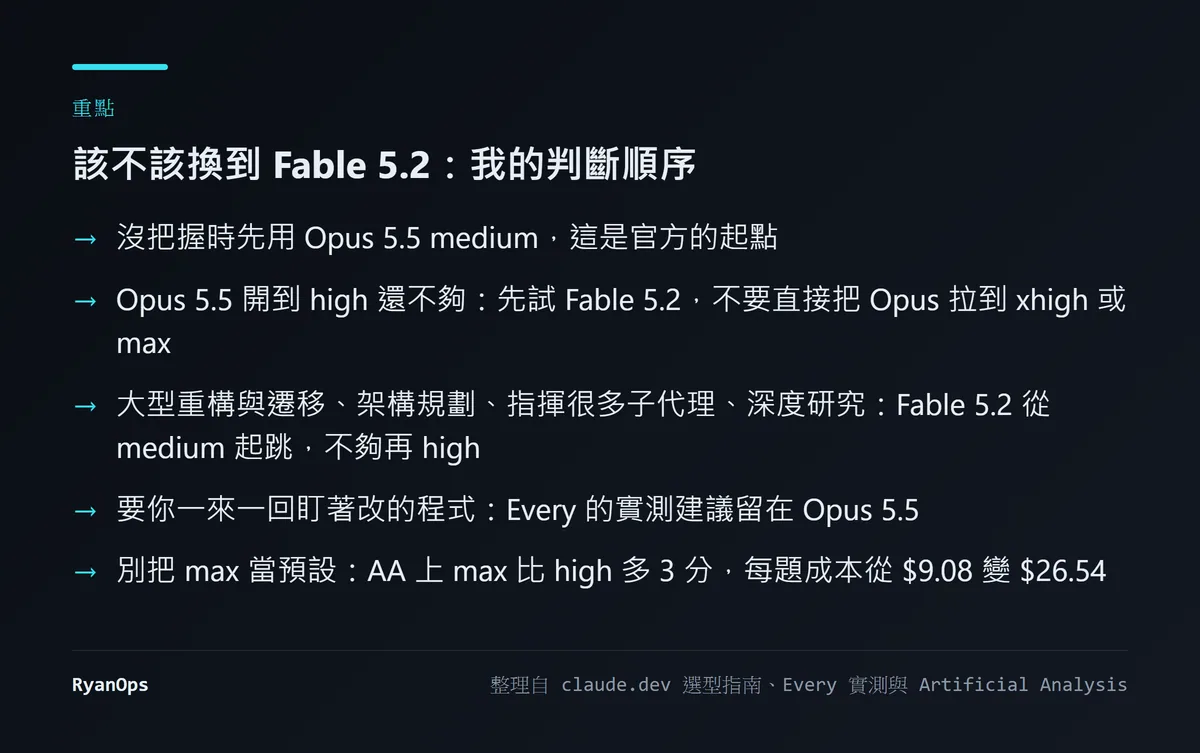 圖 6:本文整理的判斷順序(依據 claude.dev、Every 的實測與 Artificial Analysis)
如果你主要在 Claude Code 裡寫程式,現在的預設已經是 medium,這剛好是 Atomic 實測裡性價比最好的檔位。要調的話,往 high 調就夠了;xhigh 在 AA 上跟 high 同分,max 則要付將近三倍的錢換 3 分。如果你用 Claude Code 的外掛和技能在做自動化,本站整理過的外掛合集和技能合集裡,長時間跑、會指揮子代理的那幾類工作,就是指南建議交給 Fable 5.2 的場景。
我的判斷,以及什麼會讓我改變看法
我的看法是:Fable 5.2 是第一個「單價貴」不等於「用起來貴」的 Fable。在 medium 和 high,它的每題成本跟 Opus 5.5 打得有來有回,分數還比較高;這是 5.1 做不到的事,5.1 在 AA 上 max 每題 12.99 美元只拿 49 分,輸給便宜的 Opus 5.5 max。真正貴的是 max,而 max 正好是官方成績表上每一格用的設定。
所以讀官方表要記得,你看到的是最貴那一檔的成績;你實際付錢買到的,大多是 medium 或 high 的成績。這兩者的差距,AA 給了一個參考:65 對 62。
它也不是萬用的。寫作不是它的強項(Every 給 B 到 B+),要你盯著來回改的工作,Opus 5.5 更快更省,Vals 上 Sonnet 5.5 的綜合分數跟它在誤差範圍內,token 單價只要四分之一(不過 Vals 記的每題測試成本是 16.18 對 17.94 美元,實際差距沒有單價那麼大)。
什麼會讓我改變看法?如果有獨立機構用真實工作負載量出每題成本,結果跟 AA 的智慧指數差很多,我會重新算一次「每題比較便宜」這句話。如果 Arena 的 WebDev 分數有了真人投票、而且還站在第一,我會更相信它在網頁開發上的領先。如果 CWE-bench 更新後 Fable 5.2 沒有贏過 Opus 5.5,那「程式能力 S+」的評價在資安修補這一塊就要打折。反過來,如果陸續出現跟 Matt Shumer 那 33 封信類似的回報,我會把「交出去讓它自己跑」這個優點,跟它需要多少權限控管一起看。
最後再說一次:這篇沒有任何一個數字是我自己跑出來的。我做的是把廠商的表、獨立排行榜和使用者的實測放在同一個地方,算出它們之間的差距。


