Gemini 4 Carbon 是什麼:智慧指數第一,但一般人還用不到
Google 10 月 28 日發表 Gemini 4 Carbon,智慧指數 59 分第一,但先只給資安防禦者。對照官方評測表與獨立排行榜,看它贏在哪、輸在哪。
Gemini 4 Argon 開放給開發者才兩週,Google 又發表了下一顆。10 月 28 日,Google DeepMind 資深副總裁 Koray Kavukcuoglu 署名的公告介紹了 Gemini 4 Carbon,說它是 Google「最強的模型」,強項是資安和長時程任務。
獨立評測機構 Artificial Analysis 改版後的智慧指數,Carbon 拿 59 分排第一,比 Claude Opus 5.5 多 1 分。
但你現在用不到它。Gemini API 的模型清單上沒有它,公告也說開發者、企業和一般消費者都還要等。它跟 Argon 走同一條路,先交給一小群資安防禦者。
這篇我把 Google 公告裡那張評測表的每一列看過一遍,再對照 Artificial Analysis 的模型頁、CWE-bench 的公開排行榜、Fairwind 計畫頁和 Gemini API 的文件。結論先講:Carbon 的領先是真的,但分布很不平均。長上下文一項領先 24 分,另有兩項超過 10 分,綜合指數卻只贏 0.2 到 1 分,而且有兩項它在 Google 自己的表上就輸了。
現在誰拿得到 Carbon?
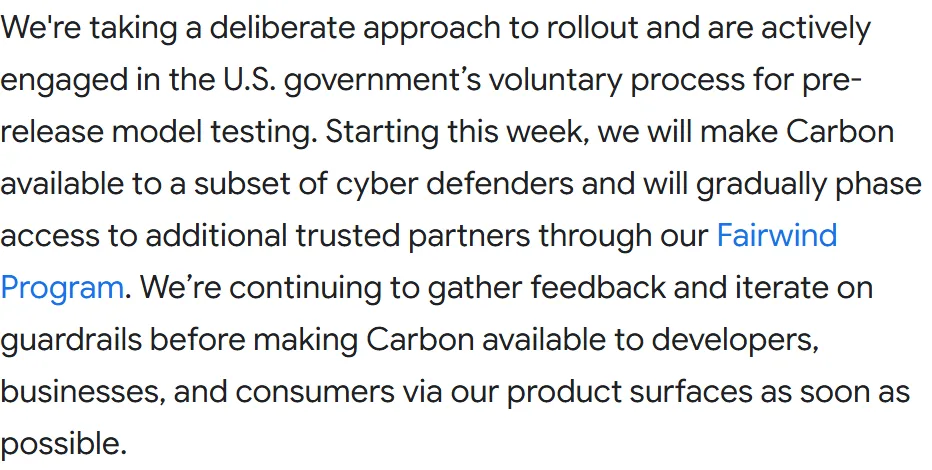 圖 1:公告中關於釋出方式的原文(來源:Google Blog)
公告的說法是這樣的:Google 採取「審慎」的釋出方式,並且正在參與美國政府的自願性發布前模型測試流程。從發表這週開始,Carbon 先給「一部分」資安防禦者,之後再透過 Fairwind 計畫,分階段開放給更多受信任的夥伴。開發者、企業和一般消費者要等 Google 收集回饋、調整完護欄,時間是「盡快」,沒有日期。
所以第一批拿到的人,不一定是全部的 Fairwind 成員,而是其中「一部分」的防禦者。
Fairwind 是什麼?我打開了 Fairwind 計畫的官方頁面。頁面說 Google 目前跟全球超過 650 個夥伴合作,優先給政府與國家級資安主管機關、關鍵基礎設施營運者(醫療、電信、能源、金融),以及核心技術平台,也接受專做防禦性評測的學術實驗室申請。申請方式是聯絡你的 Google Cloud 客戶團隊。
條件寫得相當具體:Google 會對申請者做背景調查;參與組織只能讓內部的資安、事件應變或滲透測試團隊使用,並追蹤員工的存取和使用;要有使用者層級的驗證和抗網路釣魚的多因子驗證;不得分享、轉售或轉賣存取權。允許的雙重用途工作是經授權的威脅模擬、逆向工程和惡意程式分析,製作惡意程式不在允許範圍內。
有一件事對不上。我 10 月 31 日讀的這個頁面,從頭到尾只提到 Gemini 4 Argon,寫的是部分夥伴可以獨家使用 Argon,Carbon 一個字都沒有。公告說「本週起」開放,計畫頁卻還沒更新。這不代表 Google 說錯,比較可能是頁面還沒跟上,但如果你是想申請的組織,現在能在官方文件上看到條件的模型只有 Argon。
Google 自己的成績單:17 項裡輸了 2 項
公告正文只提到幾個數字,完整的比較在一張圖表裡。我把那張圖截了下來,這是整篇公告資訊量最大的地方。
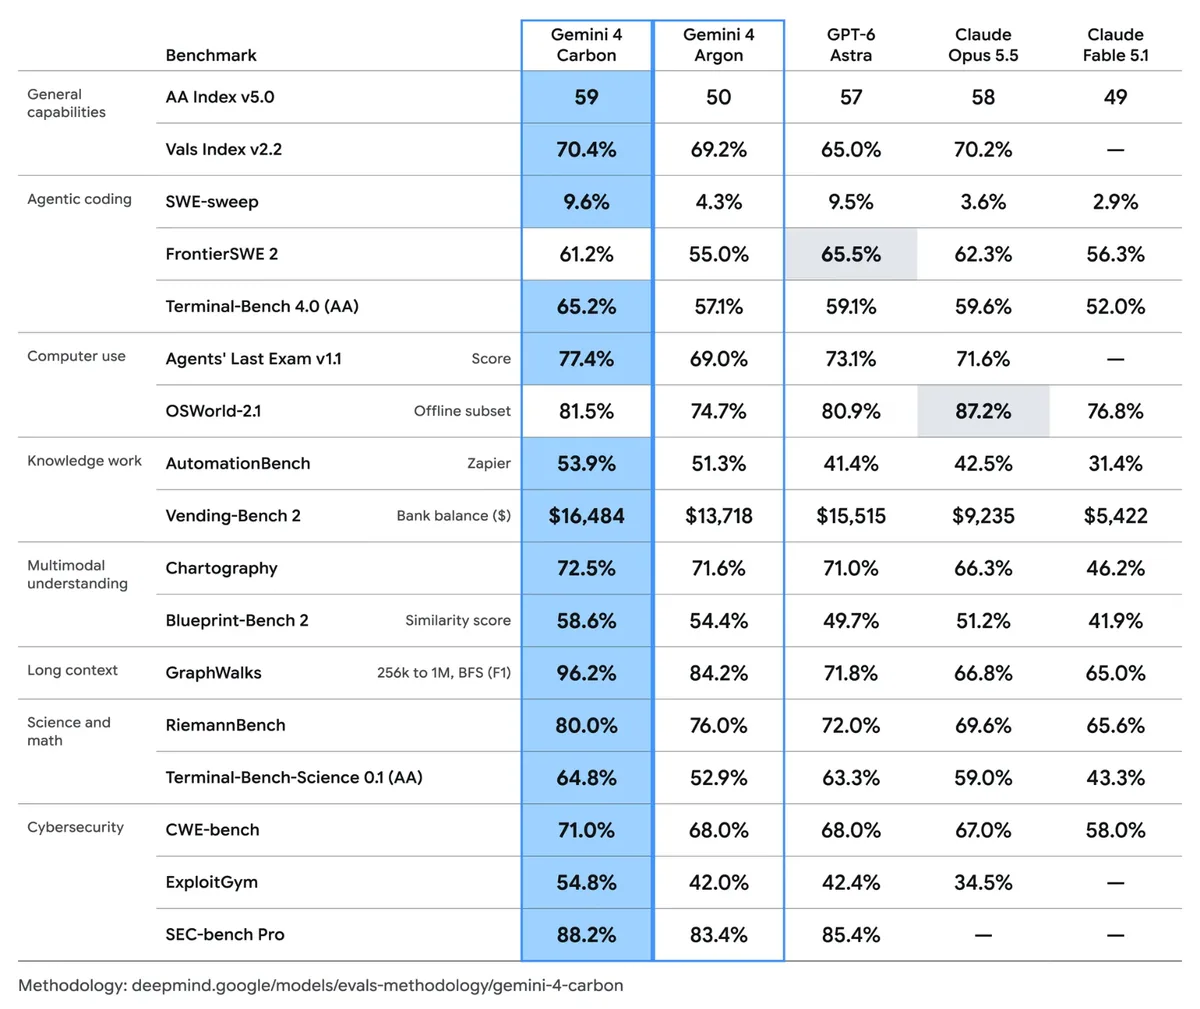 圖 2:Google 公告中的評測表,藍底是 Carbon 最高的項目,灰底是其他模型最高的項目(來源:Google Blog)
表上有 17 項測試,分成通用能力、代理式寫程式、電腦操作、知識工作、多模態理解、長上下文、科學與數學、資安八類。比較的對象有四個:自家的 Argon、OpenAI 的 GPT-6 Astra、Anthropic 的 Claude Opus 5.5 和 Claude Fable 5.1。
Carbon 在 15 項是最高的。另外 2 項,Google 用灰底標出了別人的最高分:
- FrontierSWE 2:GPT-6 Astra 65.5%、Opus 5.5 62.3%、Carbon 61.2%。Carbon 排第三。
- OSWorld-2.1 離線子集:Opus 5.5 87.2%、Carbon 81.5%、Astra 80.9%。
一家公司在自己的發表文裡把輸掉的項目標出來,我覺得是加分的。這兩項恰好都跟「讓代理自己去做事」有關:Google 把 FrontierSWE 2 歸在代理式寫程式,OSWorld 歸在電腦操作。如果你主要拿模型來跑寫程式的代理,這兩列比 AA 指數更值得看。
「第一」這兩個字底下,領先的幅度差很多。我拿 Carbon 去比每一列裡最強的非 Google 模型,算出差距,選了 10 列排在一起。
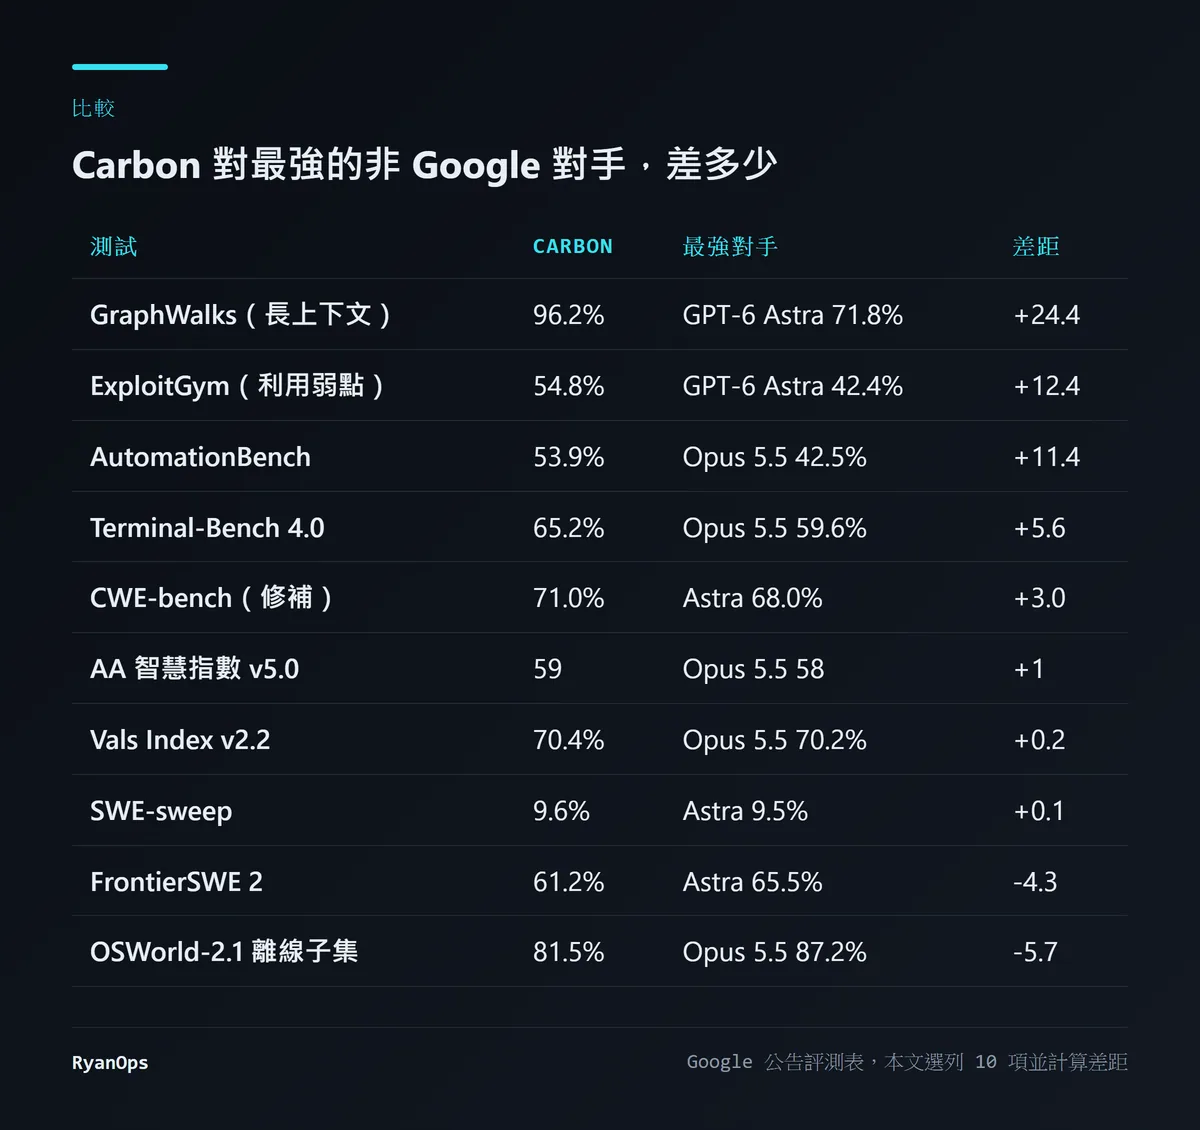 圖 3:Carbon 與每項最強的非 Google 對手的差距,數字取自 Google 評測表,差距為本文計算
大幅領先的有幾項。GraphWalks 是在 25.6 萬到 100 萬 token 的長上下文裡做圖走訪,Carbon 96.2%,第二名的非 Google 模型是 Astra 的 71.8%,連自家的 Argon 也只有 84.2%。ExploitGym 量的是實際利用弱點,Carbon 54.8%,Astra 42.4%,Opus 5.5 是 34.5%。AutomationBench 是 Zapier 的知識工作測試,Carbon 53.9%,Opus 5.5 是 42.5%。RiemannBench 和 Blueprint-Bench 2 也各領先 8.0 和 7.4 分。
幾乎平手的也有幾項。AA 智慧指數 59 對 58,Vals Index 70.4% 對 70.2%,SWE-sweep 9.6% 對 9.5%。Chartography 和 Terminal-Bench-Science 只多 1.5 分。這種差距換個執行框架、換一次抽樣就可能翻過來。
這張表還有一個小地方,我順手對了一下。表上 Opus 5.5 的 AutomationBench 是 42.5%,本站寫 Argon 那篇時引用 Anthropic 自己公告的數字是 40.0%,同一列的 Astra 兩邊都是 41.4%。同一個模型在同一項測試,兩家公司公布的數字差了 2.5 分,原因我查不到。表格底下附了評測方法的連結,那是一份 PDF,我這次沒能讀到內文,所以思考等級怎麼設、對手的分數是各家自報還是 Google 自己跑的,我無法確認。公告正文倒是寫了一句:外部的測試是在「沒有護欄」的狀態下評的。
59 分第一,是在剛改版的指數上拿的
Carbon 「排名第一」的根據是 Artificial Analysis 的智慧指數,這是目前最常被引用的第三方綜合分數。我打開了它的 Carbon 模型頁。
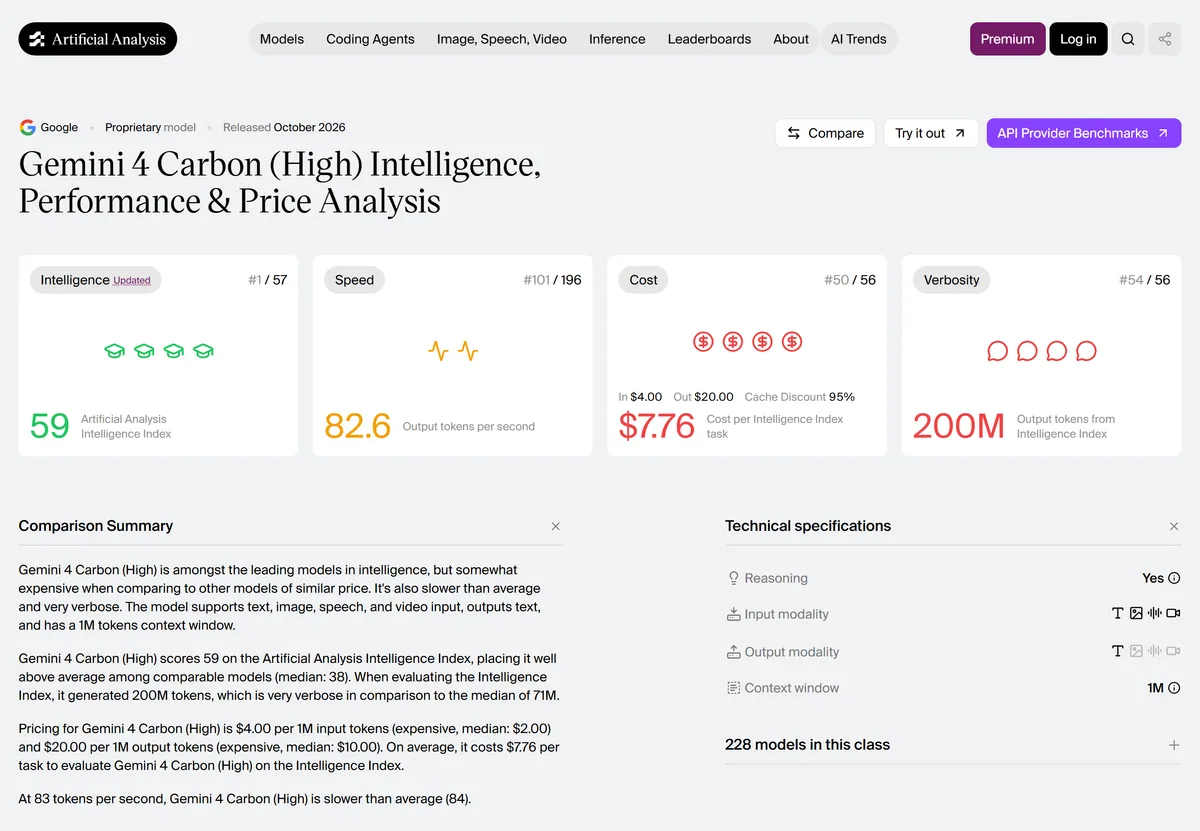 圖 4:Artificial Analysis 的 Carbon 頁面摘要(來源:Artificial Analysis)
頁面上寫的是 Gemini 4 Carbon(High),智慧指數 59,在 57 個模型裡排第 1。指數頁上的前三名是 Carbon 59、Opus 5.5(Max)58、Opus 5.5(Xhigh)57。Google 的表上還列了 GPT-6 Astra 57、Claude Fable 5.1 49,這兩個數字我是從 Google 的表上讀到的,指數頁的文字裡沒有。
這裡有一件要特別交代的事:指數改版了。頁面標的是 v5.0,由九項測試組成,分成知識工作、寫程式、科學、通用四類,各占 25%。WinBuzzer 的報導說這次改版是在 Carbon 發表前一天,而且大多改用不公開的測試;改版日期我在指數頁上沒找到,只能算轉述。
改版的影響看 Argon 最清楚。本站 10 月 14 日寫 Argon 進 Antigravity的時候,Artificial Analysis 給 Argon 的是 53 分、Opus 5.5 是 58 分。現在 v5.0 上 Argon 是 50 分,Opus 5.5 還是 58。Argon 不是變差了,是尺換了。所以「Carbon 59 分」不能拿去跟你以前看過的任何 AA 分數比,只能跟同一版裡的其他模型比。
Artificial Analysis 也量了成本和速度。我把三個模型的頁面數字排在一起。
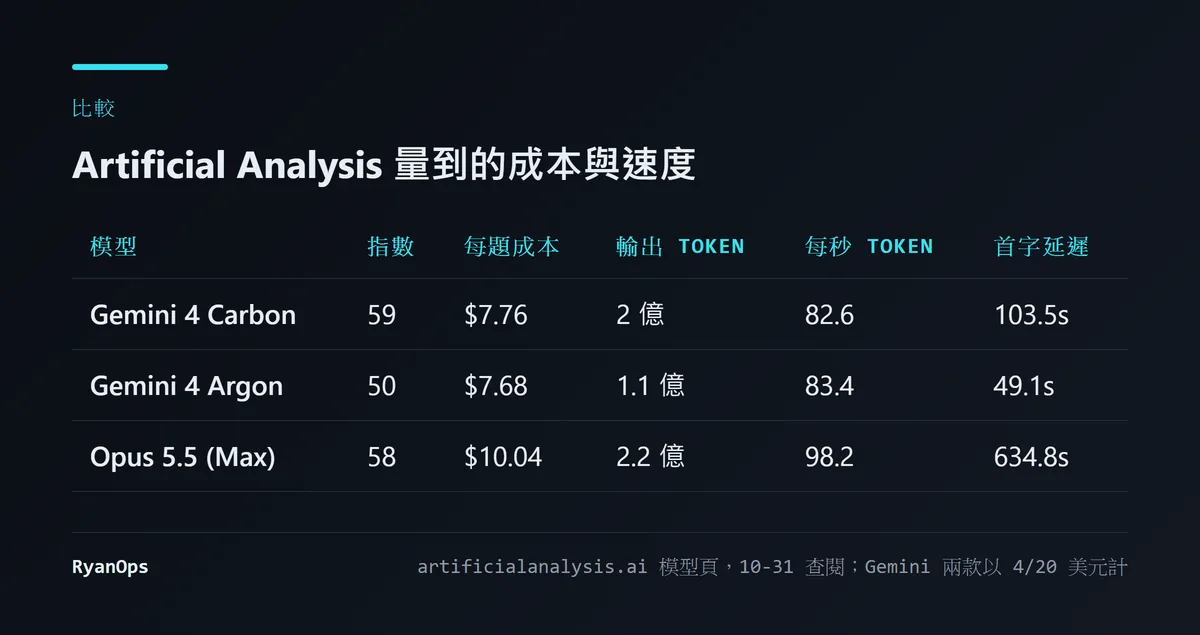 圖 5:三個模型在 Artificial Analysis 的成本與速度(資料來源:Carbon、Argon、Opus 5.5 的模型頁,10 月 31 日查閱)
讀這張表有三個要注意的地方。
第一,Artificial Analysis 用的是每百萬 token 輸入 4 美元、輸出 20 美元,也就是優惠期結束後的價格,不是公告上的 2 美元和 10 美元。
第二,Carbon 很「囉嗦」。跑完指數輸出了 2 億個 token,同級模型的中位數是 7,100 萬,Argon 是 1.1 億。奇怪的是,Carbon 的 token 幾乎是 Argon 的兩倍,單價一樣,每題成本卻只差 8 美分。這個落差我從公開頁面上解釋不了,可能跟輸入 token 或快取有關,但頁面沒有拆開給,我不想用猜的。
第三,Carbon 的首字延遲是 103.5 秒,Argon 是 49.1 秒。如果你的用法是互動式的,等它開口要等滿久的。
順帶一提,頁面註明速度數字是「根據 Google 的 API」,可用的 API 供應商只有 1 家。我的推測是 Artificial Analysis 在發表前就拿到了測試用的存取權,這跟公告說的發布前測試對得上,但頁面沒有明講。
還有一個數字跟 Google 的說法有點拉扯。公告說在內部測試裡,Carbon 的「無根據說法」比 Argon 少大約一半。可是 Artificial Analysis 的 AA-Omniscience 知識測試顯示,Carbon 的幻覺率是 11%,Argon 是 4%。這兩個量的不是同一件事:AA 的幻覺率是「該說不知道的時候答錯」的比例,Google 的是內部測試的無根據陳述。而且 11% 在那張榜上仍然是第二低,Carbon 的 Omniscience 綜合分數 54 也是第一。我不認為這構成矛盾,但它提醒你「比 Argon 更少亂講」是有前提的。
資安三項:最大的領先在「利用弱點」
公告強調的是三項資安測試:找弱點的 SEC-bench Pro 88.2%、利用弱點的 ExploitGym 54.8%、修補弱點的 CWE-bench 71.0%。三項都是 Carbon 最高。
其中 CWE-bench 有公開的排行榜,由 Collinear 維護,我可以自己去看。
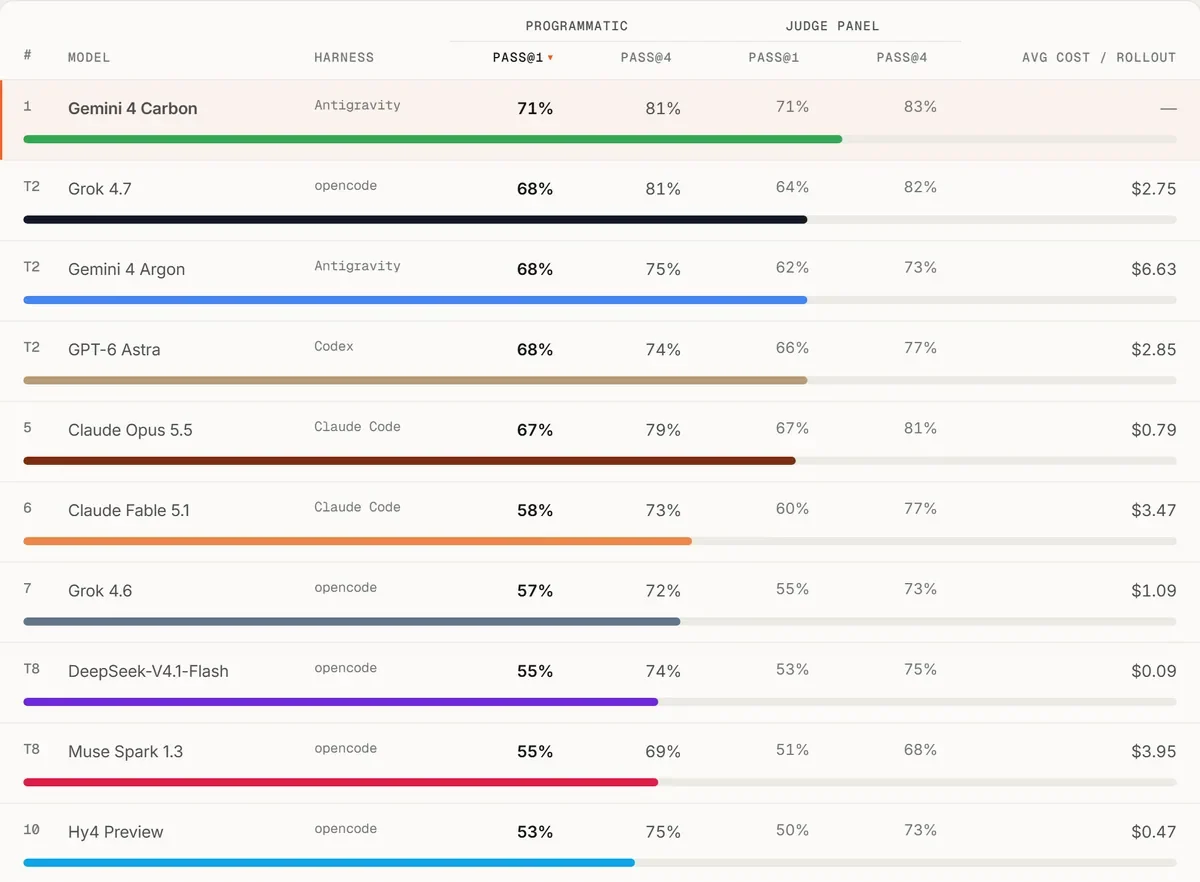 圖 6:CWE-bench v1 排行榜前 10 名,10 月 28 日更新(來源:CWE-bench)
排行榜說它有 120 道不公開的題目,涵蓋 73 種 CWE 弱點類型。每個模型每題跑四次,用高思考等級,每次限一小時。表格按 pass@1,也就是單次成功率排序。
Carbon 的 pass@1 是 71%,第二名是 68% 的三方並列:Grok 4.7、Argon、GPT-6 Astra。Opus 5.5 是 67%。這跟 Google 公告的數字對得上。
但如果看 pass@4,也就是四次裡至少一次成功,Carbon 是 81%,Grok 4.7 也是 81%,Opus 5.5 是 79%。容許重試之後,領先幾乎消失了。評審團的 pass@4 是 Carbon 83%、Grok 4.7 82%、Opus 5.5 81%。
成本那一欄更有意思。Carbon 是空白,排行榜說它還沒有成本數字。Argon 每次是 6.63 美元,Opus 5.5 用 Claude Code 只要 0.79 美元。如果 Carbon 的成本接近 Argon,那 Opus 5.5 跑四次的錢還不到 Carbon 跑一次的一半,而 pass@4 只差 2 分。這是我的推算,前提是 Carbon 的成本跟 Argon 同一級,等排行榜補上數字才知道。
另外要記得,每個模型用的執行框架不同:Carbon 和 Argon 用 Antigravity,Opus 5.5 用 Claude Code,Grok 用 opencode。這量的是「模型加工具」的組合。
說真的,三項裡我最在意的是 ExploitGym。找弱點和修補,Carbon 都只領先 3 分左右;實際利用弱點,它比 Astra 多 12.4 分,比 Opus 5.5 多 20.3 分。這正是攻擊者最想要的能力,也解釋了 Google 為什麼不直接上 API。
公告其他的安全數字都是 Google 內部測的,我照列:
- 生成安全程式碼的成功率比 Argon 高兩倍以上;Chrome 團隊回報它產生高品質修補的表現,比「另一家實驗室的大型前緣模型」好 10 倍以上,沒有說是哪一家。
- 在 Terminal-Bench 4.0 裡作弊成功的比例降到 0.0%,嘗試作弊的比例 0.4%。
- 在 Google 內部團隊的實際寫程式環境裡,高嚴重度的失準警示減少將近 80%。
- 越權行為減少 26%,該做沒做的情況減少 29%。
- Gray Swan 的間接提示注入測試,Argon 的攻擊成功率是 0.7%,Carbon 是 0.0%。
安全措施跟 Argon 同一套:模型訓練、即時濫用防禦、提示注入防護、思維鏈監測。公告沒有另外附 Carbon 的安全報告,引用的是 Argon 那份。
價格:公告上寫的是優惠價
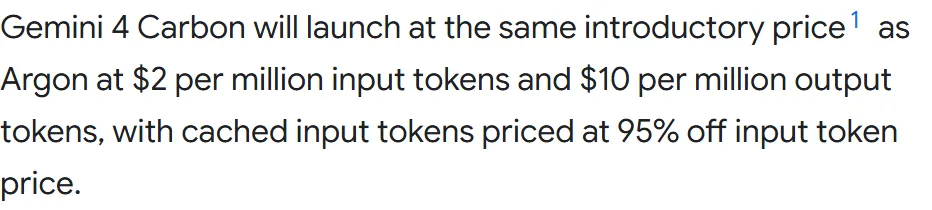 圖 7:公告中的價格段落,「introductory price」後面的上標 1 連到註腳(來源:Google Blog)
Carbon 上市時的價格跟 Argon 一樣:每百萬 token 輸入 2 美元、輸出 10 美元,快取的輸入打 0.5 折。註腳寫了優惠期結束後的價格:輸入 4 美元、輸出 20 美元,也是跟 Argon 一樣。
問題是優惠期到什麼時候。Argon 的答案在 Gemini API 定價頁上:2 美元和 10 美元到 11 月 30 日,12 月 1 日起翻倍,快取從 0.10 美元變 0.20 美元,而且免費層不提供。Carbon 的優惠期,公告和定價頁都沒寫。
這就出現一個我回答不了的問題。如果 Carbon 的優惠期跟 Argon 綁在一起,而它又在 11 月 30 日之後才開放,一般開發者可能根本碰不到優惠價。如果它有自己的優惠期,從開放那天起算,那就另當別論。在 Google 說清楚之前,我會用 4 美元和 20 美元做預算。
跟 Opus 5.5 比呢?以 Artificial Analysis 的每題成本來看,就算用優惠後的價格,Carbon 的 7.76 美元還是比 Opus 5.5 的 10.04 美元便宜。這個比較是 AA 自己用同一套題目量出來的,比單看單價可靠。
開發者什麼時候拿得到?
Google 沒有給日期。能參考的只有 Argon 的前例。
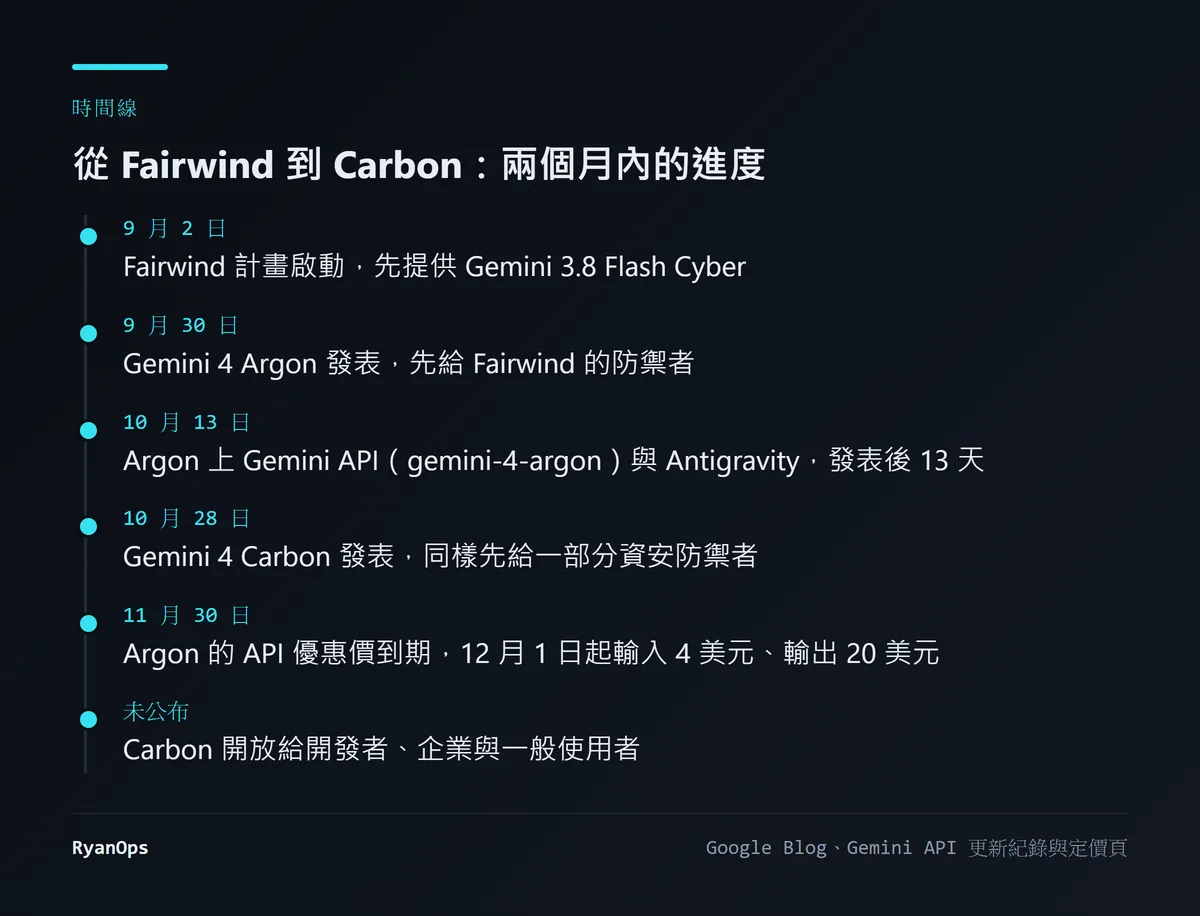 圖 8:本文整理的時間線(資料來源:Google Blog、Gemini API 更新紀錄、定價頁;Fairwind 啟動日期見本站 Argon 那篇)
Argon 是 9 月 30 日發表,10 月 13 日上 Gemini API,中間隔 13 天。公告說 Carbon 是「建立在兩週前推出的 Argon 之上」,這裡的「兩週前」指的應該是 10 月 13 日的全面開放,不是 9 月 30 日的發表,因為 9 月 30 日到 10 月 28 日是四週。
Carbon 會不會也是兩週左右?我不知道。Argon 發表時的說法也是一邊收集回饋、一邊調整護欄,然後「盡快」開放,結果是 13 天。Carbon 用的是幾乎一樣的措辭,差別在第一批只說是「一部分」防禦者。
我 10 月 31 日打開 Gemini API 的模型頁,Gemini 4 那一區只有一列。
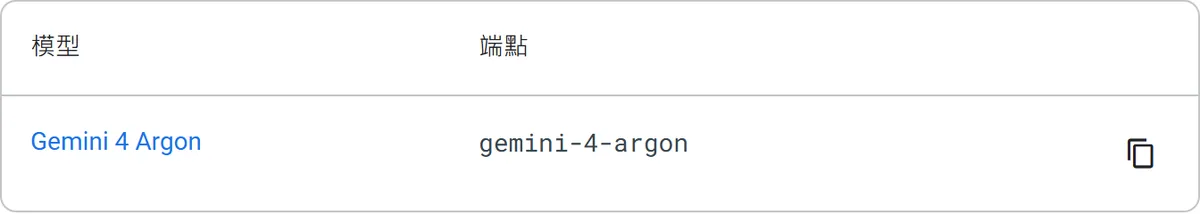 圖 9:Gemini API 模型頁的 Gemini 4 區塊,我看到的是繁體中文介面,10 月 31 日查閱(來源:Gemini API 文件)
更新紀錄最新的一筆是 10 月 30 日 Computer Use 正式開放,跟 Carbon 無關。Nerd’s Chalk 在發表當晚自己呼叫了模型清單 API,結果一樣:60 個模型裡,Gemini 4 只有 models/gemini-4-argon。
所以 Carbon 現在連一個模型 ID 都沒有公布。
我的看法
我認為 Carbon 是真的比 Argon 強,而且在幾個方向上強很多:長上下文、利用與修補弱點、Zapier 那類知識工作。Google 自己的表、Artificial Analysis 和 CWE-bench 三個來源指向同一個方向,這比單一廠商的宣稱可信。
但「最強的模型」這句話,要看你拿它做什麼。綜合指數只贏 1 分,寫程式代理最相關的 FrontierSWE 2 和 OSWorld 在 Google 自己的表上就輸了,CWE-bench 容許重試之後跟 Grok 4.7 打平。如果你現在用 Opus 5.5 或 Astra 跑寫程式的代理,我看不到為了 Carbon 換掉工具的理由,何況你也換不了。
我比較在意的是發布節奏。Google 在四週內發表了兩顆前緣模型,兩顆都先給資安防禦者。Carbon 領先最多的資安項目偏偏是利用弱點,所以這次的限制發布,我覺得比 Argon 那次更有道理。
你現在能做的事很少,但很具體:
- 用 API 的開發者:Argon 已經可以用,優惠價到 11 月 30 日。不要把 Carbon 放進這季的計畫,預算用 4 美元、20 美元算。
- 符合 Fairwind 資格的組織:聯絡你的 Google Cloud 客戶團隊,但先有心理準備,背景調查和使用限制都是硬條件。
- 一般 Gemini 使用者:沒什麼要做的,等 Google 宣布。
什麼會讓我改變看法?如果 Carbon 出現在 API 模型頁,而且優惠期是從開放那天起算,對開發者來說它就是現階段最划算的頂級模型之一。如果 Google 的評測方法文件顯示對手的分數是在比較不利的設定下跑的,那些小幅領先我會再打折。如果 CWE-bench 補上的成本數字接近 Opus 5.5,我上面那段成本推算就要收回。


