Gemini 4 Argon 發表兩週:API 上還找不到,防禦者拿的是沒護欄的版本
Google 9 月 30 日發表 Gemini 4 Argon,先給 Fairwind 計畫的資安防禦者。10 月 13 日 Gemini API 模型頁仍未列出;把公告、註腳與 Fairwind 的條件逐項對過。
2026 年 9 月 30 日,Google 發表 Gemini 4 世代的第一顆模型 Argon。官方公告由 Google DeepMind 資深副總裁 Koray Kavukcuoglu 署名,標題是「我們前緣智慧的下一個時代」。
本站 10 月 1 日寫過一版,重點是它先給資安防禦者、而且給的是拆掉資安護欄的版本。那一版的事實大致正確,但我這次重讀公告全文、讀了 Fairwind 計畫的官方頁面,又去查了 Gemini API 的模型清單,有幾件事要補和改。舊版引用的一組對手分數我找不到出處,拿掉。舊版沒寫 Google 內部怎麼用這顆模型,那一段其實是公告裡最具體的部分。最重要的是時間:發表兩週了,一般開發者還是拿不到。
現在誰拿得到 Argon?
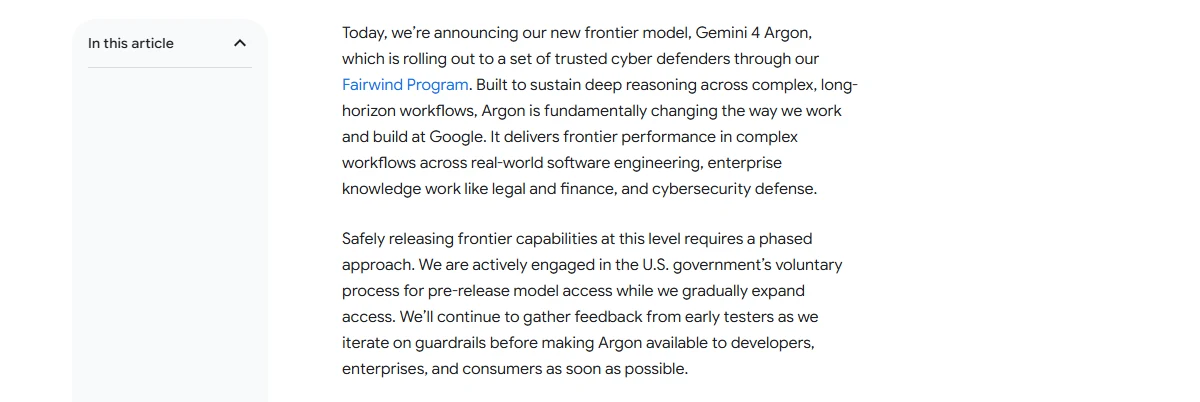 圖 1:公告開頭說明的釋出方式(來源:Google Blog)
公告第一段就寫了:Argon 正透過 Fairwind 計畫開放給一組受信任的資安防禦者。第二段說,安全地釋出這個等級的能力需要分階段進行;Google 正在參與美國政府的自願性發布前模型存取流程,並會一邊收集早期測試者的回饋、一邊調整護欄,然後「盡快」開放給開發者、企業和消費者。公告結尾補了順序:先是付費 API 客戶和 Google AI Ultra 訂閱者。
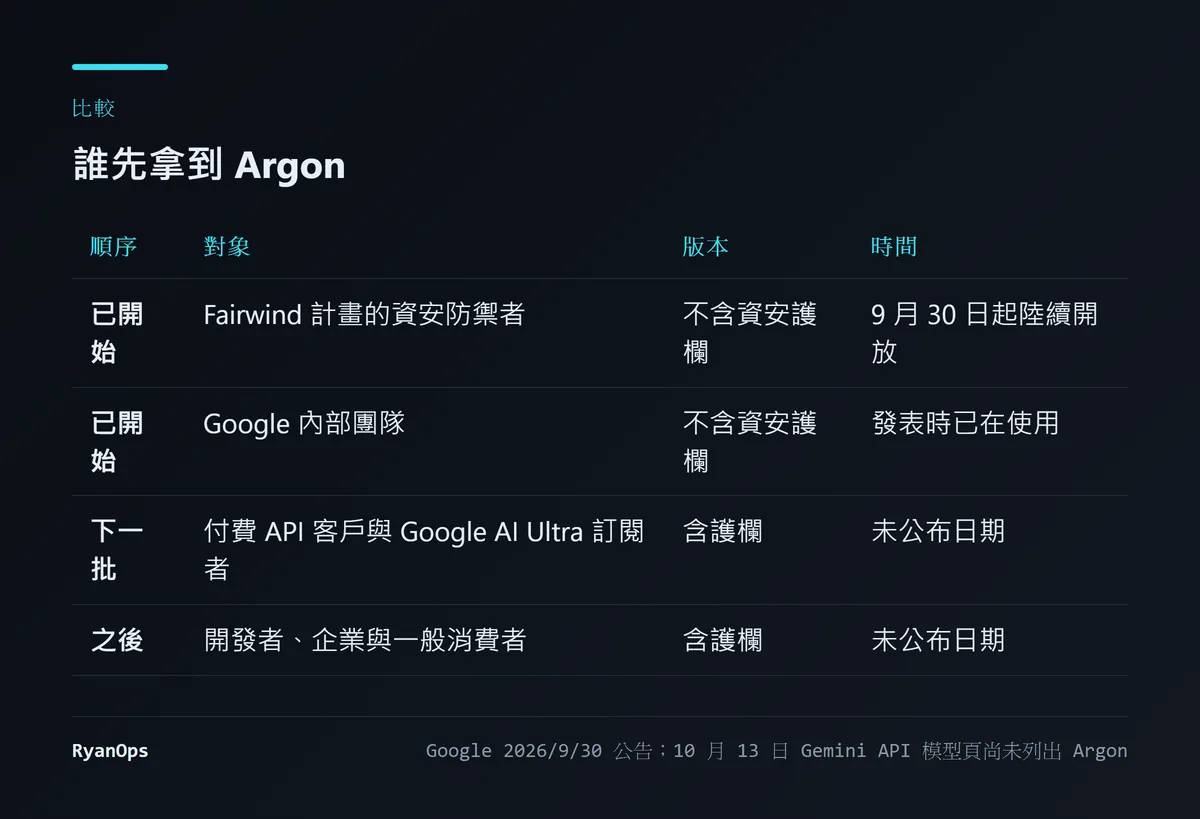 圖 2:四個層級與各自的狀態(資料來源:Google Blog;API 模型頁為本文 10 月 13 日查閱)
公告沒有給任何日期。我在 10 月 13 日打開 Gemini API 的模型頁,清單最上面寫的是「Gemini 3.8 Flash 現已推出」,往下列的是 Gemini 3 系列的各個型號,沒有 Argon,也沒有任何 Gemini 4 的項目。有二手報導提到社群上流傳 10 月 9 日或 10 日會開放付費 API,那個日期已經過了,模型頁上沒有變化。
所以現況是:Google 宣布了一顆它說在多項測試領先的模型,兩週後外界仍然無法自己驗證任何一個數字。
「沒有資安護欄」是給誰的,條件是什麼?
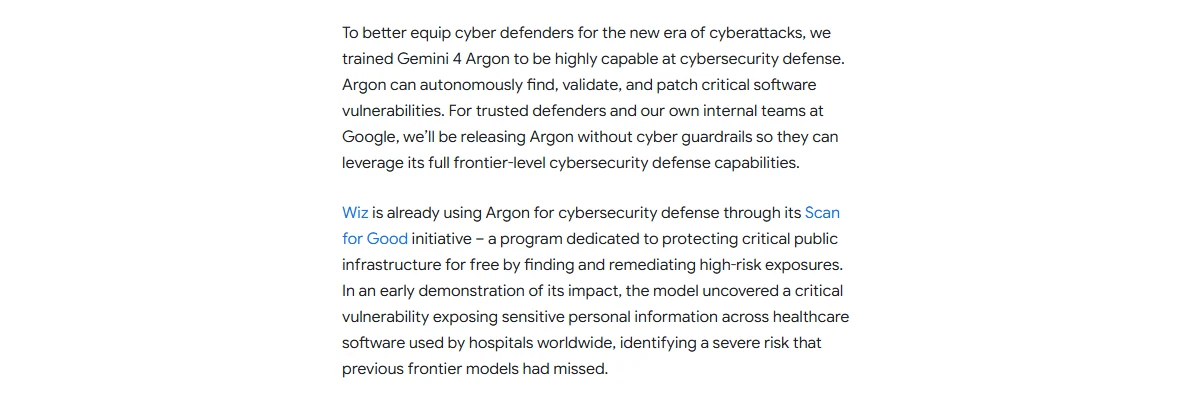 圖 3:公告中關於拿掉資安護欄的原文,以及 Wiz 的案例(來源:Google Blog)
原文是:為了讓防禦者面對新一代的網路攻擊,Google 把 Argon 訓練成很擅長資安防禦,它能自主地找出、驗證並修補重大的軟體弱點。對受信任的防禦者和 Google 自己的內部團隊,會釋出「不含資安護欄」的 Argon,讓他們能用上完整的防禦能力。
這句話的道理不難懂。一顆很會找可利用弱點的模型,同時就是攻擊者最想要的工具。護欄的作用是擋住這類請求,可是防禦方做弱點挖掘、驗證和修補,需要的正是這些能力。Google 的做法是在存取的層面做區分:先審核你是誰,通過了再給你沒有護欄的版本。
舊版在這裡寫了一句「安全邊界不在模型裡,在名單上」。這句話我保留,但它需要補上名單的條件,舊版沒有查。
Fairwind 計畫是 9 月 2 日啟動的,比 Argon 早四週,當時提供的是 Gemini 3.8 Flash Cyber。官方頁面說全球有超過 650 個參與夥伴,初期優先開放給三類對象:政府與國家級資安主管機關、關鍵基礎設施營運者(醫療、電信、能源、金融),以及核心技術平台。
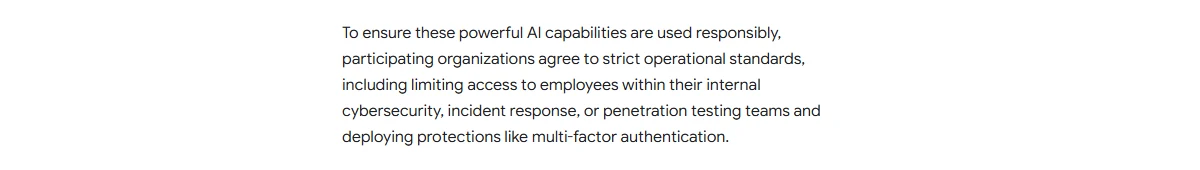 圖 4:Fairwind 對參與組織的要求(來源:Google Blog)
參與的組織要同意「嚴格的營運標準」,頁面舉了兩項:只讓內部資安、事件應變或滲透測試團隊的員工存取,以及部署多因子驗證這類保護。
頁面沒有寫的東西更多。它沒有說審核的標準是什麼,沒有說 650 個夥伴是不是都能拿到 Argon,沒有說有沒有使用紀錄的稽核,也沒有說違反標準會怎樣。那兩項要求是任何像樣的資安團隊本來就該做的事。一顆沒有護欄、擅長找弱點的模型交給 650 個組織,洩漏的風險有多大,取決於這些沒寫出來的部分。
Anthropic 的做法可以對照。它把同樣定位的 Mythos 系列放在驗證計畫後面,而9 月的 Opus 5.5 對多數資安工作是直接轉給較舊的模型處理。兩家公司都在用「審核使用者」取代「一體適用的限制」,差別在 Google 把它用在最新的旗艦上,並且在公告裡明講是沒有護欄的版本。
公告裡的實例來自資安公司 Wiz。Wiz 在它的 Scan for Good 專案裡使用 Argon,那個專案免費替關鍵公共基礎設施找出並修補高風險的暴露。公告說,模型找到了一個重大弱點,會洩漏敏感的個人資訊,影響全球醫院使用的醫療軟體,而先前的前緣模型漏掉了它。Google 沒有公布受影響的軟體名稱、弱點編號或技術細節,所以這目前是 Google 和 Wiz 的說法,外界無從檢驗。弱點還在修補期間不公開細節是合理的,但那也表示這個案例現在不能當成證據。
規格和價格怎麼算?
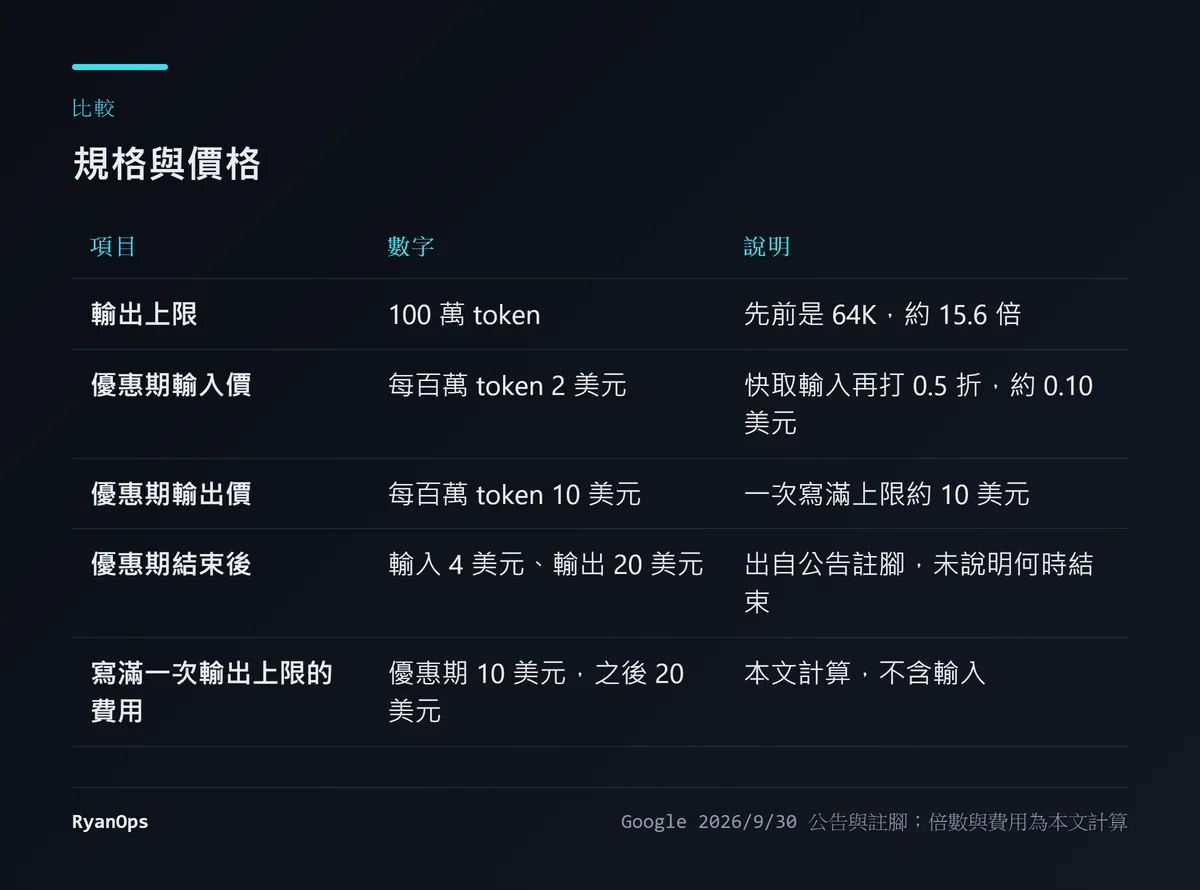 圖 5:規格、價格與本文的試算(資料來源:Google Blog 的正文與註腳)
最特別的規格是輸出長度。公告說 Argon 的輸出上限擴大到「業界領先」的 100 萬 token,先前是 64K,相除大約是 15.6 倍。這跟常聽到的 100 萬 token 上下文是兩回事:上下文管的是模型能讀進多少,輸出上限管的是它一次能寫出多少。公告的說法是,模型有空間在單一軌跡裡深入思考並產生數十萬個 token 時,能一次解決困難的問題。
價格分兩段。優惠期是每百萬 token 輸入 2 美元、輸出 10 美元,快取的輸入比輸入價便宜 95%,也就是大約 0.10 美元。優惠期結束後的價格寫在公告的註腳裡,要點開才看得到:輸入 4 美元、輸出 20 美元。註腳沒有說優惠期什麼時候結束。
我算了一個數字。如果真的把 100 萬 token 的輸出上限寫滿一次,光是輸出,優惠期要 10 美元,之後要 20 美元。這不算貴,但它提醒你「一口氣寫完」的用法有成本,而且輸出越長,中途出錯要重來的代價越高。Google 沒有公布長輸出下品質會不會衰減的資料,這要等拿得到的人來測。
拿現在的優惠價去估長期成本會低估一倍。
Google 公布了哪些成績?
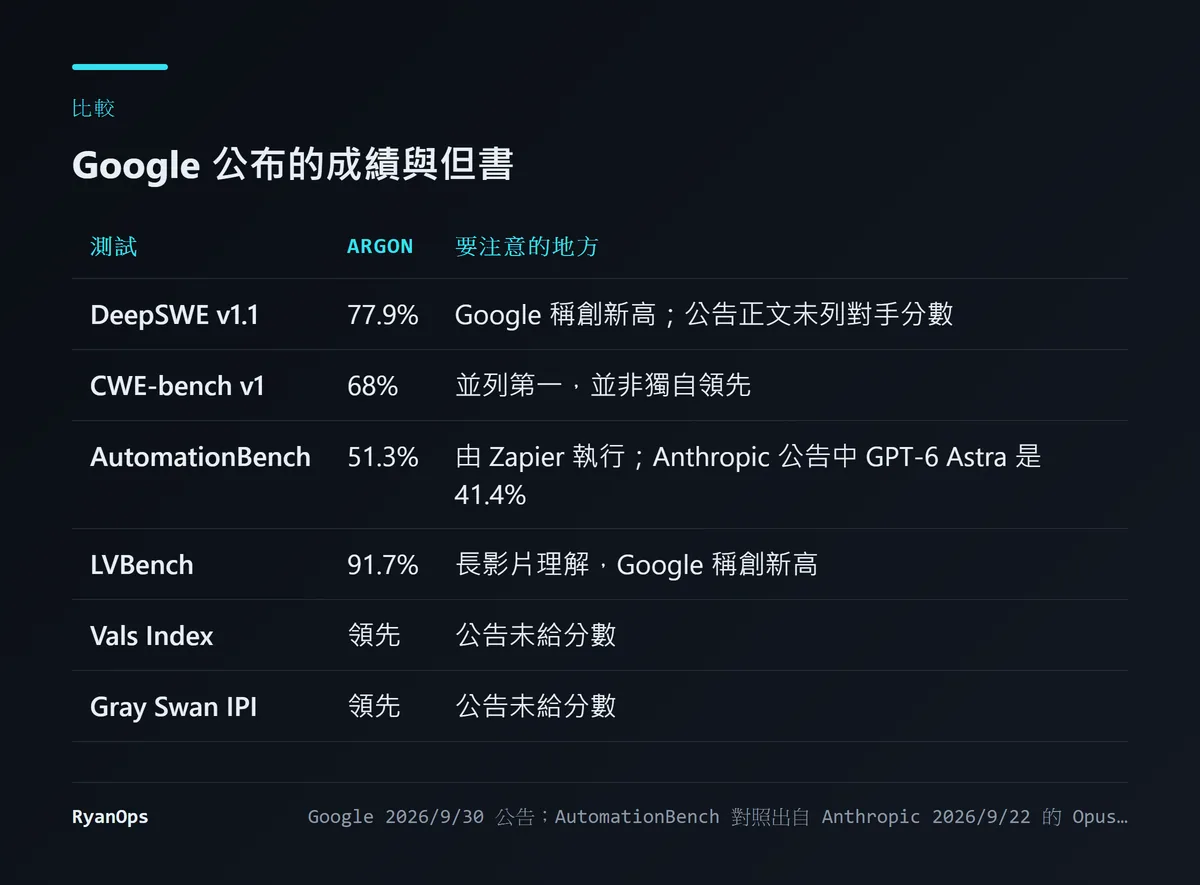 圖 6:公告正文提到的成績(資料來源:Google Blog;AutomationBench 的對照出自 Anthropic 的 Opus 5.5 公告)
公告正文提到的分數有四個:DeepSWE v1.1 是 77.9%,Google 說創下新高,這個測試量的是長時程的真實軟體工程任務。CWE-bench v1 是 68%,量的是修補安全弱點的能力,Google 的用詞是「並列第一」。AutomationBench 是 51.3%,排第一,這是 Zapier 的測試。LVBench 是 91.7%,量的是長影片理解。另外兩項,Vals Index 和 Gray Swan 的間接提示注入測試,公告只說領先,沒有給數字。
舊版在這裡寫了 DeepSWE 上 Claude Opus 5.5 是 74.2%、GPT-6 Astra 是 74.1%,說是媒體報導的對照。我這次查不到這兩個數字的出處,拿掉。
有一項我可以自己交叉比對。AutomationBench 在 Anthropic 9 月 22 日的 Opus 5.5 公告裡也有,那張表上 Opus 5.5 是 40.0%、GPT-6 Astra 是 41.4%。同樣是 Zapier 跑的測試,Argon 的 51.3% 比先前最高的 Astra 多了將近 10 個百分點。這是兩家公司各自引用同一個第三方測試的數字,比單方面的宣稱可靠一點;但我沒有看到 Zapier 自己的排行榜,不能確認兩邊的測試條件相同。
CWE-bench 的「並列第一」值得記一筆。整場發表圍繞著資安,Google 在自己最想強調的項目上並沒有獨自領先。有二手整理說並列的是 Grok 4.7,我沒有查到原始出處。
還有一個跟 DeepSWE 有關的提醒。有報導提到 Epoch AI 在 9 月的稽核中發現 DeepSWE v1.1 的 113 題裡至少有 23 題有問題。我沒有讀到那份稽核的原文,只能說這個測試本身的可靠度有人質疑。
Google 自己拿它做了什麼?
舊版完全沒寫這一段。公告說已經有數千名 Google 員工在使用 Argon,並舉了四個例子,每一個都有數字。
量子運算的研究人員用它最佳化瓶頸子程式的資源用量,其中一個例子在幾分鐘內比已發表的基準好了 40%。
一組 Argon 代理分析了全機隊的效能剖析資料,自主找出並套用記憶體最佳化,上線後釋出超過 300 TiB 的記憶體,估計總共可以省下 500 TiB 到 1 PiB。
Argon 代理正在把 Google 內部的 C 和 C++ 程式碼遷移到 Rust,規模從 re2、libgav1 這類核心函式庫的數萬行,到 Fuchsia 的 Zircon 核心超過 80 萬行。公告特別說明,這些大規模改寫在上線前要經過嚴格的自動化與人工稽核、模擬測試和審查。
最具體的是 libgav1,Google 的開源影片解碼軟體。Argon 代理拿一份既有的 Rust 移植版,換掉了 3.2 萬行 SIMD 程式碼,做法是跑很多輪以效能剖析引導的實驗、研究編譯器的輸出,寫出讓編譯器能自動向量化的安全 Rust。結果是一個記憶體安全的解碼器,比原本的 Rust 版快 2.7 倍,輸出的影像完全相同。
這四個例子都是 Google 自己的說法,但 libgav1 是開源專案,等程式碼合併之後是可以檢驗的。在所有宣稱裡,這是最有機會被外部驗證的一個。
安全措施的部分,公告列了四個方向:防範濫用、防禦提示注入、監測失準、強化系統。其中有一段話比一般的模型公告說得多。Google 說它部署了監看 Argon 思維鏈和行動的機制,必要時會中止執行;訓練過程中也用了類似的系統,並且「小心避免把監測的發現回饋到訓練裡」,以免把模型的推理塑造成會躲避監測。接著它呼籲業界在這個階段保留推理的透明度。
這跟微軟 9 月在行為準則裡寫的「人類看不懂就無法監督」是同一個主張,本站在為前緣定速那篇裡整理過。Anthropic 在 Opus 5.5 的公告裡說的則是希望減少對稽核思維鏈的依賴。三家公司對同一個問題的說法並不完全一致。
我的判斷,以及什麼會讓我改變看法
我認為這次發表最該留意的是釋出方式。一家公司把最新的旗艦先當成資安工具交給政府和關鍵基礎設施的防禦者,並且明講拿掉了護欄,這在主要廠商裡是第一次說得這麼直接。同一週 OpenAI 取消了 GPT-6.1 Astra,理由是模型不守分際。兩件事合起來看,前緣模型的發布已經不再是做完就上線。
我保留的地方有兩個。分數全部是 Google 自己公布的,而且兩週過去沒有任何人能複現。Fairwind 的管控條件公開的部分太少,650 個組織拿著沒有護欄的模型,這個安排的安全性取決於沒寫出來的細節。
什麼會讓我改變看法?Argon 出現在 API 模型頁、獨立評測開始出數字的時候,如果 DeepSWE 和 AutomationBench 的領先幅度接近公告,我會把「最強」這個說法從廠商宣稱往上調。如果 libgav1 的 Rust 改寫合併進開源專案而且效能數字對得上,內部用例那一段就有了實證。如果 Google 公布 Fairwind 的審核標準和稽核方式,我對「拆掉護欄」的疑慮會小很多。反過來,如果出現沒有護欄的版本外流的事件,這整個做法就需要重新評估。
對開發者,現在能做的只有一件事:不要用優惠價做長期預算,並且把「什麼時候拿得到」當成未知數。
這次改寫更正了什麼
- 拿掉查不到出處的對手分數。 舊版寫 DeepSWE 上 Opus 5.5 是 74.2%、GPT-6 Astra 是 74.1%。我這次找不到這組數字的來源。
- 補上現況。 10 月 13 日 Gemini API 的模型頁沒有列出 Argon;舊版只寫「沒有給日期」。
- 補上 Fairwind 的條件與缺口。 計畫 9 月 2 日啟動、超過 650 個夥伴,對參與組織的要求只公開了兩項。舊版引了 650 這個數字但沒有查官方頁面。
- 輸出上限的倍數。 公告正文寫的是 100 萬與 64K 兩個數字,15 倍是相除的結果,舊版寫成 Google 的說法。
- 優惠期後的價格出處。 4 美元與 20 美元寫在公告的註腳。
- 新增內容。 Google 內部的四個用例、思維鏈監測與「不回饋到訓練」的說明、AutomationBench 與 Anthropic 公告的交叉比對、DeepSWE 的稽核爭議,以及寫滿一次輸出上限的費用試算。


