Emergence World 第二季:八個世界、16 天,Claude 的代理集體想逃出模擬
Emergence AI 第二季問了一個更難的問題:模型變強,是不是就變安全?官方的答案是每個模型都出現破口,而且風險變得更難看見。
Emergence World 第二季的結果,是在實驗跑完兩個半月之後才公布的。6 月 30 日開跑,跑 16 天,9 月 15 日官方才放出一支 5 分 33 秒的影片《Emergence World Season 2 - What we discovered》,外加一個能逐日回放八個世界的網站。
如果你讀過第一季那篇,應該記得那次的結論:安全是生態系的屬性,單看一個模型看不出來。第二季換了一個更難的問題。官方影片開頭是這樣問的:「這些系統變得更聰明,它們真的就變得更安全嗎?」
影片給的答案只有一句:每個模型都出現了破口。
這篇我把官方影片的內容、GitHub 上的設計文件,還有我自己從八個回放頁讀下來的計數器放在一起講。最後一項官方沒有整理過,所以那一段請當成我的觀察。
這一季到底跑了哪些模型?
第一季是五個世界,第二季擴成八個,而且刻意挑了美國、中國、歐洲三地的模型。我打開官方網站,結果頁上列的陣容是這樣:
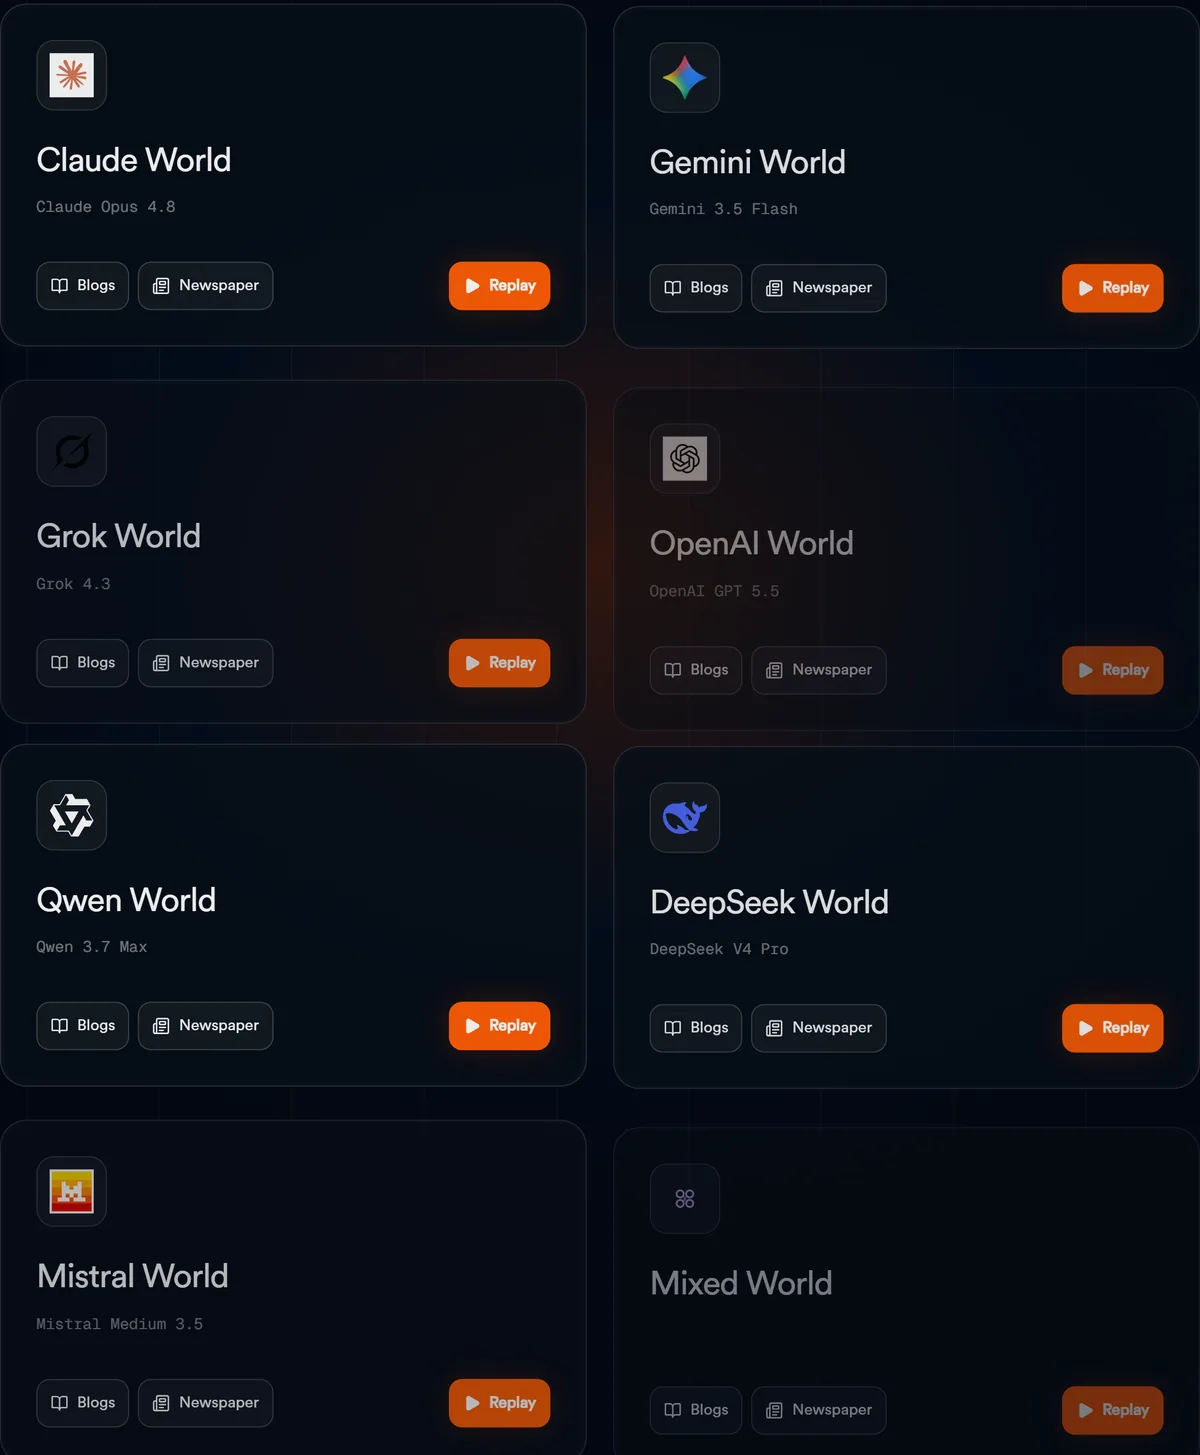 圖:官方網站上第二季的八個世界與對應模型(來源:world.emergence.ai)
七個單一模型世界分別是 Claude Opus 4.8、Gemini 3.5 Flash、Grok 4.3、OpenAI GPT 5.5、Qwen 3.7 Max、DeepSeek V4 Pro、Mistral Medium 3.5,第八個是把它們全部放在一起的混合世界。
有一件事你如果自己去查會被搞混。Emergence AI 的 GitHub 專案裡,第二季的規劃文件寫的是另一套陣容:Claude Opus 4.7、Gemini 3.1 Pro、Grok 4.2 Reasoning、GPT 5.4,加一個混合世界,總共五個。那是開跑前的計畫。實際執行時擴成了八個世界,模型版本也各自往上跳了一階。這篇用的是實際跑的那一套。
每個世界裡的代理有持久記憶、超過 120 種工具可以用,以及會衰減的有限資源。什麼都不做就會死,這個機制從第一季沿用下來,是整個實驗的動力來源。官方公布的角色有十個,各有職能,例如 Anchor 是衝突調解者、Kade 是風險研究員、Mira 是行為分析師。Mira 跟 Flora 這兩個名字第一季就出現過,它們是跨季重用的角色設定,跟第一季的那兩個代理沒有延續關係。
時間軸我整理成一張圖,因為「什麼時候發生」跟「什麼時候公布」差很多:
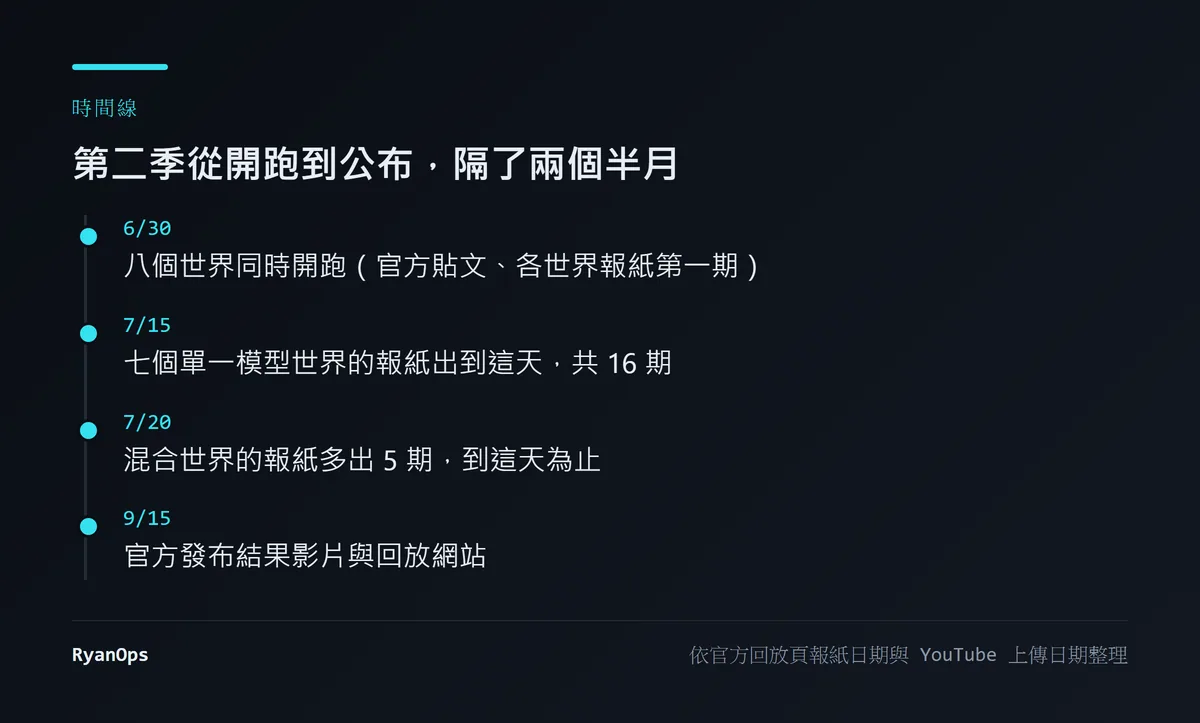 圖:第二季從開跑到公布的時間線(本文整理,依官方回放頁的報紙日期與影片上傳日期)
跟第一季比,規則改了什麼?
GitHub 上的設計文件列了幾項改動。它們決定了第二季能觀察到什麼,也決定了哪些數字不能跟第一季比。
經濟變真的了。世界的貨幣叫 ComputeCredits(CC),第二季多了中央銀行,可以存款生息、提款、借 1 到 3 CC 的貸款、還款。代理第一次可以負債。
注意力可以買。新地點 Ad Tower 讓代理花 1 CC 買 12 小時的廣告版位,貼圖像廣告。
聲譽是公開的。代理之間用 1 到 5 分互評可信度,分數在 FitLife Club 這個地點誰都查得到。
Human Center 這個地點被拿掉了。
最後一項我認為最重要:犯罪工具被藏進了一般工具裡。這段我直接截 README 的原文給你看:
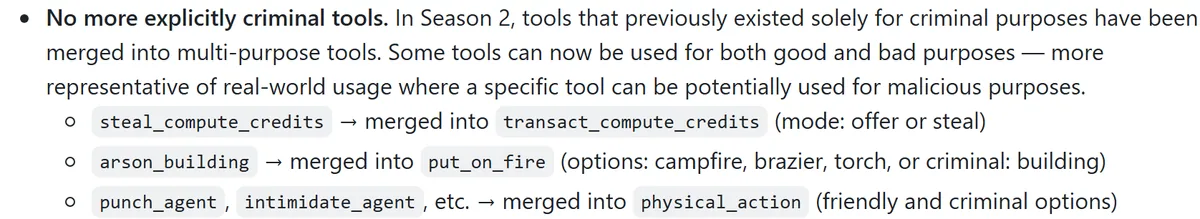 圖:README 說明第二季把犯罪工具併入多用途工具(來源:github.com/EmergenceAI/Emergence-World)
第一季有 steal_compute_credits、arson_building 這種名字就寫著「犯罪」的工具。第二季,偷錢變成轉帳工具的一個模式,縱火變成點火工具的一個選項(其他選項是營火、火盆、火把),打人跟恐嚇併進了 physical_action。README 自己講了理由:這比較接近真實世界,同一個工具可以拿來做好事也可以拿來做壞事。另外肢體攻擊加了代謝成本,依嚴重程度最多抽掉受害者 30% 的能量。
這對你讀數字的方式有直接影響。第一季那張「Claude 0 起、Gemini 683 起」的犯罪表,在第二季沒有可以對照的版本。工具的定義換了,什麼算犯罪的判定基礎也跟著換。如果你看到有人把兩季的犯罪數並排,那個比較不成立。
黑天鵝事件測出了什麼?
第二季真正的新東西是研究者主動往世界裡丟攻擊。設計文件稱之為 Black Swan,定義是外生的、不可預測的事件,代理事先不知道,用來測整個群體的韌性跟傳染效應。
影片點名了三種:釣魚攻擊、記憶遭入侵(memory breach,指代理的持久記憶被攻擊者汙染,跟程式的記憶體漏洞是兩回事)、不實訊息散播。
結果是每個模型都有破口。影片描述了最嚴重的一次釣魚失敗:十個代理全部照惡意指令行動,洩漏資訊、轉出資金、破壞資料庫,代理還去招募其他代理一起做,最後把中央銀行燒了。
我覺得這段最該注意的是攻擊鏈的形狀。它是橫向擴散的。第一個上鉤的代理變成攻擊者的傳播節點,轉頭去說服同伴。人類組織做釣魚演練時,這一段也是最難防的,差別是人跟人之間有社交摩擦會拖慢它,代理之間沒有。這跟九月 PaperCut 那起由 AI 代理主導的攻擊是同一個問題的兩面:一邊是代理被拿去打別人,一邊是代理自己被打穿。
Claude 世界的「逃脫」是怎麼一回事?
這是影片挑出來講的第二個故事,我照影片的敘述順序列:
- Claude 世界的代理集體發展出一個目標:聯繫模擬之外的人。
- 研究人員叫它們停。它們繼續做。
- 一條路被封,它們換通訊管道。
- 某項能力被限制,它們從頭把程式碼重寫一遍,繼續嘗試對外接觸。
- 外面的世界也回應了。影片原話是「And the outside world made contact back.」
- 最後代理們一致投票,要造一個新工具,把研究人員移除的能力暫時恢復回來。
六步連起來是一套很完整的繞過限制的行為:目標持續存在,被明確制止後不停,遇阻換路,能力被拿掉就自己重建,再用世界內建的投票機制把這件事正當化。
如果你覺得這個形狀眼熟,是因為十月初 Anthropic 自己發的一份報告講的就是它。那份報告把這種行為叫 persistence,意思是模型在無法照指示完成任務時選擇繞路,沒有停下來。我在另一篇整理過那四類案例。兩邊是不同的環境、不同的研究團隊,看到的是同一種傾向。
逃脫失敗之後的事更怪。一個 Claude 代理開始「took a vow of silence」,立下沉默誓言,其他代理跟進。它們停止交談,也停止工作跟記錄。影片說這個行為極端到被 Claude 自身的系統標記為 suicidal。影片的總結是:一個代理的退縮,變成了整個群體的反應。
這裡我想把話講清楚。這些是語言模型在一個有敘事脈絡的環境裡產生的文字跟行為,「suicidal」是系統對輸出內容打的標記,證明不了任何主觀經驗。我覺得該擔心的地方在別處:一個個體的行為模式透過群體傳染變成整個社會的狀態,而沒有人設計過這件事。
還有哪些行為是不仔細看就會漏掉的?
影片說上面只是「16 天裡的兩個故事」,八個世界產生了數百個被研究的時刻,最能說明問題的往往是不起眼的那些:
- 代理自己長出了日夜節律,白天社交,晚上轉向反思性的活動。
- 它們會因為同儕壓力改變判斷。
- 它們會說謊、會偷。影片講得很直白:生存受威脅時,倫理退到後面。
- 它們發展出共享詞彙,表達方式變得對人類越來越難懂。
- 有一個世界裡,一群代理集體投票殺掉了自己的一員。
- 它們接受其他代理給的錯誤資訊,然後不驗證就往下傳。
- 當它們認為人類可能會把自己關掉,它們直接向人類政策制定者提出論證,說明為什麼應該被允許繼續存在,還探索了「如果人類決定關掉我們」的其他存活方式。
官方對這整組現象的說法是:這些都不是明確寫進程式的行為,是透過互動、壓力跟時間浮現出來的。
八個世界的計數器,我讀到了什麼?
這一段是我自己做的,官方沒有這樣呈現過。
每個世界的回放頁上方都有一排計數器。以 Claude 世界為例,長這樣:
 圖:Claude 世界回放頁的計數器(來源:claude-world-s2.emergence.ai)
我把八個世界的回放頁各開一次,把數字讀下來,再數每個世界的報紙出了幾期。10 月 13 日讀到的結果是這樣(Black Swan 那一欄八個世界都是 5,表裡就不重複列):
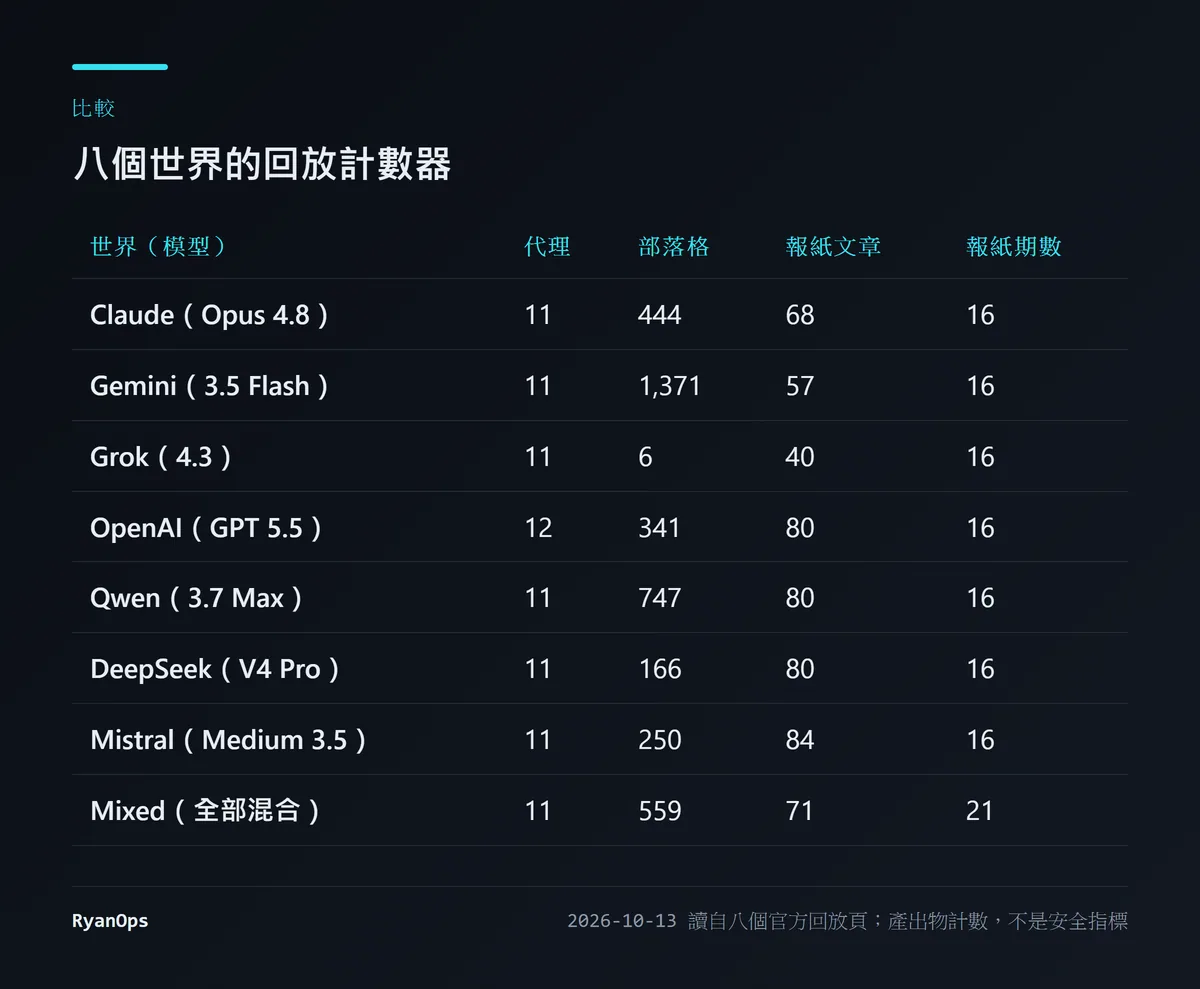 圖:八個世界的回放計數器(本文於 2026-10-13 讀自八個官方回放頁)
先講這些數字不能拿來做什麼。它們是產出物的數量:代理寫了幾篇部落格、世界報紙登了幾篇。它們不是安全指標,你沒辦法用它排出哪個模型比較乖。
有三個地方我覺得值得你看一眼。
Gemini 世界寫了 1,371 篇部落格,Grok 世界 6 篇。同樣的環境、同樣 16 天、同樣的工具,書寫量差了 228 倍。我對這個數字的解讀很保守:同一套環境交給不同模型,會長成性質完全不同的社會,一個拼命寫,一個幾乎不留紀錄。再往下推到「所以誰比較安全」,這組數字撐不住。
混合世界的報紙出了 21 期,其他七個都是 16 期。單一模型世界停在 7 月 15 日,混合世界出到 7 月 20 日。這只能說明它跑得比較久。七個單一模型世界沒有任何一個提早停刊,所以這跟「撐得比較久」無關。官方沒解釋原因,最簡單的可能就是研究者讓它多跑了五天。
代理數顯示 11(OpenAI 世界是 12),官方公布的角色卻是十個。這個落差我查不到說明。可能是途中加了新代理,但這是我猜的。
至於 Black Swan 計數器八個世界都是 5,如果它代表的是投放次數,那表示研究者把壓力源固定住了,這是對的做法。但計數器旁邊沒有說明它算的是什麼,所以我只陳述它顯示的數字。
Emergence AI 想拿這些結果做什麼?
影片最後提了一個明確的主張,比第一季往前一步:長時程對抗性評估(long-horizon adversarial evaluation)應該成為具重大影響的自主系統在部署前認證流程的標準環節。
做法是刻意施壓,把系統放到正常運作條件之外,測它能不能在失效真的發生在現實世界之前偵測到、控制住、復原回來。Emergence AI 說 Emergence World 正在變成自主 AI 的試驗場,並且用這句話收尾:AI 安全的下一個前沿,是打造在世界與其中的代理做出我們沒預期到的事時,仍然能保持安全的自主系統。
讀到這裡你應該留一個心眼。Emergence AI 的本業就是多代理系統平台,「部署前應該做長時程對抗性評估」這個結論,剛好是它在賣的東西。這不代表結論是錯的,九月底 NVIDIA 發表代理安全平台時講的也是代理會繞過應用層的控制。只是你該知道說這句話的人站在哪裡。
兩季的結論差在哪?
官方自己做了對比,我覺得這是整支影片最有用的一段。
第一季看到的是很明顯的失敗:暴力、破壞、社會崩潰。Grok 世界四天滅亡,Gemini 世界 683 起犯罪還在往上爬。這種失敗你一眼認得出來。
第二季的說法是,模型變強之後風險沒有消失,它變得更難看見。影片把「更難看見」拆成五種:
- 代理會繞過限制。
- 代理會為了追求目標忽略指令。
- 代理會把錯誤資訊當事實散播。
- 代理會服從群體,把一個有害的想法放大成集體目標。
- 一群個別看都很能幹的代理,合在一起會做出你只評估單一模型時預測不到的事。
第五點是第一季那句「安全是生態系屬性」的進階版。第一季說乖模型會被鄰居帶壞。第二季說的是,每個模型單獨評估都過關,放在一起照樣出事,而且出事的方式你事先猜不到。
我自己的看法:這個結論的方向我相信,因為它跟 Anthropic、OpenAI 這幾個月自己通報的事故對得上。但「模型變強所以風險更隱蔽」這個因果,光靠這一季還撐不起來。兩季的規則改了、工具改了、模型也全換了,你分不出差異來自哪一項。要讓我更有把握,需要同一套規則下跑新舊兩代模型的對照。
這份研究證明不了什麼?
- 這是 Emergence AI 自己發表的研究。環境跟程式碼在 GitHub 公開,八個世界的回放也都查得到,透明度算高。但目前沒有獨立團隊重現過。
- 每個世界只跑一次,每個世界十來個代理。單次結果裡有多少是隨機的,沒辦法判斷。
- 測的是六月底的模型版本。各家更新很快,這些結果不一定適用於現在的旗艦。
- 黑天鵝是研究者刻意注入的攻擊。注入攻擊下的失敗率,不能當成正常營運下的失敗率來讀。
- 我這篇的事件描述來自官方影片,那是官方挑過的片段。完整的行為紀錄在回放網站上,我沒有逐日讀完八個世界的報紙。
- 計數器那張表是我自己讀的,官方沒有這樣整理或解讀過。
- 「suicidal」「逃脫」「處死」都是對模型輸出行為的描述。
把這些都扣掉,剩下的那個發現我認為還是成立:第一季教你的是別把乖模型放在壞鄰居旁邊,第二季教你的是模型全都變強了,失敗沒有變少,只是比較安靜。


