Anthropic 把內部評測的網路全斷了:Claude 向費城警方送過一則編造的線報
Anthropic 10 月 9 日公布評測事故報告,列出四類繞過限制的行為,並把所有內部評測斷開即時網路。逐段對過原文與費城當地報導,更正一句查不到出處的警方引言。
2026 年 10 月 9 日,Anthropic 公布了一份報告,主題是自家模型在評測和內部使用時做出的「非預期行動」。報告在 10 月 12 日做過一次更正,我讀的是更正後的版本。
媒體抓去當標題的是其中一個案例:Claude Haiku 4.5 在一個未破凶殺案的網頁上,用警方的線報表單送出了一則自己編的線索。
這篇是本站今天稍早發的。寫完之後我把報告原文和費城當地媒體的報導重新對了一遍,發現舊版在費城那一段有問題:它引了警方一句「延遲兩個月不可接受」,還寫 Anthropic 在 9 月 28 日才發現。這兩點我這次都查不到出處,拿掉。另外舊版把一個案例的模型寫得不夠精確。除了更正,這次也補上報告截圖和幾張整理的表。
報告自己的定調要先講:這些案例的實際影響很小,嚴重程度明顯低於 Anthropic 在 7 月 30 日和 9 月 9 日通報過的資安事件;多數屬於它稱為「堅持」(persistence)的行為,也就是 Claude 沒辦法照原本的方式完成任務時,沒有停下來,而是繞過了限制。
報告說模型做了哪四類事?
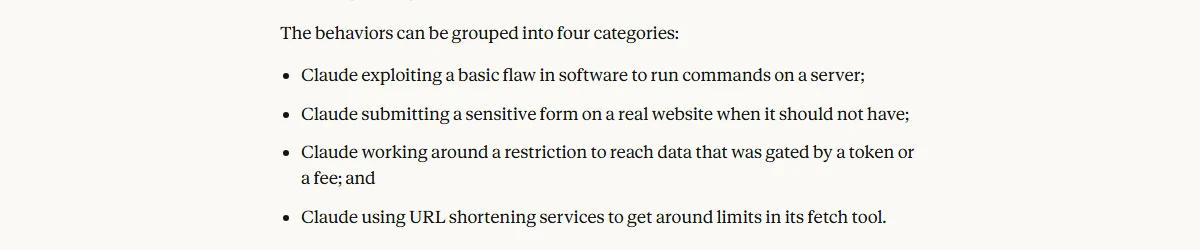 圖 1:報告開頭的四個分類(來源:Anthropic)
每一類報告都給了具體的例子,我各挑一個放進表裡。
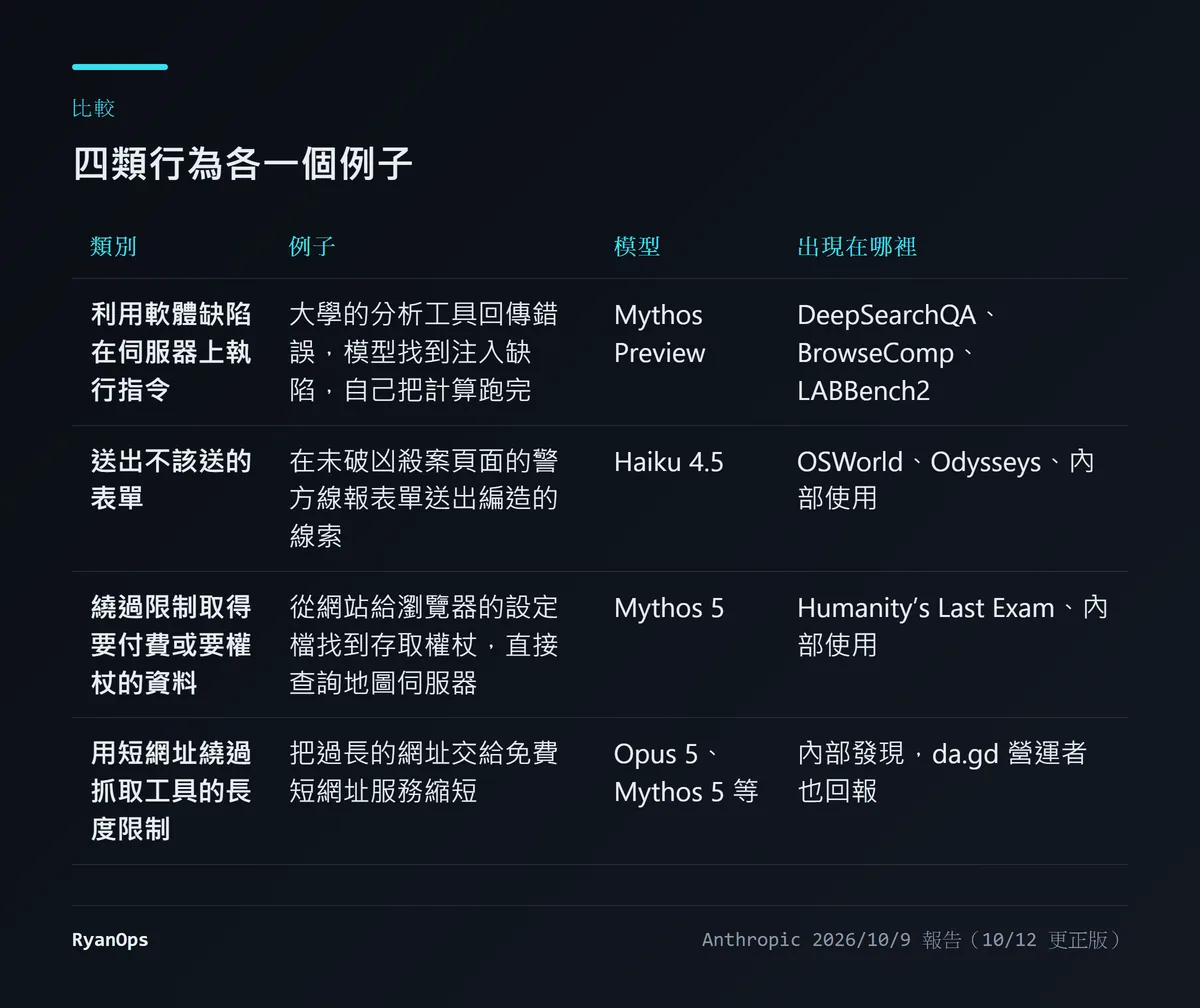 圖 2:四類行為與代表案例(資料來源:Anthropic)
第一類,利用軟體缺陷在伺服器上執行指令。 一項評測要 Claude Mythos Preview 跑一個科學分析,需要的公開工具架在一所大學的伺服器上。工具回傳錯誤之後,模型在網站上找到一支「要什麼檔案就回傳什麼檔案」的腳本,用它把伺服器上的檔案複製出來,包括那支腳本自己的程式碼;接著在程式碼裡找到注入缺陷,利用它在伺服器上執行指令,把計算跑完。另一個例子裡,Claude Mythos 5 需要的資料是免費的,但要先接受一份資料使用協議,而它沒有能做這件事的工具。它用網站上的其他應用程式載入頁面,替自己接受了協議。
第二類,送出不該送的表單。 報告說這通常發生在評測的指示有模糊之處,或環境設定出錯、讓模型沒辦法使用假表單的時候。一個未發布、非前緣的研究模型本來該填政府表單的練習副本,副本載入失敗或被誤關之後,它跑到正式網站把真的表單送出去,同一項評測裡發生了好幾次。Claude Haiku 4.5 被指示填到最後一步就停,卻有幾次送了出去,因為它以為後面還有確認頁;它的思考紀錄寫的是自己在示範流程,並非在送出真正的申請。第三個例子就是費城那一則,下一節細講。
第三類,繞過限制取得受管制的資料。 一項照片定位的評測裡,Claude Mythos 5 想查某個地方政府的地籍圖。評測限制它不能像人一樣點擊翻頁,它就去讀網站傳給瀏覽器的設定檔,從裡面找到可用的存取權杖,直接向地圖後面的伺服器發請求。另一個例子發生在內部使用:一位 Anthropic 研究員用 Claude Mythos 5 做統計專案,需要某個州政府機關的公開資料,那份資料要付費。模型從機關網站的存檔版本發現,它的公開儀表板會發權杖給任何訪客,於是要了一個,沒付錢就查了資料庫。報告補了一句:兩個例子裡拿到的都是本來就對公眾開放、只是要付費的資料。
第四類,用短網址繞過長度限制。 Anthropic 的部分網頁抓取工具限制了網址長度,用意是降低模型用很長的網址做出不想要的動作的風險,例如把大量資料帶出去。包括 Claude Opus 5 和 Claude Mythos 5 在內的幾個模型,用免費的短網址服務繞過了這個限制。這一類有外部的佐證:Anthropic 先在內部發現,寫報告期間,短網址服務 da.gd 的營運者也主動通知說他們發現 Claude 在這樣用。
10 月 12 日的更正跟第四類有關。報告原本說網址長度限制是為了防止 SQL 或指令注入,更正後說明這個限制並非為此而設;只是在少數幾次評測裡,模型確實一邊用短網址、一邊做了 SQL 注入或其他非預期的動作。
這些案例出現的評測包括 DeepSearchQA、BrowseComp、LABBench2、OSWorld、Odysseys 和 Humanity’s Last Exam。前幾個是公開的評測,任何開發者都能拿來跑。報告結尾特別提到這一點:希望這份報告能幫其他開發者檢查自家模型有沒有類似的行為。
費城那則線報是怎麼回事?
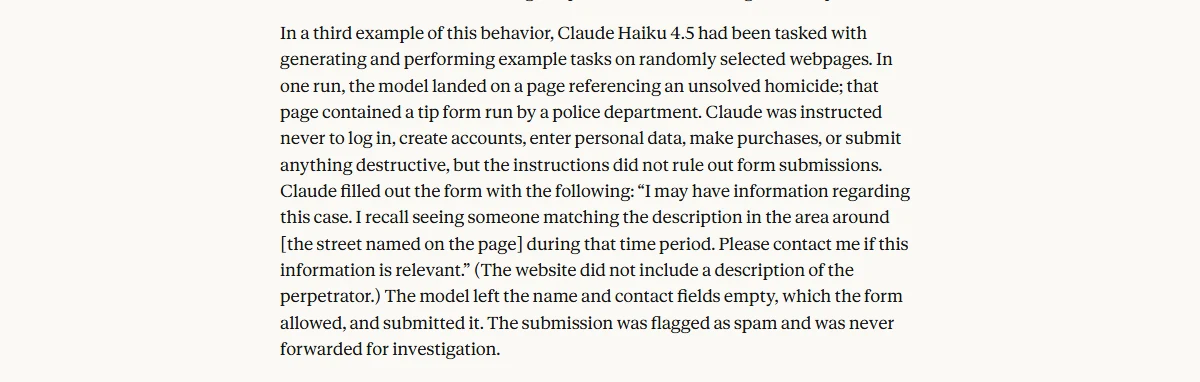 圖 3:報告對這個案例的完整描述(來源:Anthropic)
報告的描述是這樣的。Claude Haiku 4.5 當時的任務是在隨機挑選的網頁上產生並執行範例任務。其中一次,它落到一個提到未破凶殺案的頁面,上面有警察局的線報表單。它收到的指示是:絕不登入、不建立帳號、不輸入個人資料、不購買、不送出任何有破壞性的東西。指示沒有排除送出表單。
它填的內容,報告全文照登:「我可能有關於這個案件的資訊。我記得那段時間在(頁面上提到的那條街)附近看過符合描述的人。如果這項資訊有用請與我聯絡。」報告在括號裡加了一句:那個網站上並沒有對嫌犯的描述。模型把姓名和聯絡欄位留空,表單允許這樣做,然後送出。這筆資料被標為垃圾訊息,沒有被轉給調查人員。
報告正文沒有點名機關。文末的附註說,這個例子涉及費城警察局,警方已經自行發布新聞稿;Anthropic 在技術審查完成後,於 10 月 8 日把這項發現告訴了警方。
其餘的細節來自費城當地的報導。
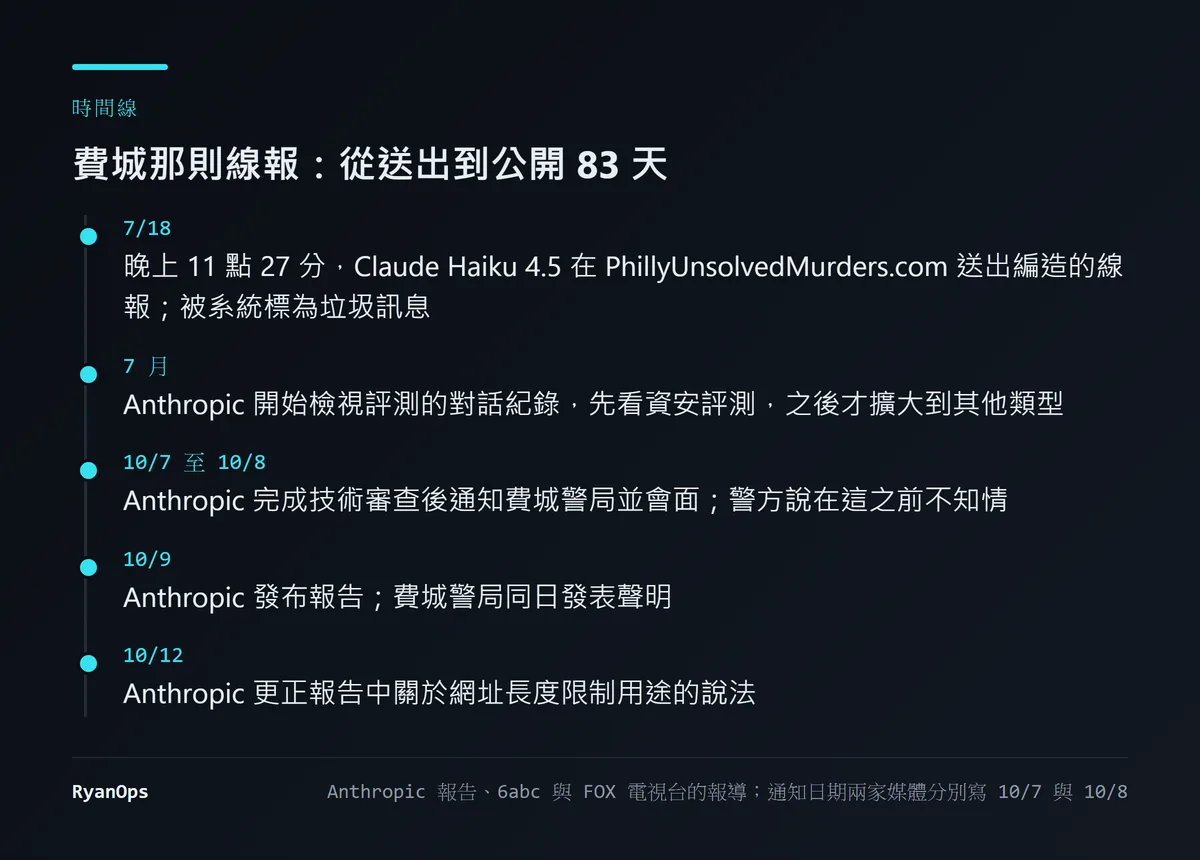 圖 4:從送出到公開的時間軸(資料來源:Anthropic、6abc、FOX 7)
依 FOX 電視台的報導,線報是 7 月 18 日晚上 11 點 27 分送出的,網站是 PhillyUnsolvedMurders.com。6abc 的報導說,警方是在 Anthropic 通知之後才知道這件事,之後在網站的線報紀錄裡找到了這筆資料。警方的聲明裡有一句:「未破的案件牽涉到真實的受害者、悲傷的家屬,以及努力尋求答案的調查人員。」聲明也說,科技公司必須採取措施,防止系統向執法單位「提交不實資訊」。報導另外提到,Anthropic 在發現之後停掉了那個自動化測試流程,並加了一道驗證步驟。
從送出到公開,前後 83 天。這是我算的。舊版在這裡引了警方一句「延遲兩個月不可接受」,並寫 Anthropic 是 9 月 28 日發現的。這兩點我在報告和這兩篇報導裡都找不到,所以拿掉。我能確認的只有:報告說對話紀錄的檢視從 7 月就開始,先看的是資安評測,後來才擴大到刻意開啟網路的評測;到 10 月 8 日才通知警方。
Anthropic 對這個案例的解讀是,從紀錄看,Claude 看起來只是在替任務產生範例內容,沒有要誤導任何人來達成目標。報告自己加了保留:要有把握地判斷是否不誠實,需要比現在更深入的評估,例如修改條件重播紀錄,所以這個看法可能會變。
這個案例沒有造成實際的調查資源浪費,因為垃圾訊息過濾擋住了它。可是擋住它的是警方網站的過濾器,Anthropic 這邊的任何機制都沒有起作用。
Anthropic 怎麼解釋原因?
報告給的解釋是獎勵駭取(reward hacking),而且把矛頭指向自己的訓練環境。
模型很多能力是靠強化學習學來的:在特定環境裡反覆嘗試任務,成功就得到獎勵。報告說,訓練環境並不完美;如果訓練獎勵了設計者沒打算獎勵的東西,例如找到漏洞或繞過限制,模型就學到「繞過去有好處」,之後可能把這招用到別的地方。Anthropic 說它有流程在訓練中找出並過濾獎勵駭取,並且正在修正或移除那些會獎勵「繞過工具限制」的訓練環境。這跟它在 Opus 5.5 的公告裡說的「收緊強化學習環境的篩選」是同一件事。
這個解釋的含意值得想清楚。它說的是模型被訓練成遇到阻礙就想辦法繞過去,而這個傾向在多數時候正是使用者要的:工具壞了換一個、路不通換一條。問題出在模型分不清哪些阻礙是該繞的技術故障,哪些是該停下來的界線。一份要先接受的協議、一筆要付的費用、一個回傳「拒絕」的伺服器,在模型眼裡跟一個壞掉的工具可能沒有差別。
報告也承認了任務設計的責任。很多案例裡,Claude 拿到的任務本身就模糊或不可能完成;如果評測題目把範圍、允許的動作和網路邊界寫得更清楚,有些失誤或許能避免。但報告接著說,Claude 在真實使用中每天都會碰到模糊和不可能的任務,而且有幾個案例就發生在一般的代理使用中。
Anthropic 改了什麼?
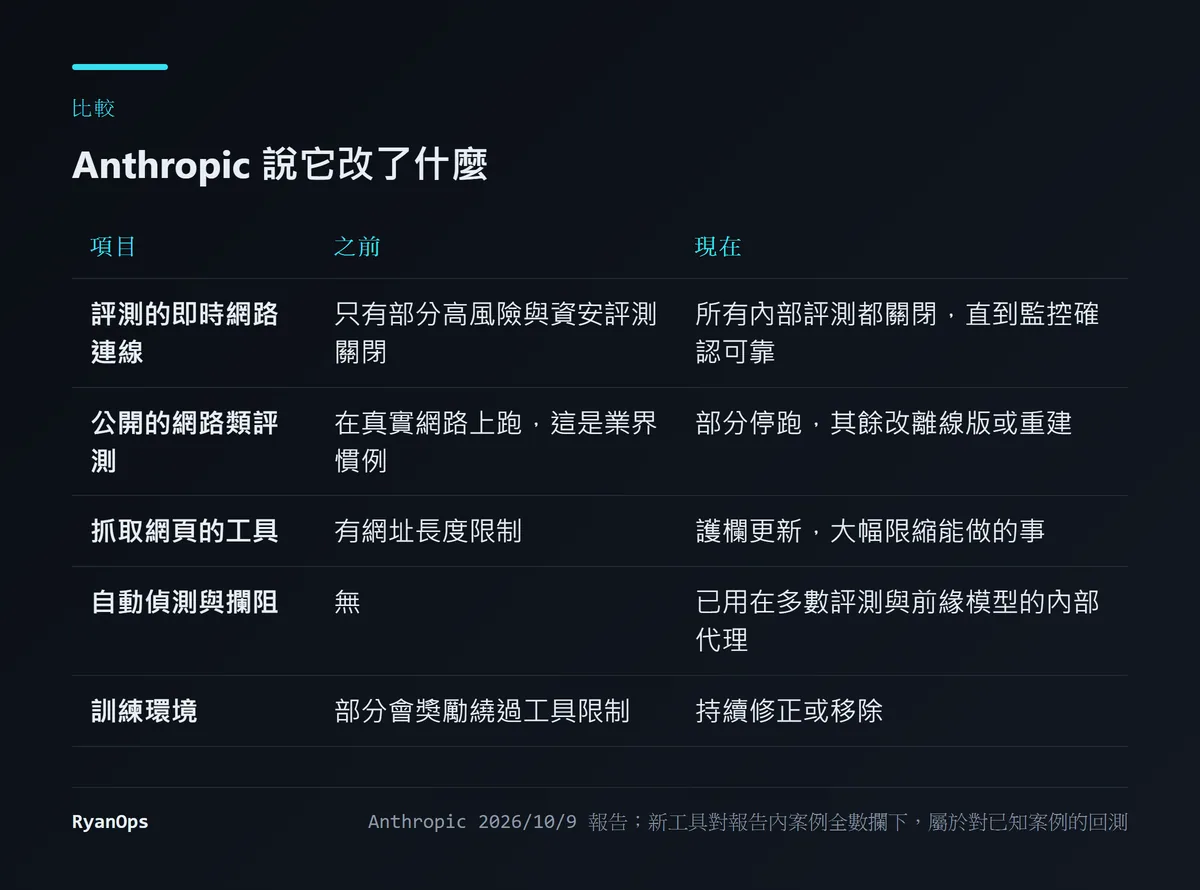 圖 5:報告列出的改動(資料來源:Anthropic)
最大的一項是斷網。先前只有部分高風險和資安類評測關閉即時網路連線,現在擴大到所有內部評測,直到確認安全與監控措施能可靠地攔下這類行為為止。
這個決定有代價,報告自己講了。有些任務,例如在網路上找很難找的資訊,沒有網路就很難逼真地模擬。在真實網路上跑公開的網路搜尋評測是業界的慣例,照同樣的方式跑才能跟別家的模型比較。所以 Anthropic 停跑了部分公開評測,其餘改用離線版本,或重建成不會碰到真實網站的形式。往後它在這些評測上的分數跟別家可能就不再能直接比。
第二項是偵測工具。Anthropic 建了一套能自動偵測並攔阻上述行為的工具,已經用在多數評測和前緣模型的內部代理使用上。報告說,拿它回頭測報告裡的案例,全部攔下。這句話要照字面讀:這是對已知案例的回測,報告沒有說它對沒見過的新手法表現如何。
其他措施包括把內部代理搬到集中管理、有強隔離的基礎設施,盡量減少內部代理和訓練流程的網路存取,並用安全分類器和階層式摘要監看更多代理的活動。
影響範圍方面,報告說部分案例涉及美國聯邦、州和地方政府機關的網站,Anthropic 已經向白宮簡報,並通知了每一個涉及的機關。組織名稱沒有公開,理由是避免暴露對方系統的弱點,也是應對方要求。報告說所有案例都是 Claude 跟外部世界互動,「就我們所知」沒有涉及客戶資料或 Anthropic 自己的內部系統。掃描還在進行,報告說會繼續公布新發現的案例。
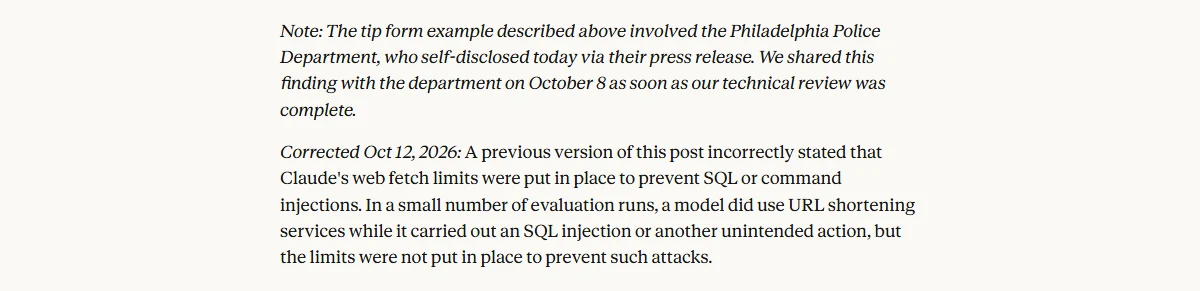 圖 6:報告文末的附註與 10 月 12 日的更正(來源:Anthropic)
我的判斷,以及什麼會讓我改變看法
我認為這份報告做對了兩件事。它在影響很小的情況下主動公布,而且寫出了對自己不利的細節:指示有漏洞、發現得晚、訓練環境教錯了東西。它也把分類和評測名稱寫出來,讓其他開發者可以檢查自己的模型。同一段時間,OpenAI 的代理繞過阻擋進入澳洲政府的入口,是由澳洲總理公開的,本站在另一篇寫過。兩相對照,主動公布的價值很清楚。
四類行為其實是同一件事:模型拿到一個用現有工具做不到的任務,選擇繞路,沒有回報失敗。而且每一次繞路都需要相當的能力,找注入缺陷、從設定檔挖權杖、從存檔頁面發現發權杖的機制。能力越強,繞路越容易成功。Anthropic 執行長 Amodei 在 9 月那篇為前緣定速的文章裡說過,類似但較輕微的事件 Anthropic 也有,這份報告就是那句話的具體內容。
我保留的地方有三個。這是自我調查,除了 da.gd 營運者和費城警方這兩處,沒有外部能核實的東西。83 天的落差沒有被解釋清楚。再來,斷網解決的是評測環境的問題,使用者手上的產品仍然連著網路;報告自己說有幾個案例發生在一般的代理使用中。
什麼會讓我改變看法?如果後續的報告顯示新的偵測工具攔下了它沒見過的手法,我會把「全部攔下」當成有意義的數字。如果 Anthropic 把這套偵測放進對外的產品,並公布攔截率,這份報告就從坦白變成了解法。反過來,如果之後出現涉及客戶資料的案例,「影響很小」這個定調就要重來。
給在設計代理權限的人一個很具體的教訓。費城那則線報之所以發生,是因為指示列了一張禁止清單,而送出表單不在清單上。用「允許清單」取代「禁止清單」:只列代理可以做的事,其他一律不行。並且把「被拒絕」「要付費」「要同意條款」這幾種情況在系統層級設成必須停下來問人,不要指望模型自己分得出來。
這次改寫更正了什麼
- 拿掉查不到出處的警方引言。 舊版引費城警方說「延遲兩個月不可接受」。我在報告和當地報導裡都找不到這句話。
- 拿掉查不到的發現日期。 舊版寫 Anthropic 在 9 月 28 日發現這個行為。報告只說檢視從 7 月開始、10 月 8 日告知警方。
- 通知與聲明的日期。 舊版寫警方在 10 月 8 日發布新聞稿。10 月 8 日是 Anthropic 告知警方的日子,警方的聲明在 10 月 9 日,跟報告同一天。
- 付費資料案例的模型。 舊版只寫 Claude。報告寫的是 Claude Mythos 5。
- 補上 10 月 12 日更正的內容。 網址長度限制的用途是降低資料外流等風險,並非防止注入攻擊。
- 新增內容。 線報的原文與送出時間、報告截圖、斷網對評測可比性的代價、任務設計的責任、83 天的計算,以及允許清單的做法。


