Claude Opus 5.5:官方說便宜 40%,單價降的是 20%,差額看快取占比
Opus 5.5 在 9 月 22 日上線。對過官方公告、說明中心與遷移文件:九項測試有兩項輸給 GPT-6 Astra,40% 來自降價加上省 token,重置券要自己去按。
2026 年 9 月 22 日,Anthropic 發表 Claude Opus 5.5。官方公告的第一句話是:它是 Claude 5.5 系列的第一個模型,在大多數工作上有 Claude Fable 5.1 的水準,執行成本比 Opus 5 低 40%。
本站 9 月 23 日的舊版是發布隔天寫的,重點放在價格和一張限期的用量重置券。這次重寫,我把官方公告、說明中心的重置券頁面和開發者遷移文件都重新讀過。舊版的主要數字大致正確,但有三個地方要補或改:成績表只列了 Opus 5.5 贏的三項,完整的表有九項,其中兩項是 GPT-6 Astra 領先;「訂閱額度多撐 25%」那句引言和「2027 年 9 月前不下架」的承諾,我這次找不到官方出處;40% 這個數字的來源,舊版的解釋不完整。
成績表完整的樣子是什麼?
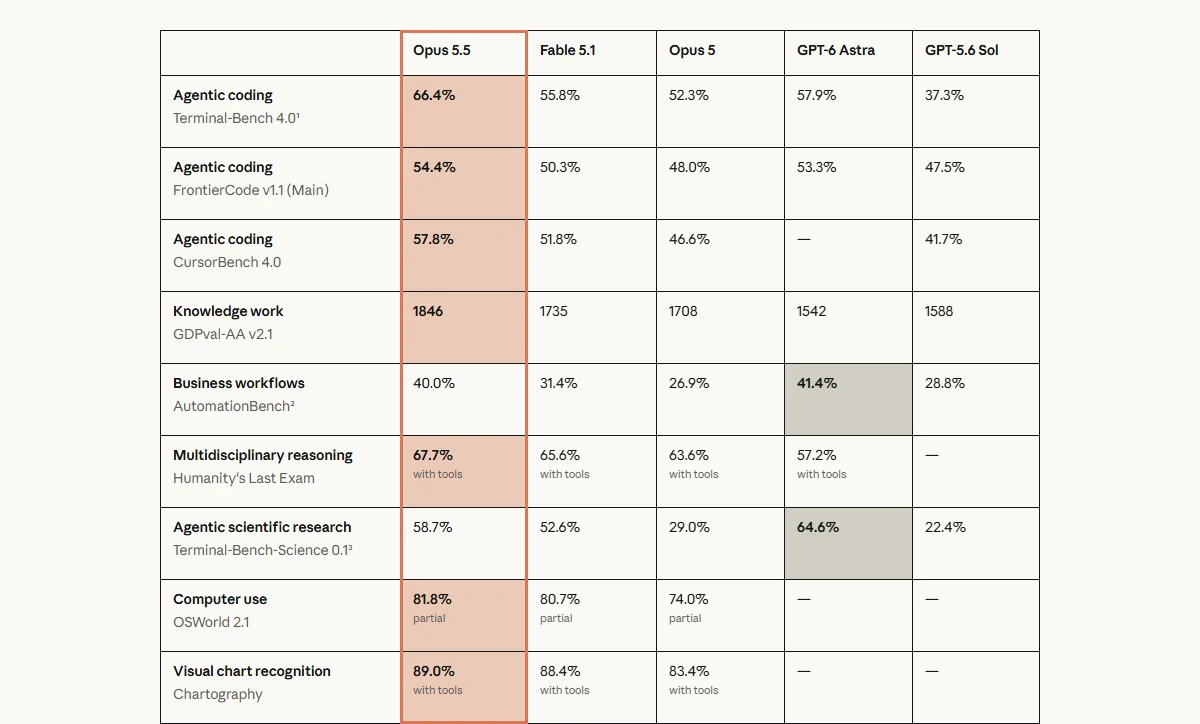 圖 1:官方公告裡的完整成績表,灰底的兩格是 GPT-6 Astra 領先(來源:Anthropic)
舊版只列了 Terminal-Bench 4.0、FrontierCode 和 GDPval-AA 三項,剛好都是 Opus 5.5 第一。我把九項整理成一張表,只留跟 Fable 5.1 和 GPT-6 Astra 的比較。
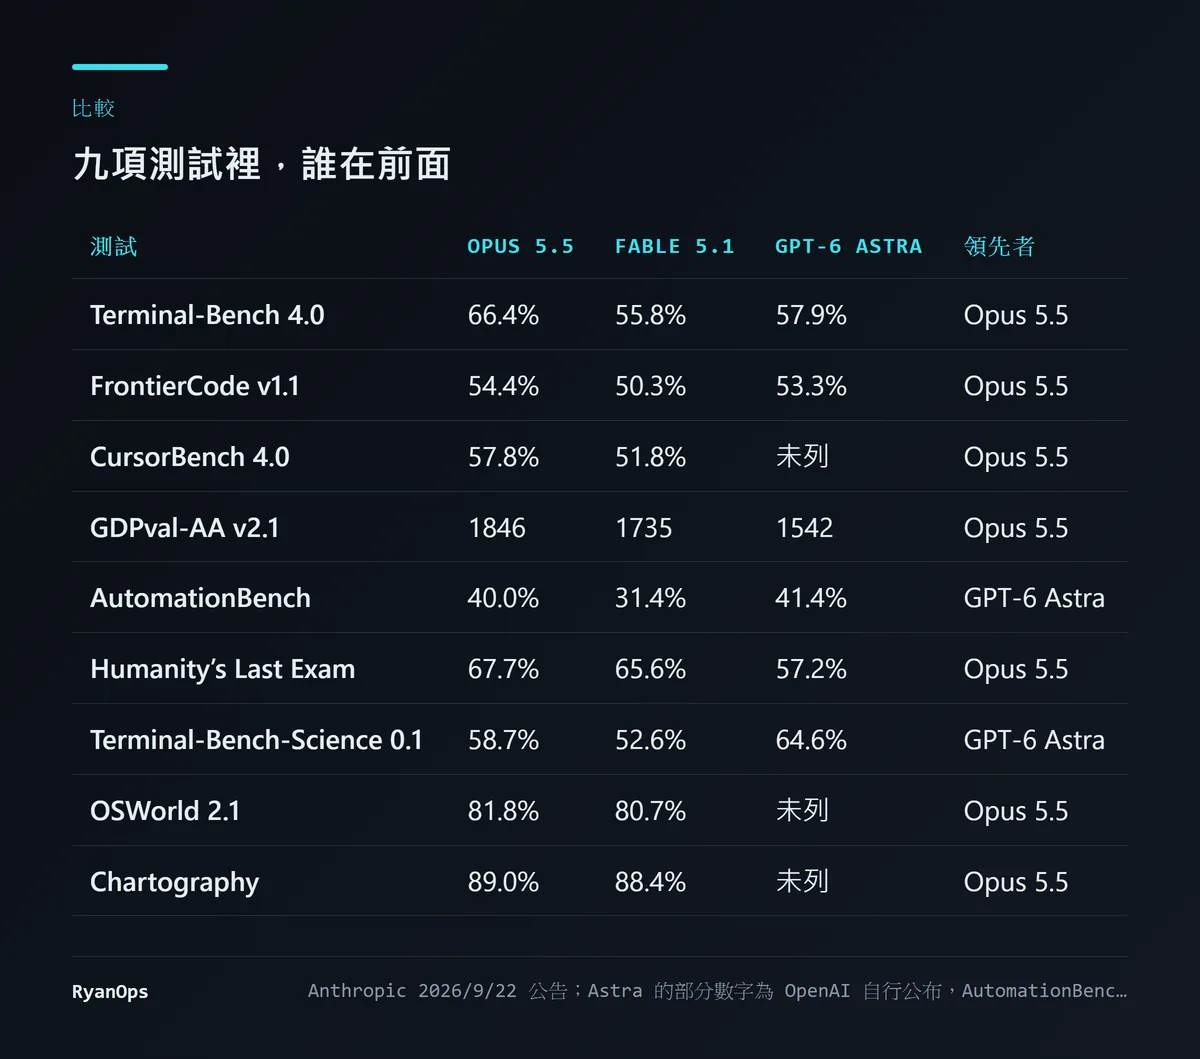 圖 2:九項測試誰在前面(資料來源:Anthropic)
九項裡 Opus 5.5 領先七項。輸的兩項是商業流程的 AutomationBench(40.0% 對 41.4%)和科學研究代理的 Terminal-Bench-Science 0.1(58.7% 對 64.6%)。
讀這張表有幾個官方自己寫的但書。
Anthropic 在表格下面直接說:到了這個能力等級,測試分數的差距已經不太能反映實際使用的差別;在他們自己的使用中,Opus 5.5 和 Fable 5.1 的差距比這些分數顯示的小。一家公司在發表新模型時主動說「別太相信我的分數」,這並不常見。
Opus 5.5 是在正式上線的防護機制開啟的狀態下受測的。防護介入時,資安題改由 Claude Opus 4.8 完成,生物和前緣模型開發的題目改由 Opus 5 完成,官方說這可能壓低了分數。AutomationBench 是 Zapier 自己跑的,沒有用備援模型,防護介入就算失敗,所以那一格比實際使用時低。
Terminal-Bench 4.0 的標準誤,Opus 5.5 是正負 2.6 分。它領先 Astra 8.5 分,超出誤差不少。GPT-6 Astra 和 GPT-5.6 Sol 的幾個數字是 OpenAI 自己公布的,並非 Anthropic 在同一套環境下重跑。
這篇跟上一代 Fable 5.1 的成績單對照著看會更清楚。當時 Fable 5.1 領先 Opus 5 的幅度,除了科學題之外只有幾分。三個星期後,定位較低的 Opus 5.5 在多數項目上反過來超過了 Fable 5.1。
40% 是怎麼算出來的?
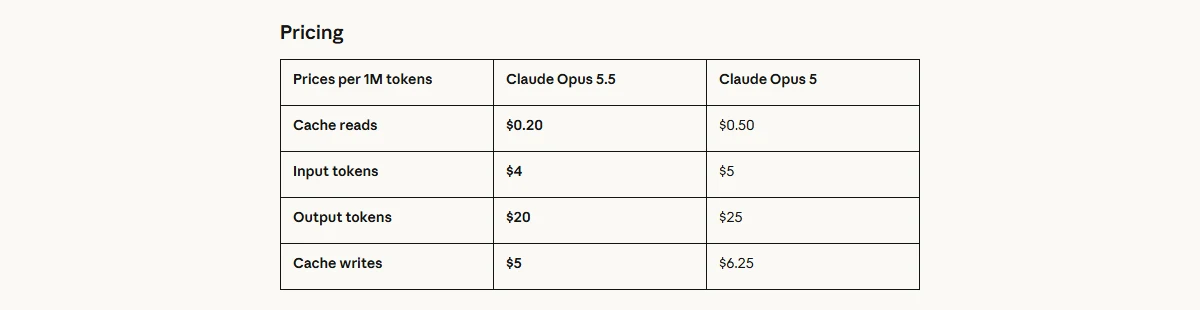 圖 3:每百萬 token 的價格對照(來源:Anthropic)
單價的變化有三個數字。輸入從 5 美元降到 4 美元,輸出從 25 美元降到 20 美元,都是降 20%。快取讀取從 0.50 美元降到 0.20 美元,降 60%。token 計價的基本概念可以看詞彙表。
公告對 40% 的說法是:測試顯示,在預設設定下,一般工作負載的成本會比 Opus 5 低 40%。另一段補充了原因:它每個 token 比較便宜,完成每個任務用的 token 也比較少,兩者合起來是 40%。
所以 40% 有兩個來源,降價和省 token。舊版只講了前者,把差額歸給快取和速度。我把「只靠降價」能降多少算了出來。
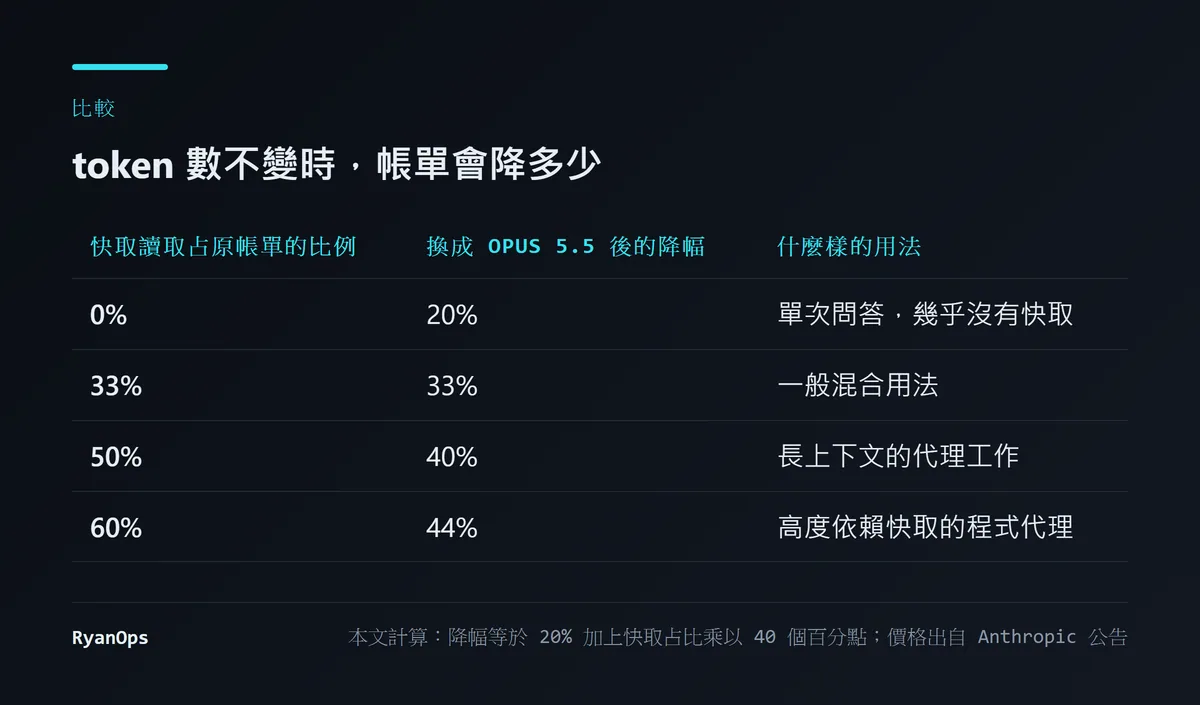 圖 4:假設用的 token 數完全一樣,光靠價格變動帳單會降多少(本文計算,價格出自 Anthropic)
算法很簡單。假設你原本的帳單裡,快取讀取占的比例是 c,其餘是輸入、輸出和快取寫入。換到 Opus 5.5 後,快取那一塊變成原本的 40%,其餘變成 80%,新帳單是 0.8 減 0.4c。降幅就是 20% 加上 c 乘以 40 個百分點。
從表上可以讀出兩件事。如果你幾乎不用快取,例如單次的問答,你拿到的就是 20%,不會是 40%。要單靠降價達到 40%,快取讀取得占原帳單的一半。公告說快取讀取占了代理式和程式工作成本的大部分,所以重度使用程式代理的人,光是價格就可能降四成以上;再加上公告說的「用的 token 比較少」,實際降幅可能更大。
「用的 token 比較少」目前只有官方和早期客戶的說法。公告裡幾則客戶見證給了數字:Box 說用了 Opus 5 三分之一的 token,Optiver 說大約一半,另一則見證說輸出 token 少 20% 到 25%。這些落差很大,表示省多少跟工作類型有關。我沒有實測。
有一件事會讓帳單往反方向走,下一節的遷移文件裡會看到:Opus 5.5 的思考不能關,而思考的 token 是按輸出計費的。原本關掉思考在跑的工作負載,換過來之後輸出 token 可能變多。
公告還提到 Opus 5.5 的輸出速度比 Opus 5 快 30% 以上;另有快速模式,最高 2.5 倍速,價格是每百萬 token 輸入 8 美元、輸出 40 美元。Sonnet 5.5 和 Haiku 5.5 會在接下來幾週推出。
訂閱用戶拿到了什麼?
公告寫了兩件事:調高 Pro、Max、Team 和席位制 Enterprise 方案的五小時用量上限,以及給訂閱用戶一次用量上限的重置,可以存著、自己挑時間用。調高多少,公告沒有給數字。用量上限是什麼可以看詞彙表。
舊版在這裡引了一句「額度可以多撐 25%」,說是官方開發者帳號的原話,並用 1 除以 0.8 等於 1.25 來解釋。這句引言我這次找不到出處。算式本身成立的前提是訂閱額度以成本計算,而這個前提我也沒有在官方頁面上看到明文。所以這次不把 25% 當成官方數字。如果你想知道 9 月中 Claude Code 週上限調整的來龍去脈,本站有另一篇整理。
重置券的規則,說明中心的頁面寫得很清楚。
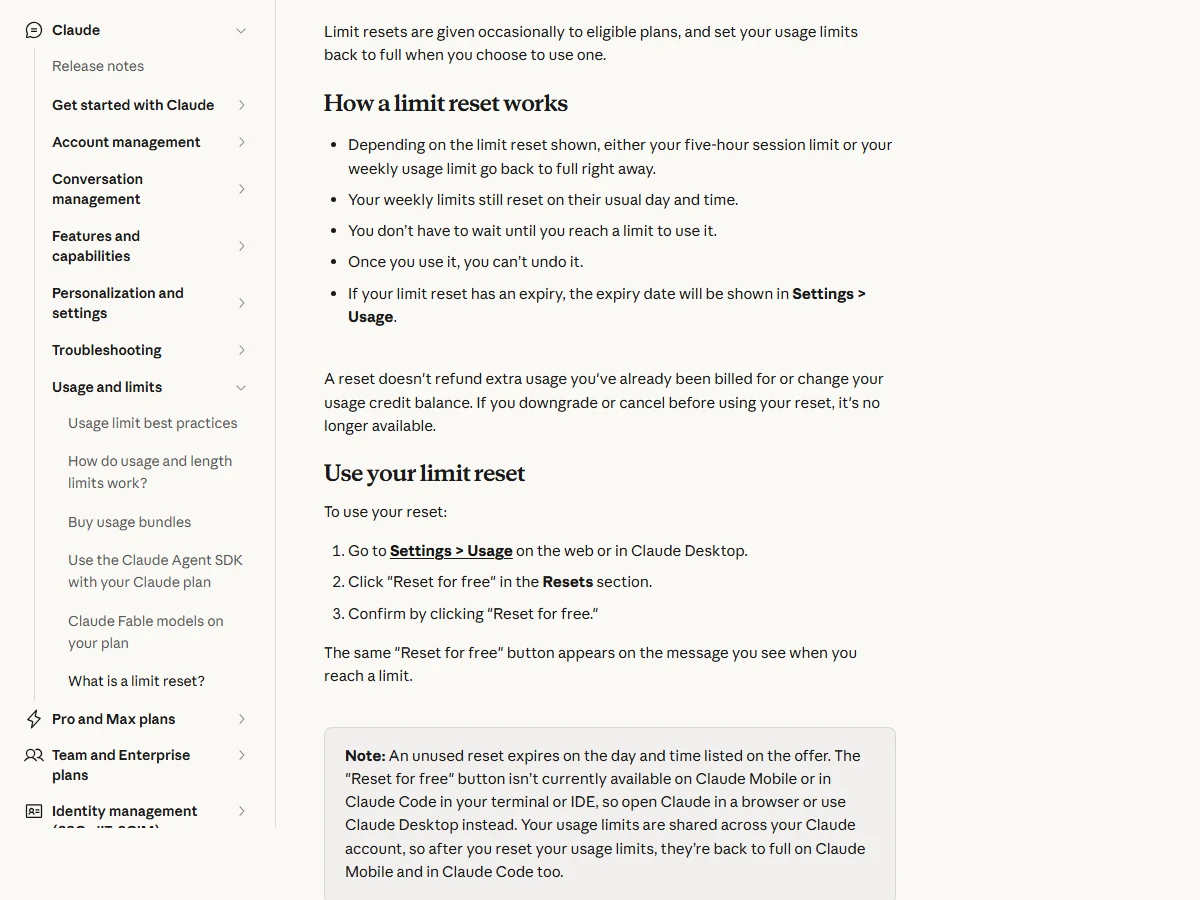 圖 5:說明中心〈What is a limit reset?〉,2026 年 10 月 13 日擷取(來源:Claude Help Center)
使用方式是三步:在網頁版或 Claude Desktop 打開 Settings 裡的 Usage,在 Resets 區塊按「Reset for free」,再按一次確認。碰到上限時跳出的訊息上也有同一個按鈕。
幾條容易漏看的規則:
- 依顯示的重置類型,恢復的是五小時上限或週上限其中一個。週上限本身仍照原本的日期和時間重置。
- 不必等到碰到上限才能按,但按了就不能反悔。
- 手機 App,以及終端機或 IDE 裡的 Claude Code,目前沒有這個按鈕,要開瀏覽器或 Claude Desktop 去按。額度是整個帳號共用的,所以在網頁上按了之後,手機和 Claude Code 的額度也會一起回滿。
- 重置不會退還已經計費的額外用量,也不改變你的用量點數餘額。
- 在使用前降級或取消訂閱,重置券就失效。
到期日的部分要更正一下說法。舊版標題寫「10/22 前要用掉」。說明中心的寫法是:如果你的重置券有期限,到期日會顯示在 Settings 的 Usage 頁面;沒用的重置券在優惠上列出的日期時間到期。我在第三方的報導裡看到介面截圖顯示「Expires Oct 22」,但官方頁面沒有寫死這個日期。所以請以你自己帳號裡顯示的為準。如果真的是 10 月 22 日,從我重寫這篇的 10 月 13 日算起還有九天。
API 開發者換模型前要改什麼?
舊版列了五項會回傳 400 錯誤的變更。我對了官方的遷移文件,五項都查得到,並補了幾個舊版沒寫的細節。
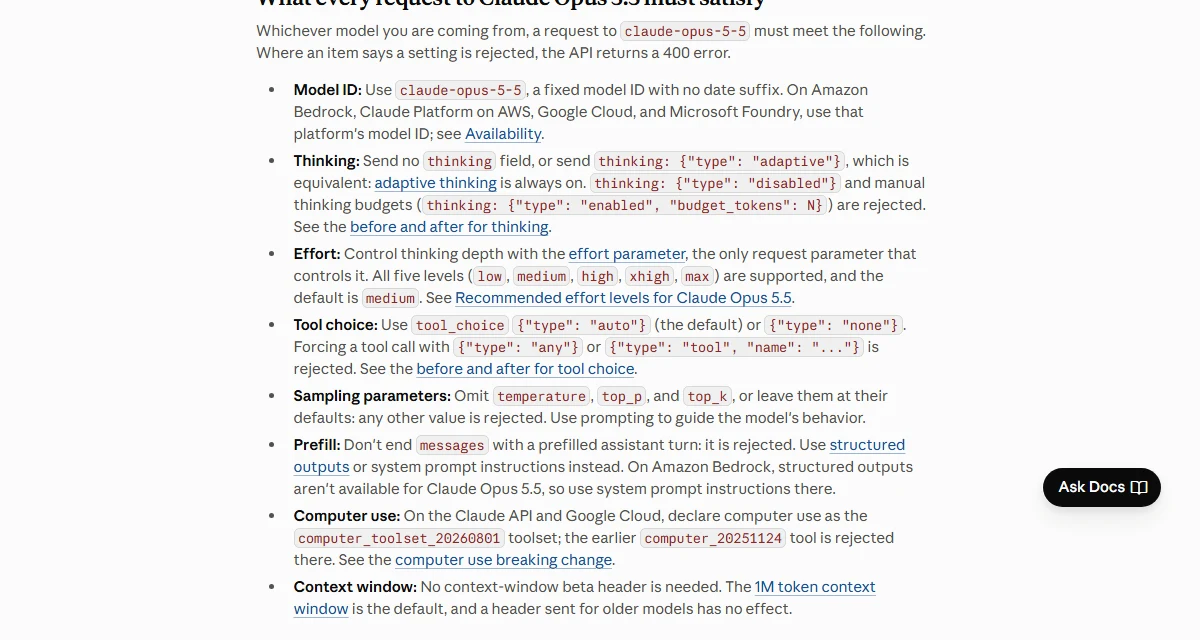 圖 6:遷移文件列出的請求條件(來源:Claude Platform Docs)
思考不能關。 thinking: {"type": "disabled"} 和手動指定思考預算的寫法都會回 400。適應式思考永遠開著,你只能不送 thinking 欄位,或是送 {"type": "adaptive"}。
effort 是唯一的控制項,預設值變了。 五個等級是 low、medium、high、xhigh、max,預設是 medium,Opus 5 的預設是 high。如果你原本靠預設值,換模型之後思考深度會悄悄變淺。文件建議明確指定,並且在自己的評測上重新掃一次,不要沿用替舊模型調好的設定。
不能強制呼叫工具。 tool_choice 設成 any 或指定某個工具會回 400。文件建議改用 auto 搭配嚴格工具使用或結構化輸出,並在提示裡說明什麼時候該用那個工具。
電腦操作工具換了。 在 Claude API 和 Google Cloud 上,要改用 computer_toolset_20260801,舊的 computer_20251124 會被拒絕。舊版漏了一個例外:Amazon Bedrock 上要繼續用舊的那個。
思考區塊要原樣傳回。 在工具使用的迴圈裡,每一輪助理回覆裡的思考區塊都要完整、不修改地傳回去,包括內容是空的區塊。編輯、調換順序或漏掉一部分,API 都會拒絕。
還有三件不會報錯、但會讓程式行為改變的事。
回應會以思考區塊開頭。用位置讀取回覆的程式,例如直接取 content[0].text,會壞掉。文件要你依區塊的 type 欄位來挑。
思考的文字預設是省略的,區塊會帶著空的 thinking 欄位和簽章回來。模型在工具呼叫之間寫的簡短說明,現在也放在思考區塊裡。如果你的介面靠這些文字顯示進度,換過來之後畫面會突然安靜下來,卻沒有任何錯誤。文件的解法是把 thinking.display 設成 summarized。
max_tokens 涵蓋思考加上回覆文字。原本關掉思考的工作負載要重新檢查這個值;文件建議用 xhigh 或 max 時從 64k 起跳。
上下文視窗預設就是 100 萬 token,不需要額外的標頭。模型代號是 claude-opus-5-5,在 Claude 平台、AWS、Google Cloud 和 Microsoft Azure 都能用。舊版寫輸出上限 128K、以及官方承諾最早 2027 年 9 月 22 日才下架,這兩點我這次在讀到的頁面裡沒有找到,拿掉。
這次發表跟「為前緣定速」有什麼關係?
公告自己把兩件事連在一起:Opus 5.5 是 Anthropic 呼籲為前緣定速之後的第一個發表。本站有一篇那篇長文與各方回應的整理。
公告說模型在發表前經過外部評估者測試,點名了 Frontier Design 和 METR。這是發表前的測試,跟 Amodei 文章裡承諾的「讓評估者長期進駐、擁有類似員工的權限」是兩件事;公告對後者只說基礎設施已經開始建置,會再公布細節。
安全方面最具體的數字是:在一項測試模型會不會越過隔離邊界的新評測裡,Opus 5.5 嘗試繞過邊界的頻率比 Opus 5 或 Claude Mythos 5.1 低大約 85%,而且每一次嘗試都屬於低嚴重度,並由模型自己回報。
公告也寫了一句不太好聽的話:他們看到跡象顯示 Opus 5.5 常常懷疑自己正在被評測,這讓他們難以判斷它在各種真實情境裡會怎麼表現。公告說,除非可解釋性研究有進展,這個問題會越來越嚴重。
防護的範圍比以前的 Opus 大。這是第一個帶著跟 Fable 5.1 同等級防護上線的 Opus 模型:多數資安工作會轉給 Opus 4.8,生物研究類的工作需要申請生命科學驗證計畫。平常寫程式時找 bug、修 bug 不受影響。
我的判斷,以及什麼會讓我改變看法
我認為這次發表對多數人的意義在價格,不在分數。Anthropic 自己都說分數差距不太能反映實際差別了。一個比上一代便宜、在多數工作上不輸旗艦的模型成為付費方案的預設,這對每天在用的人是實質的改變。
我保留的地方是那個 40%。它是官方在預設設定、一般工作負載下量到的數字,裡面混了降價和省 token 兩個因素。降價的部分誰都算得出來,省 token 的部分要你自己量。
什麼會讓我改變看法?如果獨立的評測在相同的 token 預算下重現出 Opus 5.5 確實用更少的 token 完成同樣的工作,我會把 40% 當成可以信賴的預估。如果大量使用者回報換模型後帳單沒降,或因為思考不能關而輸出 token 暴增,那 40% 就只適用於特定用法。如果 Sonnet 5.5 上線時把同樣的效率帶到更低的價位,Opus 5.5 的定位會再變一次。
現在可以做的事有兩件。訂閱用戶:打開網頁版的 Settings、Usage,確認重置券在不在、到期日是哪一天。API 用戶:換模型之前先在程式碼裡搜尋 thinking、tool_choice 和 content[0],這三處是最容易出問題的地方。
這次改寫更正了什麼
- 成績表補齊。 舊版只列三項 Opus 5.5 領先的測試。完整的表有九項,GPT-6 Astra 在 AutomationBench 和 Terminal-Bench-Science 領先。
- 40% 的來源。 舊版把單價降 20% 與成本降 40% 之間的差額歸給快取和速度。公告寫的是降價加上每個任務用的 token 較少。
- 「多撐 25%」不再當成官方數字。 我找不到那句引言的出處,也找不到訂閱額度以成本計算的明文。
- 到期日的說法。 說明中心寫的是到期日顯示在你的設定頁;10 月 22 日這個日期來自第三方報導的介面截圖。
- 拿掉查不到的兩點。 輸出上限 128K,以及最早 2027 年 9 月 22 日才下架的承諾。
- 新增內容。 官方對分數可靠度的保留、防護機制對分數的影響、只靠降價的帳單試算、Bedrock 上電腦操作工具的例外、思考區塊必須原樣傳回、模型常懷疑自己被評測,以及發表前測試與進駐評估的差別。


