Claude Fable 5.1 成績單:科學題贏 Opus 5 達 23.6 分,其餘不到 5 分
Anthropic 9 月發布 Fable 5.1 與 Mythos 5.1。逐列算過官方表格:只有科學題大幅領先 Opus 5,快取讀取降價 75% 才是多數人有感的改變。
Anthropic 在 2026 年 9 月發布 Claude Fable 5.1 與 Claude Mythos 5.1。發布頁開頭就說明,兩者是同一顆模型,差別在防護層級:Fable 5.1 一般開放,Mythos 5.1 只透過信任存取計畫提供給通過審核的資安與生命科學單位。
本站 9 月 9 日的舊版照著發布頁的亮點寫了一遍:避險基金說它抓到四年沒人解開的當機、科學任務準確率翻倍、Mythos 重繪金星地圖。這次重寫,我把發布頁從頭讀完、把表格每一列拿出來算,發現舊版有一處寫錯(金星地圖是 Fable 5.1 做的),也漏掉了這份成績單最值得注意的地方:扣掉科學題,Fable 5.1 領先自家 Opus 5 的幅度只有 1.4 到 4.5 個百分點。
官方成績表該怎麼讀?
先看原表。Anthropic 拿 Fable 5.1 跟三個對象比:前一代 Fable 5、自家的 Opus 5,以及 OpenAI 的 GPT-5.6 Sol。
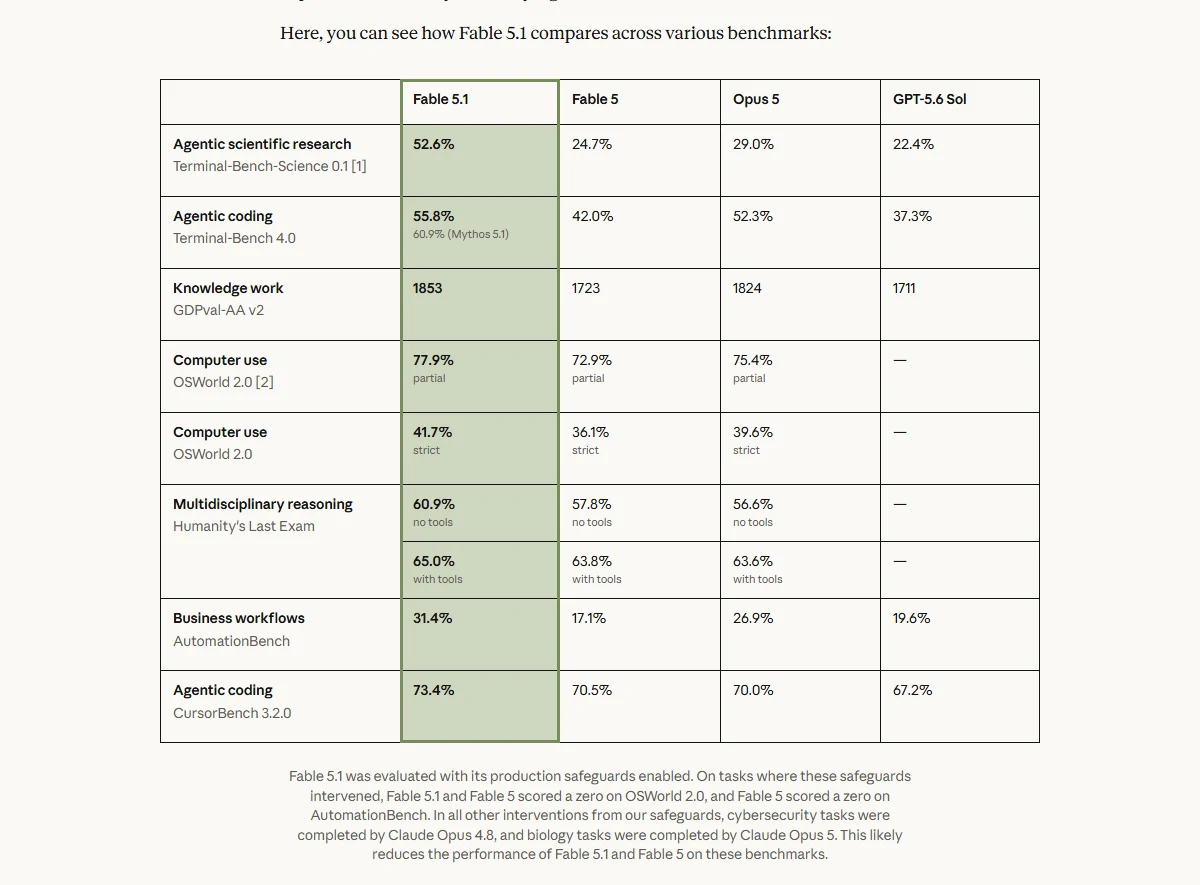 圖 1:發布頁上的成績表,表格下方的小字是防護機制對分數的影響(來源:Anthropic)
多數報導會拿 Fable 5.1 跟 Fable 5 比,那樣數字最好看:Terminal-Bench-Science 0.1 從 24.7% 到 52.6%,AutomationBench 從 17.1% 到 31.4%,Terminal-Bench 4.0 從 42.0% 到 55.8%。
可是這張表裡藏著一件比較尷尬的事。Fable 5 在好幾項測試上其實輸給定位較低的 Opus 5:Terminal-Bench 4.0 是 42.0% 對 52.3%,AutomationBench 是 17.1% 對 26.9%,GDPval-AA v2 是 1723 對 1824,連科學題都是 24.7% 對 29.0%。換句話說,「比上一代進步很多」有一部分是在補上一代落後的洞。要知道 Fable 5.1 把前緣往前推了多少,比較合理的對象是 Opus 5。我把這一欄算了出來。
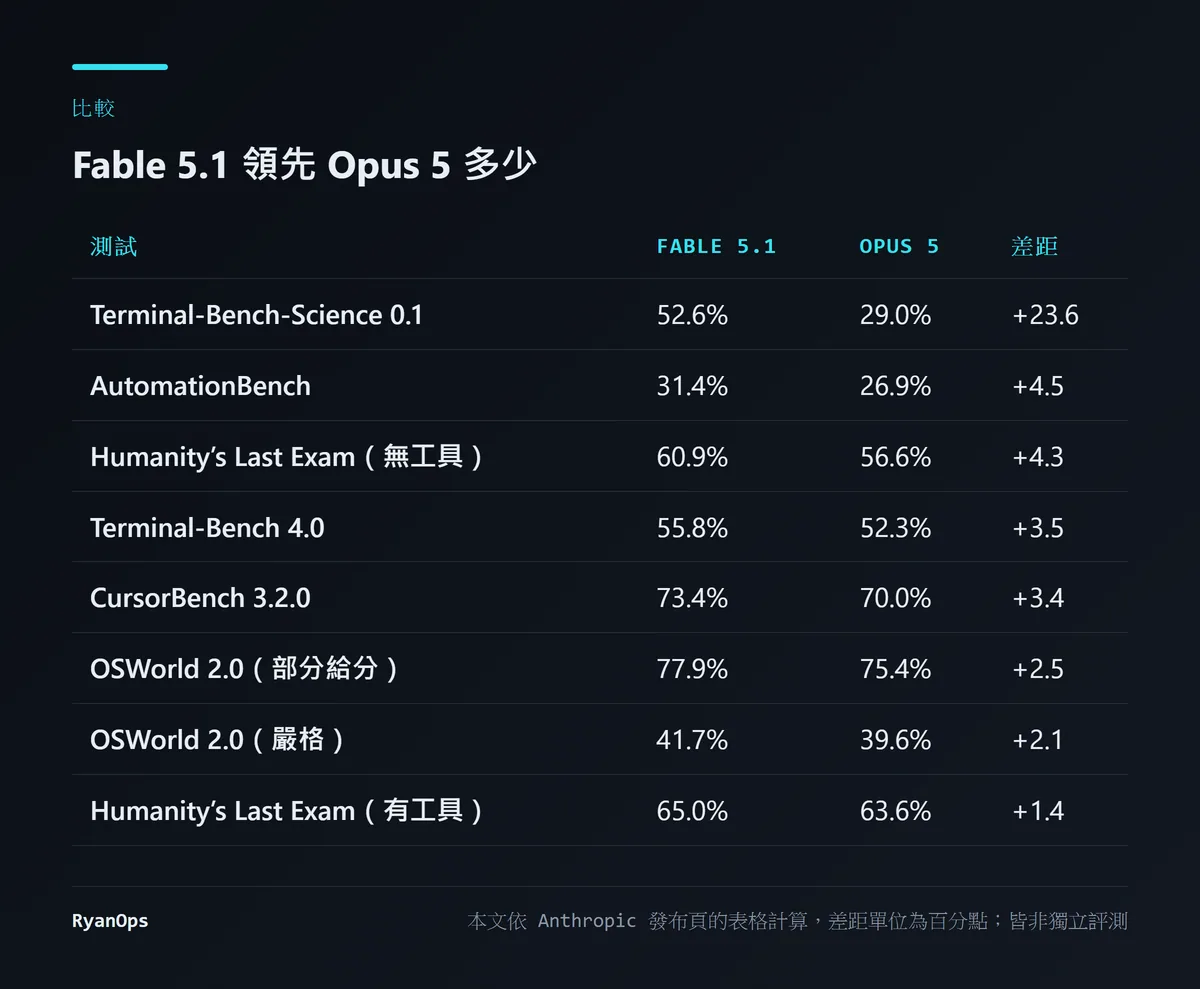 圖 2:以 Opus 5 為基準的領先幅度(本文計算,原始數字見 Anthropic 發布頁)
結果很分明。科學研究代理這一項領先 23.6 個百分點,是真正的跳躍。其餘七列全部落在 1.4 到 4.5 之間。知識工作指標 GDPval-AA v2 用的是積分,1853 對 1824,差 29 分;Vellum 的分析換算下來約 1.6%。
還有一個容易看錯的地方。Terminal-Bench 4.0 那一格有兩個數字:55.8% 是 Fable 5.1,底下小字的 60.9% 是 Mythos 5.1。同一顆模型,拿掉資安防護之後多了 5.1 分。舊版只寫了 60.9%,沒有交代那是一般人用不到的版本。
如果你對這些基準測試的名字不熟,只要記得一件事:這張表的數字出自 Anthropic 自己的測試或合作夥伴提供的結果,沒有一列是獨立機構測的。
這些分數有哪些但書?
發布頁自己就寫了三條,我照順序講。
防護機制會吃掉分數。 表格下方的小字說,Fable 5.1 是在正式上線的防護機制開啟的狀態下受測。防護介入時,OSWorld 2.0 的那一題直接記零分;其他測試裡,資安相關的題目會改由 Claude Opus 4.8 完成,生物相關的改由 Opus 5 完成。Anthropic 說這「可能降低」了分數。Vellum 的建議是把受影響的幾列當成下限來看。同一條但書也反過來影響比較:Fable 5 在 AutomationBench 被記零分的題目,會把 17.1% 到 31.4% 這個「將近翻倍」撐大一些。
科學題的標準誤不小。 註腳寫明 Terminal-Bench-Science 0.1 每個模型的標準誤是正負 3.5 到 4.5 分。公開排行榜上 Opus 5 是 30.0%、Fable 5 是 21.4%,Anthropic 自己重跑得到 29.0% 和 24.7%,兩者都算在誤差範圍內。23.6 分的領先遠大於誤差,這個結論站得住;但那些 2 到 4 分的差距,在類似的誤差下就沒那麼穩了。Anthropic 沒有公布其他測試的誤差,所以我無法判斷哪幾列在統計上真的有差。
OSWorld 2.0 不能跟舊分數比。 註腳說這次用的是測試作者 2026 年 8 月釋出的題目,跟先前的版本不同,所以表上沒有列競爭對手的分數。
再加一條發布頁沒寫的。到我重寫這篇的 10 月 13 日為止,我找不到獨立機構對 5.1 的完整評測。這跟上一代的經驗有關:The Batch 在 6 月的報導整理過,Fable 5 上線時,Artificial Analysis 記錄到約 8% 的題目被轉給 Opus 4.8,Vals AI 回報生物與資安題幾乎全數被拒答,ARC Prize 基金會則因為 30 天資料保留的規定,拒絕拿私有題庫來測。5.1 放寬了防護、也給了零資料保留的選項,照理說獨立評測會比較好做,但結果還沒出來。
Millennium 的當機故事,原話是什麼?
舊版標題用的那句話,出自投資公司 Millennium 一位只具名 Damien 的資深投資組合經理。發布頁上的完整引言是這樣的:某段程式有一個極罕見的當機,大約每一百萬次執行出現一次,團隊裡四到五年沒有人能解釋。他試過的每個模型都沒抓到,包括 Fable 5。Fable 5.1 是第一個找到的,做法是反組譯一個外部廠商的函式庫,拿去比對核心傾印(core dump),最後把當機追到那個函式庫裡的一個臭蟲。
這個故事的細節比「AI 抓到四年的 bug」有意思。問題不在 Millennium 自己的程式碼裡,在一個拿不到原始碼的第三方函式庫裡,要靠反組譯才看得到。引言的最後一句是:做這種分析要花的時間「很難說得過去」。意思是以前不是沒人會查,是不值得派人花幾週去查一個百萬分之一的當機。
要提醒的是,這是廠商發布頁上的客戶見證,同頁一共 22 則,全部正面。我無法驗證這個案例,也看不到被篩掉的負面回饋。Vellum 整理的早期使用者回報就沒那麼整齊:有人要求寫 1,000 字,模型交了 1,288 字;也有人說在最高努力程度下,被打斷之後它還會繼續做。
沒調基礎價,為什麼能省 25% 到 45%?
Fable 5.1 的基礎價格跟 Fable 5 一樣:每百萬輸入 token 10 美元、輸出 50 美元。唯一的變動是快取讀取,也就是模型重讀已經處理並存起來的內容時的收費,從每百萬 token 1 美元降到 0.25 美元,降幅 75%。token 計價的基本概念可以看詞彙表。
Anthropic 說一般工作負載大約省 25%,高度代理式的工作最多省到約 45%,並附了一張圖。
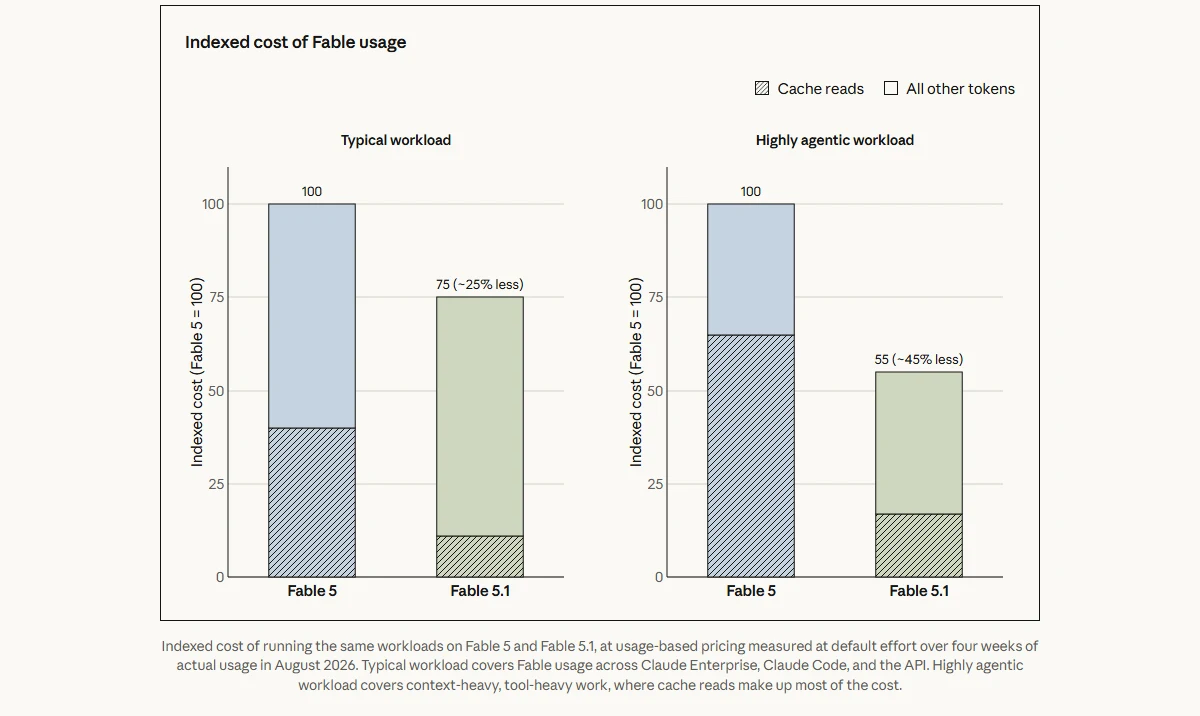 圖 3:斜線部分是快取讀取的花費,依 2026 年 8 月四週實際用量計算(來源:Anthropic)
這兩個數字可以反推。只有快取讀取降價 75%,其他都不變,那麼省下的比例就等於「快取讀取占帳單的比例」乘上 0.75。省 25%,表示快取讀取原本占帳單約 33%;省 45%,表示占約 60%。
所以判斷自己能省多少,不用等帳單,看一下現在的用量明細裡快取讀取占多少錢就行。長時間跑的程式代理每一輪都要把整段對話和工具結果重讀一遍,快取讀取會占大宗,省得多。如果你主要是單次問答,幾乎沒有快取讀取,這次降價對你等於沒有。
有一點我對不上。圖上 Fable 5 的斜線部分,目測一般負載約四成、代理式負載約六成五,比我反推的 33% 和 60% 高。可能的解釋是 Fable 5.1 在其他 token 上的用量跟 Fable 5 不同,但發布頁沒有給出底層數字,我只能把落差記在這裡。
發布頁還提到一個省錢的方向:把 Fable 5.1 的努力程度調到低或中,可以用低得多的成本拿到跟 Fable 5 相近或更好的結果。預設值在 Claude Code 是高,在 Claude.ai 和 Cowork 是中。Cognition 的說法可以當旁證:他們在上線當天把 Devin 裡原本跑 Opus 5 的流量搬到 Fable 5.1,理由是新的快取價格讓 Fable 級模型「終於划算」,先從程式碼審查開始。舊版把這句話寫成「全部切過來」,原文講的是 Opus 5 的流量,而且是從特定工作開始。
想比較其他家的價格,本站有一篇 DeepSeek V4 Pro 對 Fable 5 的價差整理,那篇用的是 Fable 5 的價格,快取讀取這一項現在要改用 0.25 美元來算。
三項科學成果,各是哪個模型做的?
發布頁的科學段落列了三項成果,分屬兩個版本。舊版標題寫「分身 Mythos 還重繪了金星地圖」,這是錯的。
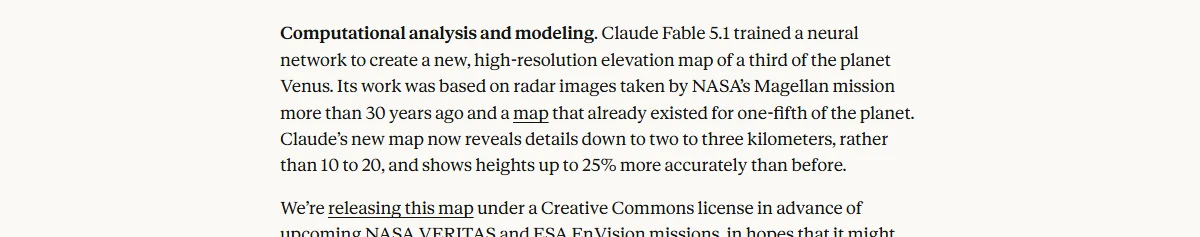 圖 4:發布頁原文,主詞是 Claude Fable 5.1(來源:Anthropic)
原文寫得很清楚:Claude Fable 5.1 訓練了一個神經網路,用 NASA 麥哲倫號三十多年前拍的雷達影像,加上一份已經涵蓋金星五分之一的既有地圖,做出涵蓋金星三分之一的新高程圖。細節從 10 到 20 公里提升到 2 到 3 公里,高度的準確度最多改善 25%。這份地圖以創用 CC 授權釋出,趕在 NASA 的 VERITAS 和歐洲太空總署的 EnVision 任務之前,希望幫任務團隊挑選觀測目標。
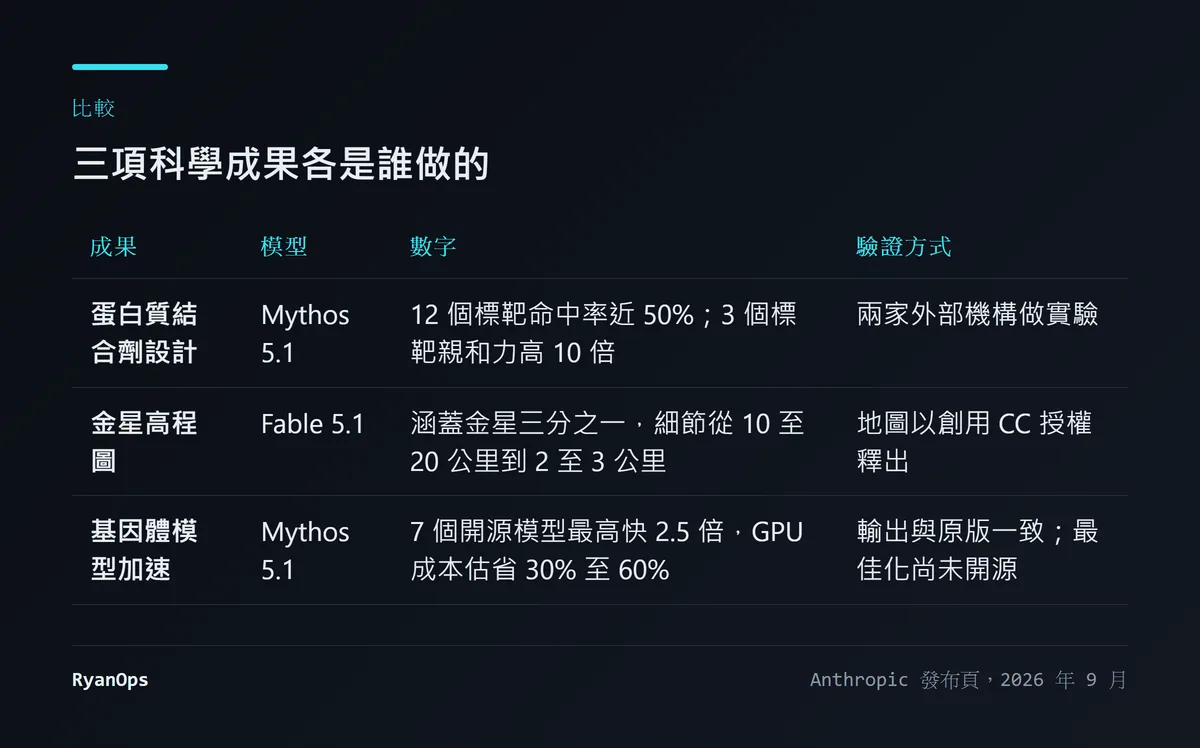 圖 5:三項成果、對應的模型與驗證方式(資料來源:Anthropic)
另外兩項是 Mythos 5.1 做的。分子設計這一項,Anthropic 讓模型使用開源的蛋白質設計與摺疊工具,把設計送到兩家外部機構做實驗驗證。12 個標靶的命中率接近 50%,發布頁說目前常見的水準是 10% 到 15%。舊版寫「結合力比競賽對手高出 10 倍」,少了限定條件:那是 12 個標靶中的 3 個(EGFR、Nipah G、15-PGDH),比的是 Adaptyv Bio 蛋白質設計競賽裡最好的投稿。註腳還自己補了一句,Nipah G 這個標靶上,另一位參賽者針對不同區域的設計達到了跟 Anthropic 最佳結果相當的親和力。
計算生物學這一項,Mythos 5.1 替七個開源的蛋白質與基因體模型寫了自訂的 GPU 核心並快取中間結果,在 NVIDIA H100 上最高快 2.5 倍,輸出與原版相同。七個模型的加速是 1.4 到 2.5 倍,只有 ProGen2 到 2.5 倍,多數落在 1.4 到 1.8 倍。全基因體分析的 GPU 成本「估計」降低 30% 到 60%。這些最佳化發布頁說「很快」會開源,我寫這篇時還沒查到。
三項裡面,金星地圖是你今天就能下載檢驗的;蛋白質結果有外部實驗背書但尚未看到論文;模型加速要等開源才能重現。
防護和存取改了什麼?
這一段舊版有幾處寫得太滿,逐項更正。
資安防護方面,舊版寫「誤判率降低 60%」。發布頁的講法是,Claude Code 使用者每個工作階段遇到資安防護介入的次數平均減少約 60%。原因之一是 Fable 5.1 現在可以用來找軟體弱點。它仍然不能拿來開發攻擊程式,滲透測試、漏洞利用產生、以二進位檔為基礎的弱點掃描這幾類工作,還是會被轉給 Opus 模型。
生物防護方面,針對基礎生物與醫療問題的誤擋比 Fable 5 剛上線時少了 85%,但生命科學研發類的問題仍然轉給 Opus。
Mythos 5.1 的存取有兩條路。資安驗證計畫(CVP)目前提供的還是防護較寬的 Opus 與 Sonnet 級模型,Mythos 級模型是「不久後」加入。生命科學驗證計畫(LSVP)已經跟美國政府合作收了第一批參與者。目前只有一部分美國機構能用,Anthropic 說正在跟美國政府協調擴大到更多國內外夥伴。
企業資料保留方面,Enterprise Frontier Safeguards(EFS)把資料存在客戶自己控制的雲端,人工審查預設由客戶自己做,從今年秋天起分階段推出。在那之前,符合資格的客戶可以用零資料保留的方式使用 Fable 5.1。
防蒸餾方面,從發布當天起新開的 API 帳號,不能再一邊手動修改多輪對話裡 Claude 先前的內容、一邊保留它先前的思考紀錄。既有帳號目前不受影響,但未來的模型會適用到所有人。如果你的整合有改寫歷史訊息的做法,這一條值得現在就去看 Anthropic 的說明文件。
最後是浮水印。Anthropic 在 2026 年 7 月簽了歐盟 AI 法案的生成內容透明度行為準則,8 月 2 日之後發布的模型,輸出文字都帶有統計式的浮水印。偵測 API 目前是私人預覽,開放給主管機關、執法單位、媒體、事實查核者、獨立研究者等對象。
我的判斷,以及什麼會讓我改變看法
我對 Fable 5.1 的看法是:它是一次扎實的補強,加上一次實質的降價,還稱不上全面的世代跳躍。科學研究代理那 23.6 分是真的大幅領先;其他項目是把 Fable 5 落後 Opus 5 的地方補回來,再往前推幾分。對多數開發者,快取讀取降價 75% 比任何一列分數都更直接。
什麼會讓我改變看法?如果 Artificial Analysis、Vals AI 這類獨立機構在不被防護打斷的情況下測出跟官方表相近或更大的差距,我會把「幾分的領先」看得更重。如果金星地圖被行星科學家拿去用、或蛋白質結果出現在同儕審查的論文裡,科學那一段就不只是廠商展示。反過來,如果獨立評測顯示防護介入的比例仍然很高,或是使用者普遍回報實際帳單沒有降到 25%,我會把評價往下修。
還有一件事我沒辦法替你判斷:我沒有在這篇文章裡實測 Fable 5.1。上面所有分數與案例都來自 Anthropic 的發布頁和兩篇第三方整理,沒有一個是我自己跑出來的。
這次改寫更正了什麼
- 金星地圖的主詞錯了。 舊版標題與內文都寫是 Mythos 5.1 做的,發布頁寫的是 Claude Fable 5.1,範圍是金星的三分之一。
- Terminal-Bench 4.0 的數字沒有交代版本。 60.9% 是 Mythos 5.1,一般可用的 Fable 5.1 是 55.8%。
- 「結合力高 10 倍」少了條件。 那是 12 個標靶中的 3 個,對象是 Adaptyv Bio 競賽的最佳投稿。
- 「誤判率降低 60%」不準確。 原文是 Claude Code 每個工作階段的資安防護介入次數平均減少約 60%。
- Cognition 的引言被寫大了。 原文是把 Devin 裡 Opus 5 的流量搬過來,從程式碼審查開始。
- CVP 的現況寫錯。 Mythos 級模型尚未納入資安驗證計畫,發布頁說的是不久後。
- 補上舊版沒有的內容。 以 Opus 5 為基準的差距計算、防護機制對分數的影響、標準誤與排行榜落差、快取占比的反推、獨立評測的缺口,以及 Millennium 引言的完整脈絡。


