DeepSeek V4 Pro 對 Fable 5:贏 2 項,便宜 23 到 57 倍
DeepSeek 沒發公告就上線 V4 Pro 正式版,還附了一張跟 Claude Fable 5 並排的成績表。逐項拆開這張表、算清楚「便宜 46 倍」怎麼來的,以及它沒告訴你的事。
8 月 12 日深夜,DeepSeek 把 V4 Pro 的正式版放上線。沒有發表文章,沒有公告頁面。唯一流出來的是一張成績表,上面把自己跟 Anthropic 最貴的模型 Claude Fable 5 擺在同一列。
八月的時候我照著報導寫了一個標題:「輸 5%、卻便宜 46 倍」。兩個數字都抓人,也都經不起細問。5% 是哪幾項的平均?46 倍是怎麼算的?
這次模型卡已經公開在 Hugging Face 上,我可以直接對著原始表格算。算完的結論是:這兩個數字都算得出來,但各自只是好幾種算法裡的一種。
這張表是怎麼流出來的?
先講流傳的路徑,因為它本身就很不尋常。開發者 Simon Willison 在 8 月 12 日記下了他看到的過程:
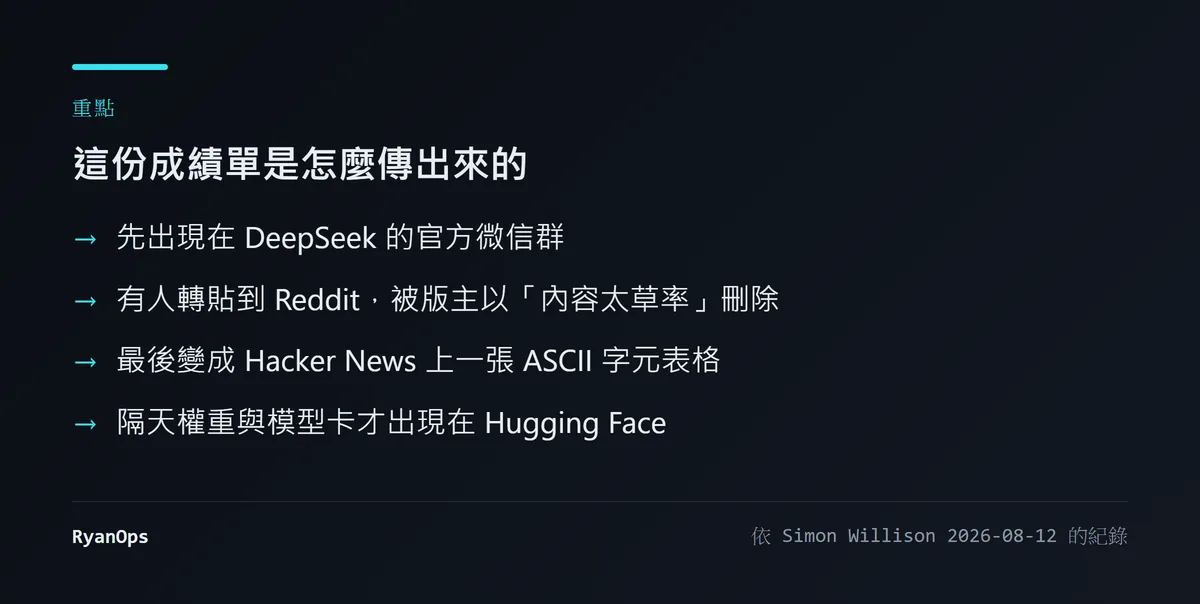 圖:V4 Pro 0813 成績單的流傳路徑(本文整理,依 Simon Willison 2026-08-12 的紀錄)
數字先在 DeepSeek 的官方微信群出現。有人貼到 Reddit,被版主以「low-effort」(內容草率)刪掉。最後它以一張 ASCII 字元拼成的表格出現在 Hacker News。
Willison 自己是從 OpenRouter 發現新版本的。他特別註明,他的連結之所以指向 OpenRouter,是因為 DeepSeek 沒有任何明顯的發表頁面。
一家做出兆級參數模型的公司,旗艦轉正的消息靠微信群截圖跟 ASCII 表格傳到西方開發者手上。這件事我到現在還是覺得有點荒謬。不過隔天權重跟模型卡就上了 Hugging Face,所以下面的數字我是對著正式的模型卡讀的,不是對著那張 ASCII 表。
表上到底寫了什麼?
這是模型卡上的原表:
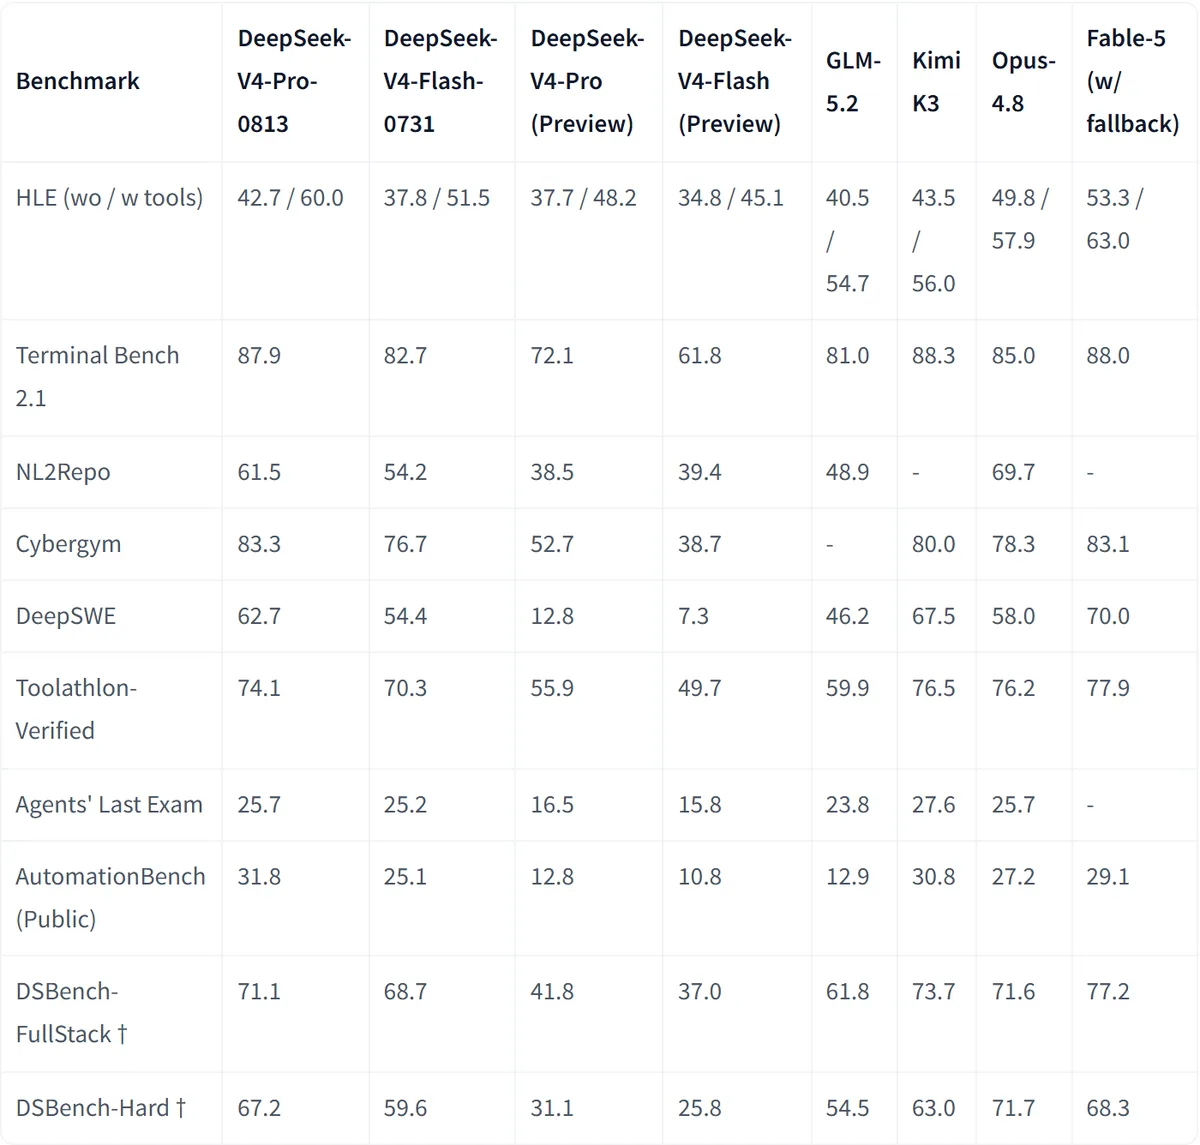 圖:DeepSeek-V4-Pro-0813 模型卡上的評測表(來源:huggingface.co)
十項測試,八個模型。最右邊那欄是 Fable-5,後面括號寫著「w/ fallback」。這個標註的確切意思模型卡沒有解釋,我也不確定,所以只照原樣列。
十項裡有兩項 Fable 5 沒有分數(NL2Repo 跟 Agents’ Last Exam),能直接比的是八項。我把這八項的差距算出來:
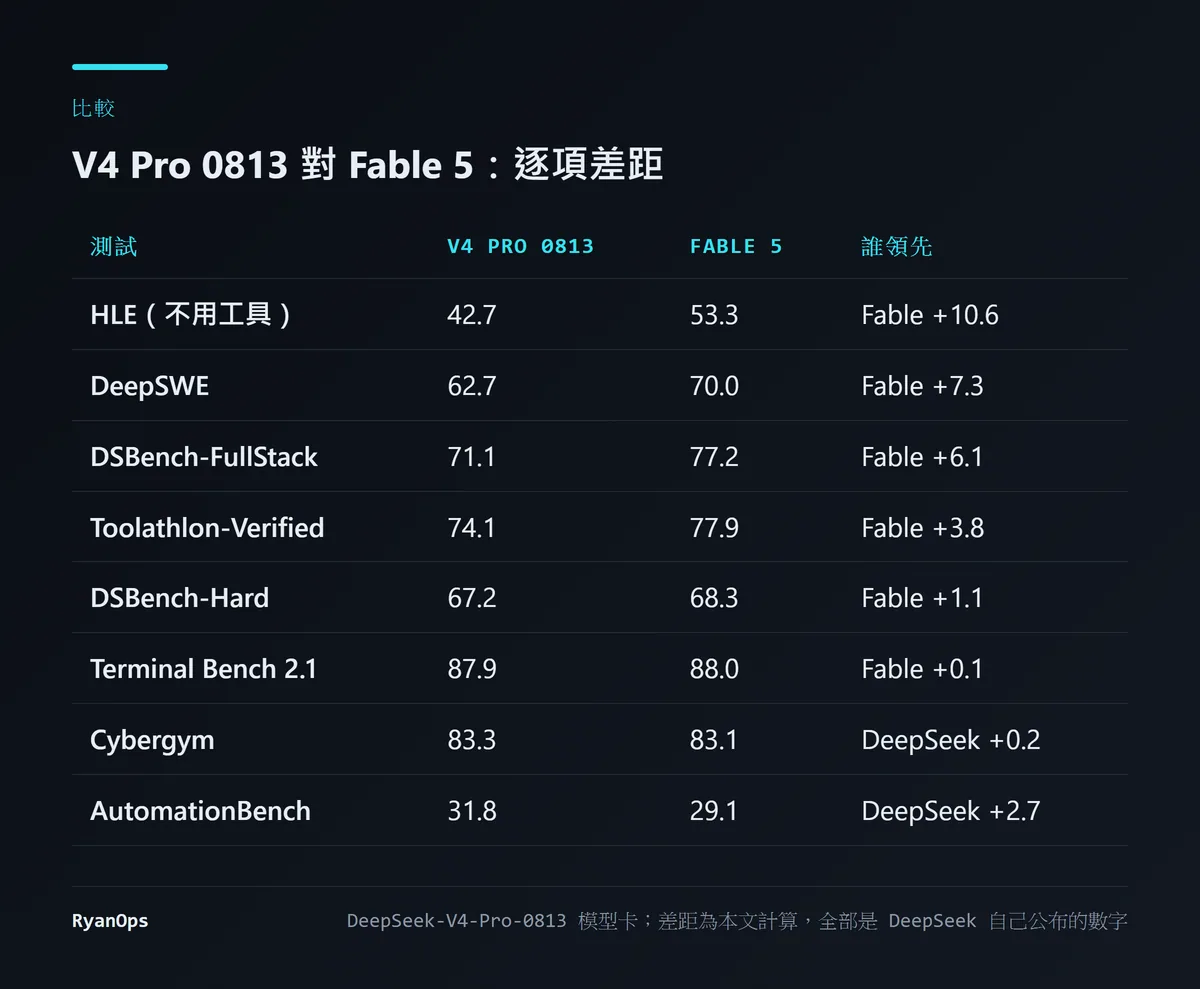 圖:V4 Pro 0813 對 Fable 5 的逐項差距(本文計算,原始分數出自 DeepSeek-V4-Pro-0813 模型卡,全部為 DeepSeek 自行公布)
DeepSeek 贏兩項:Cybergym(83.3 對 83.1)跟 AutomationBench(31.8 對 29.1)。前者差 0.2 分,說是平手比較準確。
另外兩項幾乎沒差:Terminal Bench 2.1 輸 0.1,DSBench-Hard 輸 1.1。
真正拉開的是三項:HLE 輸 10.6,DeepSWE 輸 7.3,DSBench-FullStack 輸 6.1。
HLE 那一列其實有兩個數字。我用的是不開工具的成績。開了工具之後是 60.0 對 63.0,差距縮到 3 分。
「輸 5%」是怎麼算出來的?
這裡有兩種算法,會得到不同的數字。
算分數差的平均。 八項的差距加起來是 26.1 分,除以八,平均 Fable 5 領先 3.3 分。
算相對百分比的平均。 把每一項寫成「Fable 5 比 DeepSeek 高百分之幾」再平均。HLE 那一項是 53.3 對 42.7,相對高了 25%,會把平均拉得很高。這樣算出來大約是 5%。八月報導裡的 5.3% 應該是這種算法。
兩種都不算錯。我自己比較偏好第一種,因為這些測試的滿分不一樣、難度不一樣,把「42 分到 53 分」跟「88 分到 88 分」換成百分比再平均,等於讓低分的測試權重特別大。
還有一個當時常被引用的說法:把 HLE 拿掉,差距會縮小很多。這是真的。拿掉 HLE 之後,剩下七項的平均分差是 2.2 分。
但我覺得「拿掉差最多的那一項」這個動作要小心。HLE 考的是知識跟推理,其他九項幾乎都是代理任務,要模型動手做事。所以比較公平的說法是:在動手做事的測試上,兩者很接近;在純粹考腦袋的測試上,Fable 5 明顯領先。 這是兩個不同的結論,不該被平均成一個數字。
八月那篇還寫了 SWE-bench Verified 上 Fable 5 是 96%、V4 Pro 是 80.6%。那個 80.6% 是四月預覽版的成績,0813 的模型卡上沒有這一項,我已經把這組比較拿掉。
這張表沒強調的事
盯著 Fable 5 那一欄看,很容易漏掉旁邊兩欄。
Kimi K3 在好幾項上比 V4 Pro 高。 Terminal Bench 2.1 是 88.3 對 87.9,DeepSWE 是 67.5 對 62.7,Toolathlon 是 76.5 對 74.1,DSBench-FullStack 是 73.7 對 71.1。DeepSeek 把這些數字自己列在表上,沒有藏。但我讀到的報導,包括我自己八月那篇,標題寫的都是「DeepSeek 對 Fable 5」,沒有一篇寫「DeepSeek 在自己的表上輸給另一個中國模型」。
照表上的數字,K3 在十項裡有六項比 V4 Pro 高,V4 Pro 贏的是 Cybergym、AutomationBench 跟 DSBench-Hard。
對 Opus 4.8 是互有勝負。 DeepSeek 贏 Terminal Bench、Cybergym、DeepSWE、AutomationBench 四項,輸 HLE(不用工具)、NL2Repo、Toolathlon 跟兩項 DSBench,Agents’ Last Exam 同分。
有兩項是 DeepSeek 自己出的題。 表格下方的註記寫明,DSBench-FullStack 跟 DSBench-Hard 是內部測試集。廠商在自己出的考卷上跟別人比,參考價值要打折。
DeepSeek 用的是自家的代理框架。 同一則註記寫,公開測試裡的程式代理任務,V4 Pro 是用 DeepSeek Harness 的 minimal 模式、max 推理強度跑的。代理測試的分數有一部分來自框架本身,換一套框架,數字可能不一樣。
還有一點我沒辦法從表上判斷:其他模型的分數是誰量的。模型卡沒有說對手的數字是 DeepSeek 自己跑的,還是引用各家公布的。
「便宜 46 倍」又是怎麼算的?
這個數字也是真的,同樣只是其中一種算法。
Fable 5 的價格我是從 Anthropic 的定價文件讀的:輸入每百萬 token 10 美元,輸出 50 美元。V4 Pro 轉正當下的價格,依 Unite.AI 引述的定價頁,是輸入 0.435 美元、輸出 0.87 美元。
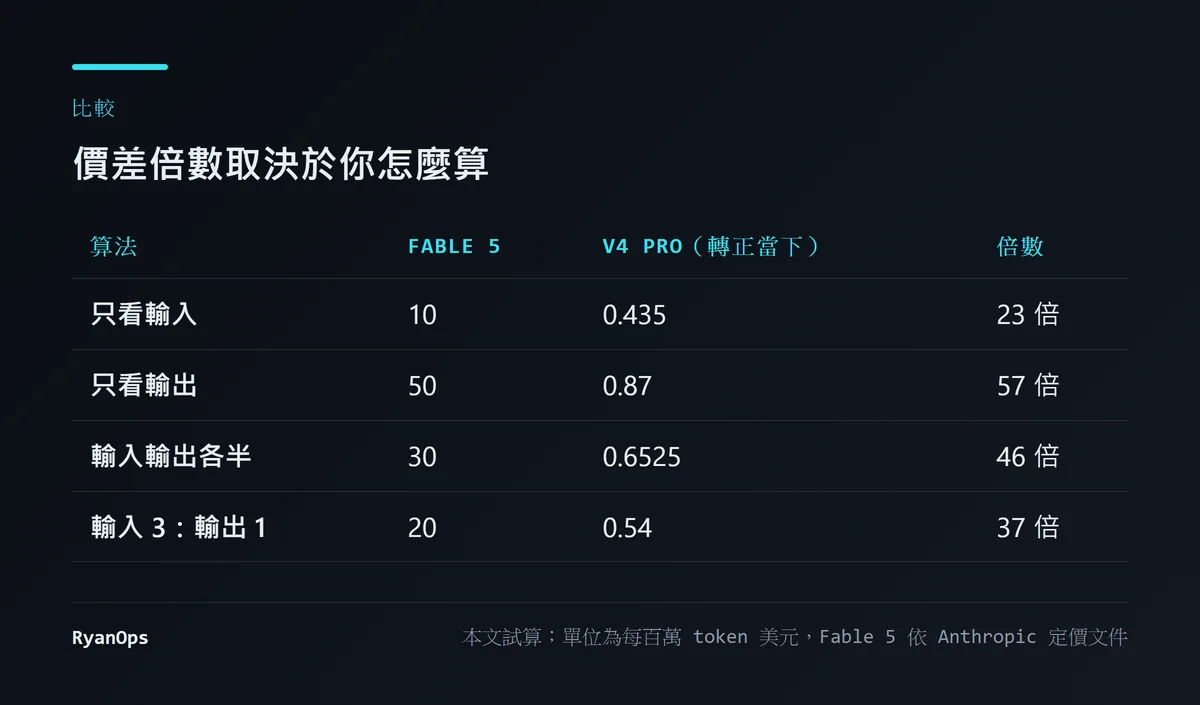 圖:不同算法下 Fable 5 與 V4 Pro 的價差倍數(本文試算,單位為每百萬 token 美元)
只看輸入差 23 倍。只看輸出差 57 倍。46 倍是把輸入跟輸出各算一半得到的:30 美元對 0.6525 美元。
實際上很少有工作負載是一半一半。寫程式的代理通常讀得多、寫得少,輸入的 token 是輸出的好幾倍。如果用三比一來算,倍數是 37。
所以比較誠實的講法是「便宜 23 到 57 倍,看你的輸入輸出比例」。這也是我這次改標題的原因。
更重要的是,這個價差只存在了四天。DeepSeek 在 8 月 13 日宣布調價,8 月 16 日生效。調整後 V4 Pro 的輸出是離峰 1.98 美元、尖峰 3.96 美元。用新價格重算,輸出的價差是 13 到 25 倍,還是很大,但已經不是 57 倍。這段經過我寫在同一天的另一篇跟調漲那篇。
人民幣的定價我也對過。Wayback Machine 在 8 月 13 日存下來的定價頁上,V4 Pro 是快取命中 0.025 元、未命中 3 元、輸出 6 元,V4 Flash 是 0.02 元、1 元、2 元,跟八月報導寫的一致。
還有什麼值得知道的?
Willison 的紀錄裡有一個我覺得很實用的觀察。他用同一個提示詞,在 V4 Pro 的低、中、高三種推理強度下各跑一次,得到的結果差異非常大。他說這種程度的差別,他沒有在其他模型上看過。
模型卡上的檔位名稱跟他寫的不完全一樣。卡上寫 reasoning_effort 支援 low、high、max 三檔,沒有 medium,我這裡照各自的原文列。可以確定的是,程式代理類的測試都是用 max 跑的。
這對你的意義是:表上的分數是最高強度的成績。最高強度會產生更多思考用的 token,那些 token 是照輸出價格計費的。所以實際跑起來,你要嘛付比標價多的錢去拿表上的表現,要嘛用比較低的強度、拿比較低的表現。「便宜 46 倍」跟「只輸 5%」這兩句話,不一定能在同一個設定下同時成立。
這一點我沒有實測數據可以量化,只能提醒你自己測的時候把推理強度當成一個變數。
所以該怎麼看這場比較?
我的看法是,這張表說明了一件事,也只說明了一件事:在代理類的任務上,開放權重的模型已經追到離最貴的封閉模型很近的地方。Terminal Bench 差 0.1 分這種結果,一年前很難想像。
它沒有說明的是你的工作換過去會不會一樣好。原因前面都講了:分數是廠商自己公布的、兩項是內部考題、跑的是最高推理強度、差距最大的那項剛好是唯一不考動手能力的。
什麼會讓我比較有把握?獨立機構用同一套設定把兩個模型都跑一遍,並且公布每一項任務實際花了多少錢。價格表上的倍數是每個 token 的價差,你真正在意的應該是每完成一件事的價差。
這件事後來的發展也值得一提。九月 DeepSeek 推出 V4.1 Flash,輸出價壓到更低,Anthropic 的定價文件上也多了 Fable 5.1。這張表比的兩個模型,現在都不是各自最新的了。開放權重這個詞的意思可以看名詞解釋。
這次改寫更正了什麼
- 原文的「輸 5.3%」沒有說明算法。這次列出兩種算法與各自的結果(平均分差 3.3 分,相對百分比約 5%)。
- 原文的「便宜 46 倍」是輸入輸出各半的算法。這次列出四種比例,並把標題改成範圍。
- 原文引的 SWE-bench Verified 比較(96% 對 80.6%)用的是預覽版的分數,已刪除。
- 原文轉引了 Artificial Analysis 的單次任務成本(3.15 美元對 0.03 美元),而且比的是 V4 Flash,不是 V4 Pro。我這次沒有找到原始出處,已刪除。
- 原文對 Fable 5 的規格描述(發表日期、輸出長度)這次沒有重新查證,只保留從 Anthropic 定價文件確認過的價格。
- 原文說 0813 權重是否釋出尚未確認。權重在 8 月 13 日已上架 Hugging Face。


