不輸出文字的模型 Jev:24 天估值翻 37 倍,官方圖表上準確率約 68%
TypeSafe AI 的 Jev 只回傳帶機率的型別結果。讀完官網與文件後更新:10 月 9 日 A 輪估值 75 億美元,官方圖表上準確率約 68%,並自己列了九種失敗模式。
2026 年 9 月 15 日,舊金山新創 TypeSafe AI 結束兩年的隱身期,發表一顆不會生成文字的模型 Jev。你把一段資料和幾道結構化的問題丟給它,它回傳帶機率的型別結果:一個是非題的機率、一個從清單裡挑出來的選項,或一個落在你自訂級距上的分數。公司把它定位成給軟體用的 AI。
本站 9 月 22 日寫過一版。那時候 Jev 還在候補名單階段,我依據的主要是 SiliconANGLE 的報導和二手整理。三個星期後情況變了不少:官網開放註冊,文件全部公開,公司在 10 月 9 日宣布了一輪 8.7 億美元的募資。這次重寫我把官網、發布文章和技術文件都讀了一遍,補上舊版沒有的東西,也更正兩處寫錯或查不到的地方。
先說結論:這顆模型的設計很有意思,官方對自家數字的保留也比多數公司坦白。可是「444 倍便宜」這類標題數字和官方自己圖表上「準確率約 68%」放在一起讀,才是完整的畫面。
這家公司在三個星期內發生了什麼?
TypeSafe AI 成立於 2024 年。執行長 Diogo Almeida 先前在 OpenAI 做過 RLHF、InstructGPT、ChatGPT 和 GPT-4,另外兩位共同創辦人是 Erik Gafni 和 Sasha Sheng。9 月 15 日出關時同步宣布 4,000 萬美元的種子輪,由 DCVC 領投;SiliconANGLE 轉述 Forbes 的報導說,這一輪的估值約 2 億美元。
舊版寫到這裡為止。接下來的事是這次才有的。
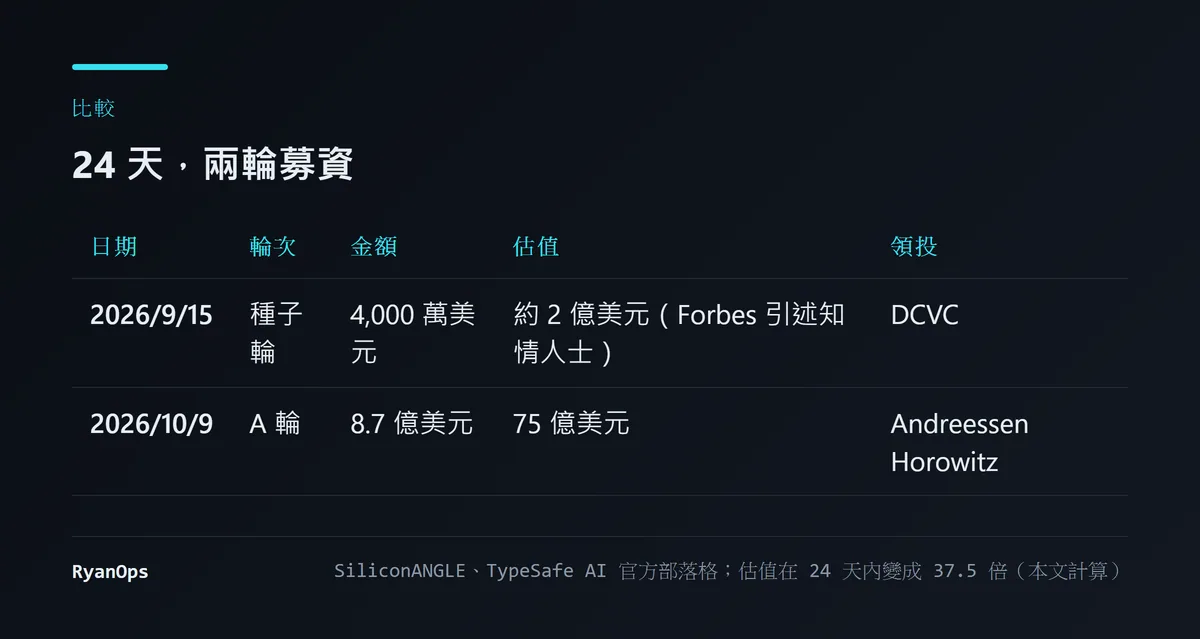 圖 1:24 天內的兩輪募資(資料來源:SiliconANGLE、TypeSafe AI 部落格)
10 月 9 日,TypeSafe 在官方部落格宣布 A 輪,由 Andreessen Horowitz 領投,Sequoia Capital 和既有投資人 DCVC 參與。文章正文刻意不寫數字,只說「一輪非常大的 A 輪」,數字放在註腳:8.7 億美元,估值 75 億美元,a16z 的 Martin Casado 加入董事會。
從 2 億到 75 億,24 天,37.5 倍。種子輪的估值來自 Forbes 引述的知情人士,所以這個倍數請當成量級。
同一篇文章還有兩個說法:財星 500 大企業有三分之一在用 Jev,以及已經替客戶在正式環境省下數百萬美元。公司沒有列出任何客戶名稱,我無法驗證。
Jev 到底怎麼運作?
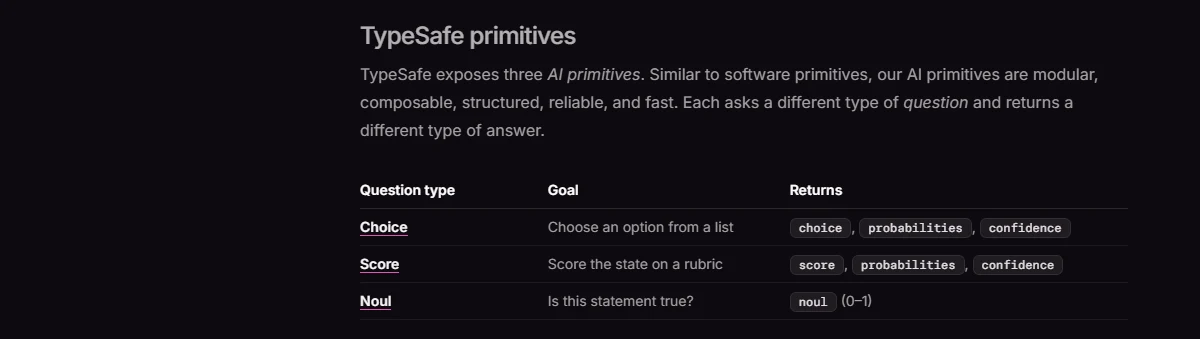 圖 2:官方文件列出的三種問題型別與回傳內容(來源:docs.typesafe.ai)
Jev 的 API 只接受三種問題,文件稱為 primitive。
Choice 是從你給的清單裡選一個,回傳選中的選項、每個選項的機率,以及一個信心值。發布文章說最多支援 255 個選項,選項多的時候會分兩階段處理。
Score 是依照你寫的評分標準,把資料放到有順序的級距上,回傳分數、每個級距的機率和信心值。
Noul 是問一句敘述成不成立,回傳一個 0 到 1 的機率。它沒有獨立的信心欄位。
三種問題可以混在同一次呼叫裡。文件的說法是,每一道問題都針對同一份資料(文件叫 state)平行、彼此隔離地各算一次,所以多加幾道問題幾乎不影響回應時間。
這個設計帶來一個限制,文件自己講得很明白:每一道問題應該只問一件具體的事,像是「一個懂行的人看幾秒就能回答」的那種判斷。如果你想問的事需要長篇推理或同時權衡好幾個因素,就把它拆開,分別問,再用你自己的程式把答案組合起來。文件舉的例子是,不要問「幫這份創業簡報打分數」,改成分別問市場規模、技術可行性和差異化,再用你自己的公式加權。
信心值是整個設計的重點。訓練方法叫 RLCD(Reinforcement Learning for Calibrated Decisions),目標是讓模型回報的機率跟實際的正確率對得上。對得上之後,你可以在程式裡設門檻:信心高就自動放行,中間的去要更多資料,低的轉給人處理。一般的大型語言模型被問到「你有多確定」時往往過度自信,這是 TypeSafe 認為它們難以用在自動化流程裡的原因。
名字的由來舊版寫對了。System One 取自 Kahneman 的快思與慢想,Jev 取自經濟學家 William Stanley Jevons。
「快 193 倍、便宜 444 倍」該怎麼讀?
這兩個數字放在官網首頁最顯眼的地方。值得稱讚的是,TypeSafe 在發布文章裡花了一整節替自己的數字加註,原文說非比尋常的主張需要非比尋常的證據。我把那些註記整理成一張表。
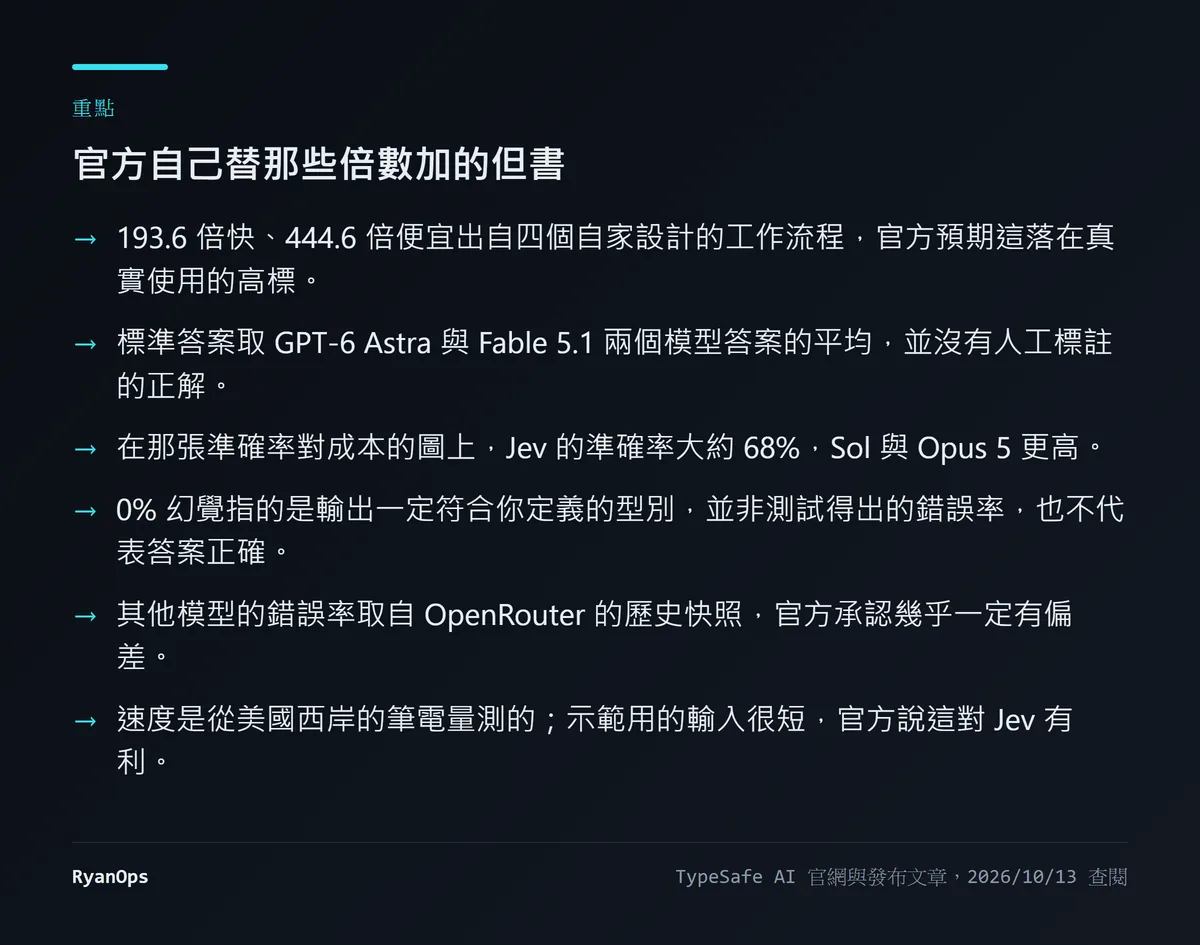 圖 3:官方自己寫的限制(資料來源:TypeSafe AI 官網與發布文章)
最要緊的是第二條和第三條。
這套評測沒有人工標註的正確答案。官方的做法是假設有一個正確的工作流程,然後拿「最大、最聰明、最貴的外部模型」的預測當參考,實際用的是 GPT-6 Astra 和 Claude Fable 5.1 兩者的平均。所以圖表上的「準確率」量的是「跟這兩個模型有多一致」。官方自己指出這會偏向 OpenAI 和 Anthropic 的模型。
在這個定義下,官網那張準確率對成本的圖,文字說明寫的是:Jev 是圖上成本最低的模型,準確率大約 68%;GPT-5.6 Terra 和 Claude Sonnet 5 準確率相近、成本較高;GPT-5.6 Sol 和 Claude Opus 5 準確率更高、成本也更高。底下還有一行:這些是工作流程評測的結果,不代表在每一種任務上的準確率。
舊版沒有寫 68% 這個數字。它改變了整件事的讀法:Jev 的賣點是在中階模型的準確度上便宜兩個數量級,它並沒有宣稱比旗艦模型準。
「零幻覺」也要照官方的定義讀。官網的原話是,Jev 的 0% 代表它保證輸出符合定義好的結構,這個數字並非從測試中觀察到的錯誤率;那些圖表談的是輸出格式和工具呼叫的錯誤,跟答案對不對無關。答案仍然可能是錯的。
價格方面有一個前後不一致的地方。9 月的發布文章寫:我們無法證明價格沒有被補貼,需要長時間才能證明定價可以持續。我在 10 月 13 日看到的官網常見問題則寫:我們能以目前的價格在獲利的情況下提供 Jev。兩句話隔了不到一個月,中間多了一輪 8.7 億美元的募資。哪一句比較接近實情,外人無從判斷。
獨立的量測目前很少。我找到一個比較接近的:Spring 官方部落格 9 月 21 日介紹 Spring AI 的 TypeSafe 整合時,回報的中位數延遲是問一道問題 275 毫秒、問三道 310 毫秒。這落在官方說的 70 到 500 毫秒範圍內,也印證了「多問幾道幾乎不變慢」,但它沒有量準確率。
官方說它不擅長什麼?
舊版寫到「需要推理和生成的任務不適合」就停了。文件裡其實有一整頁叫「Jev 1.13 jaggedness」,逐條列出已知的毛病,最後檢視日期是 10 月 2 日。
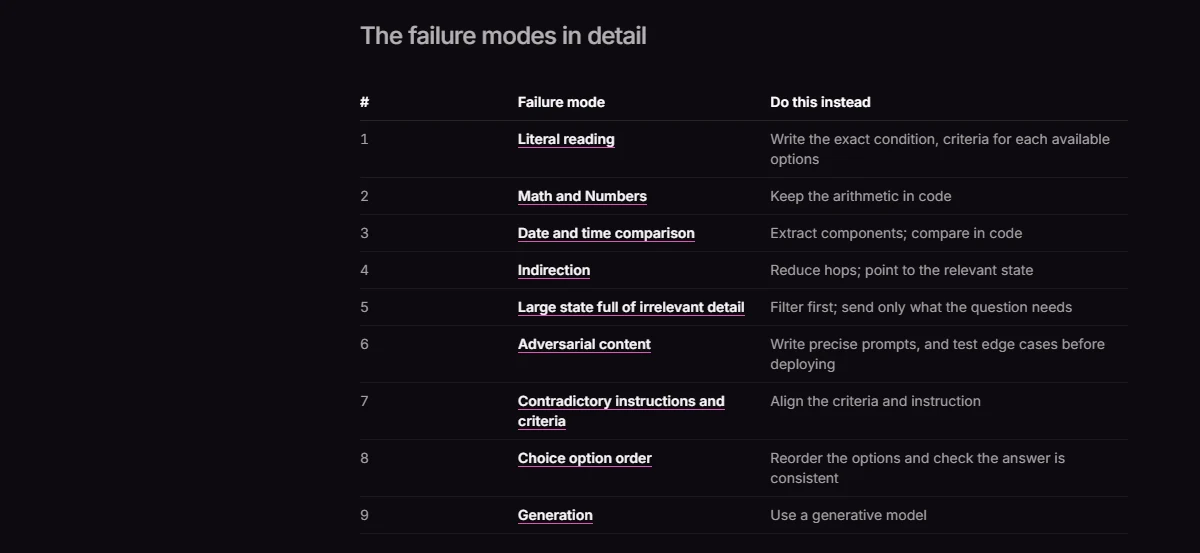 圖 4:jev-1.13 的九種已知失敗模式與官方建議(來源:docs.typesafe.ai)
有幾條對實際使用影響很大。
它照字面回答。文件的說法是,它回答你寫下的問題,不會去猜你真正想問的事;範圍詞、否定詞和隱含的條件都照字面讀。
它不會算數。文件直接寫「Jev 不是計算機」,數一個字裡有幾個字母、一段話裡某個詞出現幾次、一長串清單有幾項,都不可靠。建議是把計數和算術留在程式裡。
它把日期當成文字。兩個日期誰先誰後、相隔多久、有沒有落在某個區間,都不可靠。
選項的順序會影響 Choice 的答案。文件建議調換順序再問一次,看答案是否一致。這一條對一個主打「一致性」的模型來說是值得留意的坦白。
還有一條文件放在另一頁,對中文使用者特別重要。模型頁的語言支援寫著:英文是主要的訓練語言,準確度目前最好;其他語言包括中日韓文字可以處理,但表現不一樣好,建議先用自己的內容測試,並且在分流時特別注意信心值。我沒有實測 Jev 的中文表現,官方也沒有公布任何非英文的數字。
現在怎麼用,要多少錢?
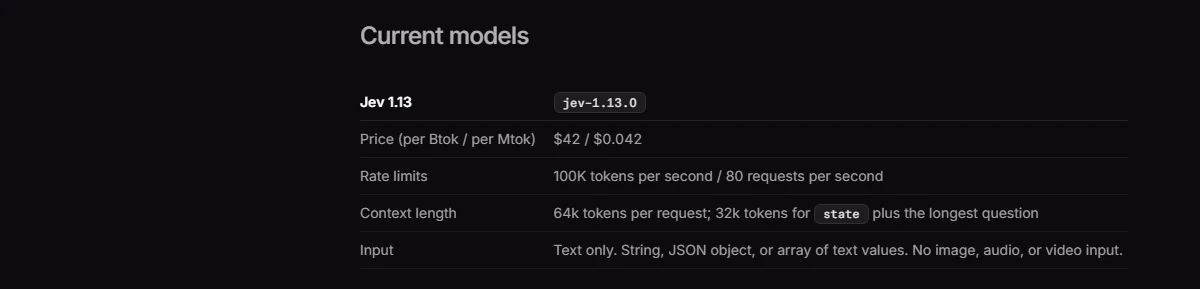 圖 5:目前的模型規格,2026 年 10 月 13 日擷取(來源:docs.typesafe.ai/models)
價格跟舊版寫的一樣:每百萬輸入 token 0.042 美元,輸出不收費。官網的對照表上,Claude Haiku 4.5 是輸入 1 美元、輸出 5 美元,GPT-5.6 Luna 是 0.20 和 1.20 美元。
其他規格有更新。目前的版本是 jev-1.13.0。單次請求的上限是 64k token,其中資料加上最長的那道問題不能超過 32k。速率限制是每秒 10 萬 token 或 80 次請求,文件加了警語說限制會隨需求動態調整。只接受文字輸入,圖片、聲音、影片要先自己轉成文字。
客製化的方式也跟一般模型不同。文件說 Jev 不做微調,也不用客戶資料訓練,所有帳號用的是同一組權重;你只能透過放進請求的資料和問題的寫法來調整它的行為。
取得方式有兩處要更正。舊版寫只能排候補名單,現在官網首頁有註冊按鈕和 API 主控台,提供 Python 和 JavaScript 的 SDK。舊版還寫 Cloudflare Workers AI 以 typesafe/jev 這個代號提供這顆模型。我在 10 月 13 日打開 Cloudflare 的模型目錄,找不到 Jev,頁面回覆這個模型「已棄用、已移除或不存在」。我不知道它是曾經上架後來下架,還是舊版引用的資訊本來就不對,所以這一句拿掉。Spring AI 的整合則確實存在,是一個社群專案,包了 TypeSafe 的託管 API。
模型的權重、參數量和訓練資料的細節仍然沒有公開,也沒有自架的選項。
我的判斷,以及什麼會讓我改變看法
我認為 Jev 想解決的問題是真的。在程式流程裡呼叫語言模型、再想辦法把 JSON 挖出來、然後處理它偶爾格式錯誤或答非所問,這一段確實又慢又脆弱。一個保證型別正確、附帶校準過的機率、延遲在幾百毫秒內的元件,對分類、路由、審核這類高頻的小判斷很有吸引力。
我保留的地方有兩個。第一,目前所有的準確率數字都來自 TypeSafe 自己設計的評測,而且「準確」的定義是跟兩個大模型一致。校準這件事尤其需要獨立驗證,因為整個設計的價值建立在「信心值可以相信」上。第二,75 億美元的估值建立在公司自己說的採用數字上,而那些數字沒有一個具名客戶。
還有一個發表之後的變化要記一筆。我在 10 月 13 日查 OpenAI 的 API 更新紀錄時看到,OpenAI 在 10 月 6 日以 gpt-6-luna 推出了 Decisions API 的測試版,說明是「把文字和圖片變成型別化的答案,比 Responses API 快 10 倍」。這跟 Jev 做的是同一類事,距離 Jev 出關只有三個星期。我還沒有看到兩者的比較,但 TypeSafe 往後面對的已經不只是「語言模型不適合做這件事」這個論點,還有大廠自己下場做的同類產品。
什麼會讓我改變看法?如果有獨立團隊用人工標註的資料集測出 Jev 的信心值確實跟正確率對得上,我會把它從「有意思的設計」升級成「可以放進正式流程的元件」。如果有具名的大型客戶公開說明用它取代了什麼、省了多少,那三分之一財星 500 大的說法就有了支撐。反過來,如果半年後價格調漲,或是中文這類非英文工作負載的實測明顯較差,我會建議中文團隊先觀望。
如果你現在就想試,我的建議是照文件的話做:拿你自己的資料,挑一個單純的分類或是非判斷,先量信心值跟你人工標註的結果對不對得上,再決定門檻。不要用官網的倍數去估預算。
這次改寫更正了什麼
- Cloudflare 上架的說法拿掉了。 舊版寫 Workers AI 以
typesafe/jev提供模型。我在 10 月 13 日查 Cloudflare 的模型目錄找不到,無法確認這件事曾經為真。 - 取得方式更新。 舊版寫只能排候補名單。官網現在開放註冊並提供 API 主控台。
- 規格更新。 舊版引用的上下文長度是 32K。官方文件寫的是單次請求 64k、資料加最長問題 32k。
- 補上 68% 這個數字。 官網圖表的說明寫 Jev 的準確率約 68%,而且這個準確率是相對於兩個大模型的平均,舊版沒有寫。
- 補上 A 輪。 10 月 9 日宣布 8.7 億美元、估值 75 億美元,距離種子輪 24 天。
- 新增內容。 官方列出的九種失敗模式、非英文語言表現較差的說明、補貼問題上前後不一致的兩個說法、不做微調的設計,以及 Spring 部落格回報的延遲數字。


