MySQL 資料庫分區完全指南:RANGE、LIST、HASH 全解析
把 MySQL 8.4 手冊的分區章節翻到底:四種分區類型怎麼選、分區裁剪何時失效、唯一鍵與外鍵兩個硬限制,以及沒有 INTERVAL 時怎麼自動補分區。
想像一張存了三年訂單的表,兩億多行。每天凌晨的清理排程跑 DELETE FROM orders WHERE created_at < '2023-01-01',鎖表鎖到早班的人進公司還沒結束,binlog 順便把磁碟灌滿。
這是資料庫分區(Partitioning)最典型的登場時機。這篇會從「它到底是什麼」一路講到「什麼時候你不該用」。寫的過程中我把 MySQL 8.4 手冊的分區章節逐頁重翻了一次,也去對了 PostgreSQL 的文件,下面每一條限制都附上出處;有兩個地方手冊寫的跟我原本的理解不一樣,我會直接講哪裡改了。
分區到底在解決什麼?
MySQL 手冊的定義很直接:這是水平分區(horizontal partitioning),把同一張表的「列」依規則分配到不同的實體分區。每個分區在檔案系統上是各自獨立的一塊,但邏輯上還是同一張表,你的 SQL 一個字都不用改。
先釐清一件常被搞混的事:MySQL 不支援垂直分區,也就是把不同「欄位」拆到不同儲存位置。網路上很多文章把兩者混著講,那是另一回事。
它真正值錢的地方有三個。
第一,單一張表可以放超過單顆磁碟容量的資料。
第二,刪舊資料變得非常便宜。與其對兩億行下 DELETE,你對整個分區下 ALTER TABLE ... DROP PARTITION,本質上是把底層檔案拿掉,不會產生一大包 undo log 跟 binlog。手冊提醒了一個小細節:做這件事需要該表的 DROP 權限,而且伺服器不會回報刪掉了幾列。
第三,分區裁剪(Partition Pruning)。查詢的 WHERE 條件有命中分區鍵時,MySQL 會直接跳過不可能符合的分區,只掃相關的那幾塊。
是不是每張表都能分區?
不是。從 MySQL 8.0 開始,只有 InnoDB 跟 NDB 兩種儲存引擎支援分區,MyISAM、MERGE、CSV、FEDERATED 全部不行。同一張分區表底下的所有分區也必須用同一種引擎。
如果你的專案還有幾張 MyISAM 的老表,第一步是先確認能不能轉 InnoDB。這個前置條件很容易被跳過,然後在 ALTER TABLE 那一步才發現。
四種分區類型,你該用哪一種?
我打開手冊的「Partitioning Types」那一頁,它用四段話把四種類型講完:
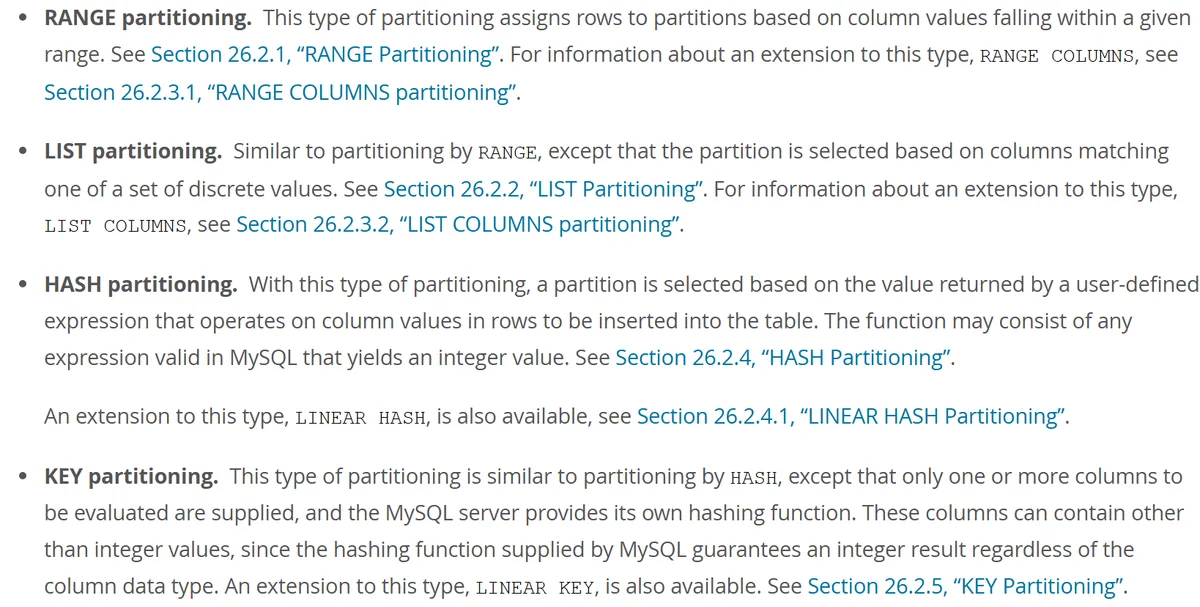 圖:MySQL 8.4 Reference Manual「Partitioning Types」頁面的類型清單(來源:dev.mysql.com)
原文是給已經懂的人看的。換成選型的角度,我整理成下面這張表:
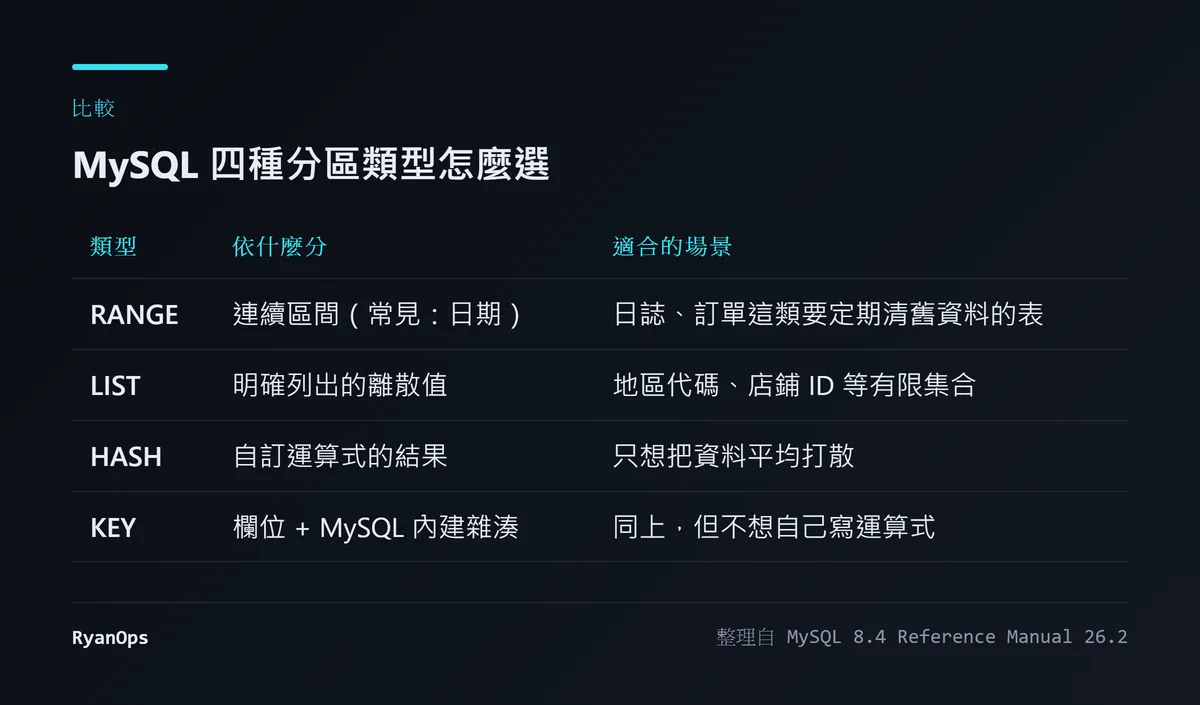 圖:四種分區類型的選型對照(本文整理,依據 MySQL 8.4 Reference Manual 26.2)
RANGE:時間序列資料的預設答案
RANGE 依欄位值的區間切資料,最常見的就是按日期切月或切年:
CREATE TABLE orders (
    id INT NOT NULL,
    created_at DATE NOT NULL,
    amount DECIMAL(10,2),
    PRIMARY KEY (id, created_at)
)
PARTITION BY RANGE (YEAR(created_at)) (
    PARTITION p2024 VALUES LESS THAN (2025),
    PARTITION p2025 VALUES LESS THAN (2026),
    PARTITION p2026 VALUES LESS THAN (2027),
    PARTITION pmax VALUES LESS THAN MAXVALUE
);
日誌、訂單、交易紀錄,這種「愈新愈常查、愈舊愈該清」的資料幾乎都是它。另外有個變體叫 RANGE COLUMNS,可以直接拿多個欄位、非整數型別(DATE、VARCHAR)來定義區間,不用先靠函式轉成整數。
LIST:有限、已知的分類
邏輯跟 RANGE 很像,只是依據換成一組明確列出的離散值,適合「依地區代碼」「依店鋪 ID」這種集合。同樣有 LIST COLUMNS 變體。
HASH 與 KEY:我只想把資料打散
你要的如果是「平均分散、別讓單一分區過熱」,HASH 會依你給的運算式(例如 HASH(id))算出分區。KEY 更省事,你只給欄位,雜湊函式由 MySQL 自己提供。兩者都有 LINEAR 變體,增減分區數時重新分配的成本比較低,代價是分布沒那麼均勻。
Subpartitioning:分區底下再分一層
可以先用 RANGE 依年份分區,每個年份裡再用 HASH 依使用者 ID 切一次。手冊對這層有兩條規定:子分區只能用 HASH 或 KEY,而且只有 RANGE 跟 LIST 分區能被再切。老實講,多數專案用不到這一層,複雜度上升得比好處快。
MySQL 沒有 INTERVAL,那分區要怎麼自己長出來?
Oracle 有 INTERVAL 分區,新月份的資料一寫進來,資料庫自己幫你開新分區。MySQL 原生沒有這個東西。RANGE 分區的邊界必須事先存在,資料落在所有既有分區之外時,INSERT 直接失敗。
所以只要你用 RANGE 依日期分區,就一定要有一套「持續往後補分區」的計畫,否則遲早有一天凌晨會收到寫入失敗的告警。實務上有三種做法,我先把取捨攤開:
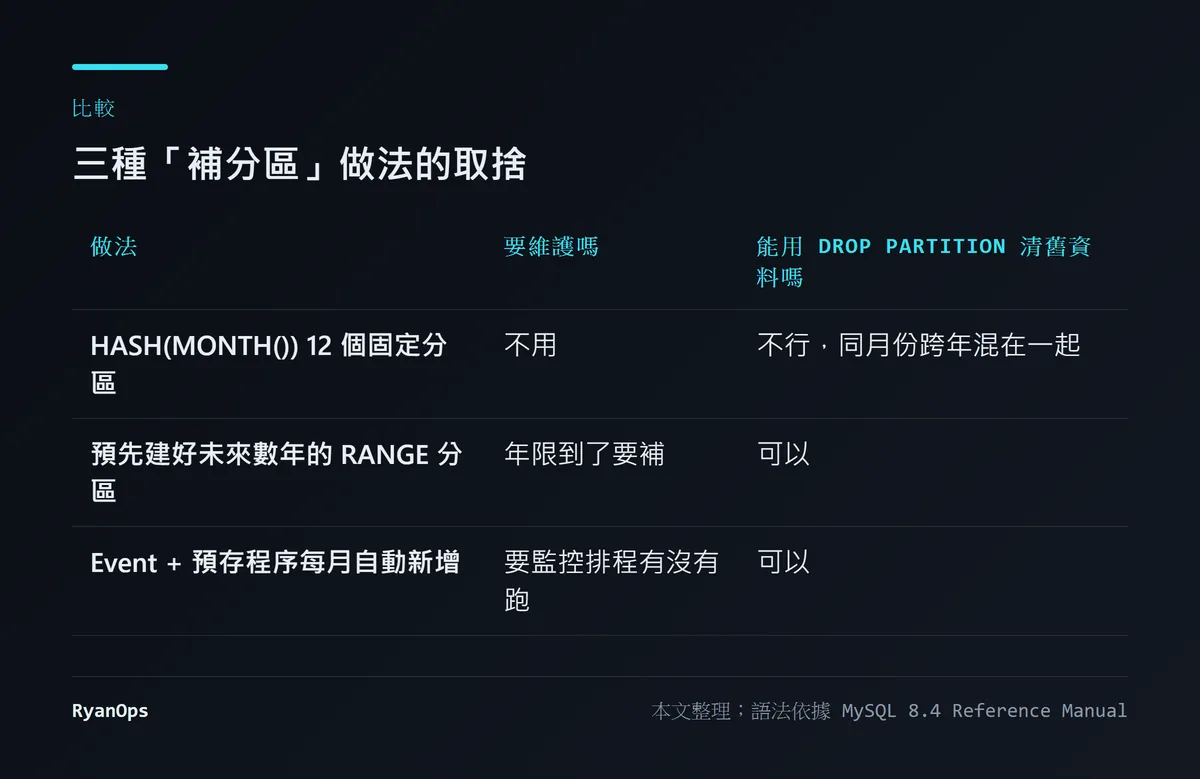 圖:三種補分區做法的取捨(本文整理,語法依據 MySQL 8.4 Reference Manual)
做法一:12 個固定分區,設完就不用管
用 MONTH() 把資料依 1 到 12 月分進 12 個固定分區:
CREATE TABLE failed_jobs (
    id BIGINT NOT NULL AUTO_INCREMENT,
    failed_at DATETIME NOT NULL,
    payload LONGTEXT,
    PRIMARY KEY (id, failed_at)
)
PARTITION BY HASH(MONTH(failed_at))
PARTITIONS 12;
代價藏在細節裡。2025 年 8 月跟 2026 年 8 月的資料會進同一個分區,因為分區依據只有「月份」這個循環的數字。你如果是想靠 DROP PARTITION 砍掉兩年前的資料,這個做法完全做不到。它只適合單純想把資料打散的情境。
做法二:一次把未來幾年的分區建好
CREATE TABLE failed_jobs (
    id BIGINT NOT NULL AUTO_INCREMENT,
    failed_at DATETIME NOT NULL,
    PRIMARY KEY (id, failed_at)
)
PARTITION BY RANGE COLUMNS(failed_at) (
    PARTITION p202601 VALUES LESS THAN ('2026-02-01'),
    PARTITION p202602 VALUES LESS THAN ('2026-03-01'),
    -- 中間依此類推寫到未來年份
    PARTITION p203012 VALUES LESS THAN ('2031-01-01'),
    PARTITION p_future VALUES LESS THAN (MAXVALUE)
);
不用排程,設一次能撐好幾年。缺點是年限到了還是要回來補。
這裡有一個我得更正的地方。這篇文章先前的版本寫「對已經有 MAXVALUE 分區的表下 ADD PARTITION 會讓表壞掉」。我這次回去查手冊,找不到這個說法的依據。手冊「Management of RANGE and LIST Partitions」那一頁給的例子是:新分區的上界如果沒有比現有分區都高,語句會直接報錯失敗,表本身沒事。
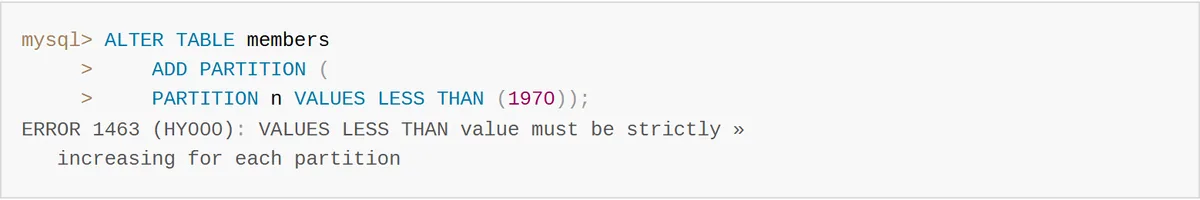 圖:手冊示範 ADD PARTITION 的上界不夠高時回傳 ERROR 1463(來源:dev.mysql.com)
MAXVALUE 已經是最高的上界,所以後面什麼都加不上去,這是我依照這條規則做的推論;手冊那一頁沒有單獨示範 MAXVALUE 的情況,我也沒有實機跑過,所以確切的錯誤碼我不寫死。能確定的是正確做法:用 REORGANIZE PARTITION 把 p_future 重新切成「新分區加上新的 MAXVALUE 分區」。手冊對這個操作有一句保證:拆分或合併分區不會遺失資料。
ALTER TABLE failed_jobs
    REORGANIZE PARTITION p_future INTO (
        PARTITION p203101 VALUES LESS THAN ('2031-02-01'),
        PARTITION p_future VALUES LESS THAN (MAXVALUE)
    );
做法三:讓 Event 每個月自己開分區
用預存程序搭配 MySQL 內建的 EVENT 排程器:
DELIMITER //
CREATE PROCEDURE auto_create_next_month_partition()
BEGIN
    DECLARE next_month_first_day VARCHAR(10);
    DECLARE partition_name VARCHAR(20);

    SET next_month_first_day = DATE_FORMAT(NOW() + INTERVAL 2 MONTH, '%Y-%m-01');
    SET partition_name = CONCAT('p', DATE_FORMAT(NOW() + INTERVAL 1 MONTH, '%Y%m'));

    SET @sql = CONCAT('ALTER TABLE failed_jobs ADD PARTITION (PARTITION ', partition_name, ' VALUES LESS THAN (\'', next_month_first_day, '\'))');
    PREPARE stmt FROM @sql;
    EXECUTE stmt;
    DEALLOCATE PREPARE stmt;
END //
DELIMITER ;

CREATE EVENT IF NOT EXISTS evt_auto_partition
ON SCHEDULE EVERY 1 MONTH STARTS '2026-08-25 00:00:00'
DO
  CALL auto_create_next_month_partition();
每個月都有獨立分區,清舊資料直接 DROP PARTITION。但有三件事要先對過。
權限。 建立、修改、刪除 Event 需要 EVENT 權限,這是手冊明寫的。這篇先前的版本還寫了要先 SET GLOBAL event_scheduler = ON,而且說需要 SUPER 權限,這兩點都要修正:8.4 手冊寫 event_scheduler 的預設值就是 ON,所以多數情況不用自己開;真的要改全域變數,需要的是 SYSTEM_VARIABLES_ADMIN,SUPER 還能用但已被標為 deprecated。代管的雲端 MySQL 會不會把排程器關成 DISABLED,每家不一樣,這點我沒辦法替你查,動手前先 SHOW VARIABLES LIKE 'event_scheduler'; 看一眼。
表結構。 這支預存程序用的是 ADD PARTITION,前提是表上沒有 MAXVALUE 分區。如果你的表是照做法二建的,要把它改成 REORGANIZE PARTITION,否則排程每個月都會報錯。
漏跑。 排程只要中斷過一個月,那個月的資料寫入就會失敗。我的建議是再加一個監控,定期檢查最新分區的上界離今天還有多遠。
所以該選哪一種?
我自己的看法是:資料量中等、沒有清舊資料的壓力,選做法二,它出事的方式最少。資料量大到真的要定期 DROP PARTITION,才值得上做法三,而且要用不含 MAXVALUE 的表定義去配。什麼會讓我改變這個判斷?如果你的團隊已經有成熟的排程監控,做法三的維運成本就低很多,那直接上也合理。
分區裁剪什麼時候會失效?
關鍵只有一個:你的 WHERE 條件有沒有帶到分區鍵。
拿前面的 orders 來說,WHERE created_at >= '2026-01-01' 可以讓 MySQL 直接跳過 p2024 跟 p2025。但 WHERE amount > 1000 完全沒提到 created_at,MySQL 只能每個分區都掃一遍。這時候分區沒有幫上忙,還因為要多開幾個檔案而多了一點開銷。
要確認有沒有生效,在查詢前面加 EXPLAIN,看輸出的 partitions 欄位列了幾個分區。
你也可以直接指定分區:
SELECT * FROM orders PARTITION (p2026) WHERE amount > 1000;這個語法在 DELETE、UPDATE、INSERT、REPLACE 也能用。
哪兩個限制最容易讓整個計畫卡死?
唯一鍵
手冊的原文只有一句:分區運算式用到的所有欄位,必須是這張表每一個唯一鍵的一部分,主鍵也算。
意思是,如果表上同時有 PRIMARY KEY(id) 跟 UNIQUE KEY(email),你幾乎沒辦法用 created_at 當分區鍵,除非把它塞進所有唯一鍵裡。手冊自己放了一個失敗的例子:
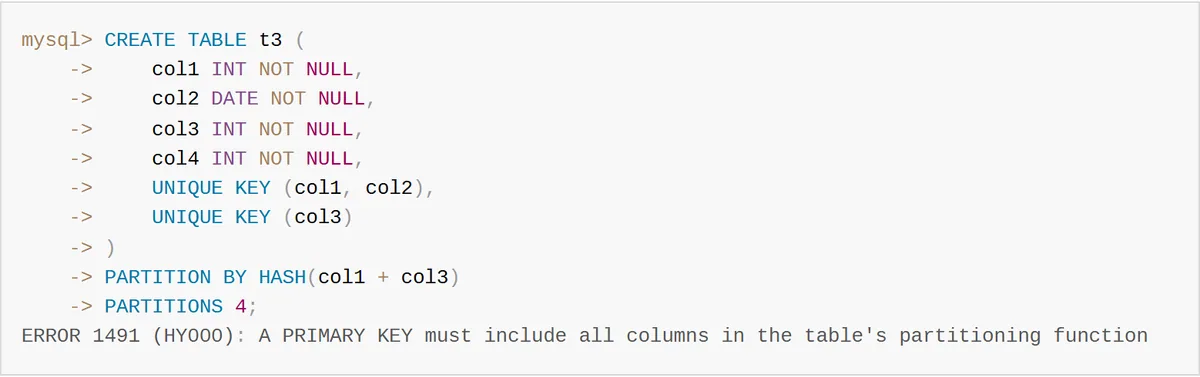 圖:手冊示範唯一鍵沒有涵蓋分區欄位時回傳 ERROR 1491(來源:dev.mysql.com)
有個細節值得你留意:圖裡的 t3 根本沒有主鍵,錯誤訊息卻寫「A PRIMARY KEY must include…」。第一次看到這個訊息很容易往錯的方向查,以為是主鍵定義出問題,其實是任何一個唯一鍵沒涵蓋到都會噴這句。
改造舊系統時,這條限制常常直接把分區計畫擋下來。動手前先把表上所有唯一鍵列出來。
外鍵
手冊寫得很絕:使用自訂分區的 InnoDB 表不支援外鍵。分區表不能定義外鍵去參照別人,別的表也不能用外鍵參照分區表。
如果你的資料庫靠外鍵維持參照完整性,導入分區前要先決定:這段檢查要搬到應用層自己做,還是接受拿掉約束。
分區數量
上限是多少?手冊給了數字:非 NDB 引擎的表最多 8,192 個分區,子分區也算在內。
但上限不是建議值。同一頁還寫了一句我覺得更實用的話:某些情況下,使用大量(數百個)分區可能並不可取,分區更多不會自動帶來更好的結果。它也提醒分區很多時要留意 open_files_limit,以及 LOAD DATA 會為每個分區配置 130 KB 的緩衝記憶體。所以如果你算出來需要上千個分區,比較可能是分區的粒度選錯了。
跟 PostgreSQL、Oracle、SQL Server 比呢?
這段我只講查得到文件的部分。
PostgreSQL 的宣告式分區同樣支援 range、list、hash 三種。它跟 MySQL 最大的差別是可以把一張獨立的表「掛上」或「卸下」分區(ATTACH PARTITION / DETACH PARTITION)。PostgreSQL 文件說這類操作是靠調整分區結構完成,幾乎瞬間,不用實際搬動大量資料。
不過「不搬資料」不等於「沒有成本」,這是我對照文件後想補的但書。文件明寫:執行 ATTACH PARTITION 時,那張表會被整張掃描來驗證分區約束,掃描期間該分區持有 ACCESS EXCLUSIVE 鎖。要避開這次掃描,官方建議先在表上加一條跟分區範圍相同的 CHECK 約束,掛上去之後再把它刪掉。DETACH PARTITION 預設需要父表的 ACCESS EXCLUSIVE 鎖,加上 CONCURRENTLY 才會降到 SHARE UPDATE EXCLUSIVE。
Oracle 跟 SQL Server 的分區功能歷史更久,前面提到的 INTERVAL 自動分區就是 Oracle 的。這兩套我這次沒有逐條去對官方文件,所以不在這裡做功能細節的比較。能說的只有一點:很少有團隊會單純為了分區功能換資料庫。
你的表到底該不該分區?
分區解決的是單一資料表在儲存、查詢、清理上的規模問題。它不處理「單台資料庫撐不住流量」,寫入吞吐量跟伺服器負載要靠讀寫分離、快取或分庫分表(sharding)。
我會用兩個問題來判斷:
- 這張表是不是已經大到備份、
DELETE、ALTER這種全表操作明顯拖慢維運? - 查詢是不是高度集中在某個可預期的欄位,最常見的就是時間?
兩題都是「是」,分區才拿得到「裁剪換效能、DROP 換清理速度」這兩個好處。只中一題,尤其是查詢條件五花八門、沒辦法穩定命中分區鍵的時候,你大概只是把一張表拆成一堆小檔案。
這篇是把文件翻到底的寫法。如果你想看另一種,從一個實際壞掉的畫面一路追到原因的除錯紀錄,可以看側邊欄從 200px 變成 48px 那一篇。


