Claude 沒解開黎曼猜想,但把臨界線上的零點比例下界從 41.6% 推到 67.2%
Anthropic 一個未發布的 Claude 研究版本,把黎曼 zeta 函數零點落在臨界線上的比例下界大幅提高。這個結果是什麼、怎麼做出來的、被檢查到什麼程度。
先把最重要的一句話放在前面:黎曼猜想沒有被解開。克雷數學研究所那一百萬美元還在原地。
八月的時候我寫這則新聞,只說模型「顯著推高了解的下界」。這句話沒錯,但等於沒講。到底是什麼的下界、從多少推到多少,原文沒寫,因為我當時只看了新聞報導。
這次我去讀了 Anthropic 自己的說明,也去看了它放在 GitHub 上的形式化證明。結果比「推高了下界」具體得多,也有意思得多:有一個數字,數學家花了 46 年把它從 33.3% 磨到 41.7%,一個還沒有名字的 Claude 版本在一天半裡把它推到了 67.2%。
這個結果到底在說什麼?
黎曼猜想講的是一個叫黎曼 zeta 函數的東西。這個函數有無窮多個「非平凡零點」,猜想說它們全部落在複數平面上的同一條直線上,這條線叫臨界線。
「全部」這兩個字沒有人證得出來。所以數學家退而求其次,問一個比較弱的問題:我們至少能證明有多少比例的零點在這條線上?
這個比例的下界有一段很長的歷史:
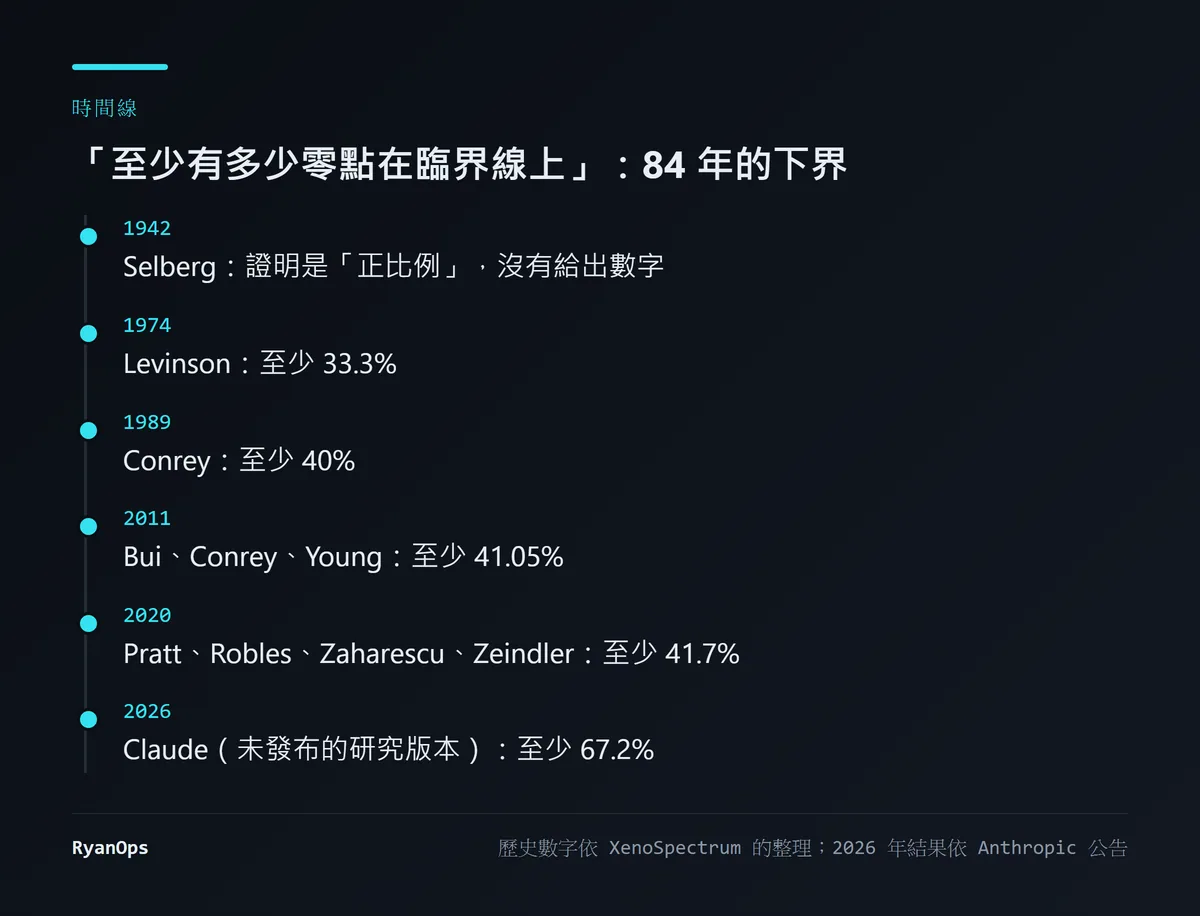 圖:臨界線上零點比例下界的歷史(本文整理;歷史數字依 XenoSpectrum,2026 年結果依 Anthropic 公告)
1942 年 Selberg 證明這個比例大於零。1974 年 Levinson 推到三分之一。1989 年 Conrey 推到 40%。然後就很慢了:2011 年 41.05%,2020 年 41.7%。XenoSpectrum 的報導算了一下,從 1974 到 2020 年,平均每年進步 0.18 個百分點,並且說 41% 出頭是既有方法(mollifier method)的天花板。
Anthropic 的公告寫,先前的下界是 41.6%,新的是 67.2%。(上面那張圖的 2020 年寫 41.7%,兩個數字出自不同來源,差了 0.1。我兩邊都照原樣列。)
要注意這個數字的意思。67.2% 是「至少」,不是「剛好」。它沒有說剩下的 32.8% 不在線上,只是說目前能證明的就這麼多。黎曼猜想要的是 100%。
這不就是往解開猜想前進了一大步嗎?
不是,而且 Anthropic 自己講得很白。公告裡的原話是:「我們不認為 Claude 用的技術會通往黎曼猜想的證明。」
這句話我覺得是整份公告最值得引的一句。一家公司在宣布自己的模型做出數學成果時,主動說這條路走不到終點。
道理是這樣的。把下界從 41% 推到 67% 用的方法,本質上是在估計「多少零點在線上」。這類方法就算一路推到 99.9%,也證明不了「沒有任何一個零點在線外」。那需要完全不同的想法。
所以正確的讀法是:這是一個獨立的、有意義的數論結果,剛好跟黎曼猜想有關。它不是那個大問題的進度條。
它是怎麼做出來的?
過程是我覺得最好看的部分,而且八月那篇有一處寫錯了。
起頭的人不是數學家。Anthropic 的員工 Jarred Sumner 叫 Claude「認真試試看」黎曼猜想,數學上的選擇全部交給模型。
第一次嘗試失敗了。 Claude 生成並試了 650 個想法,沒有一個行得通。八月那篇把「650 個想法」跟後面的成功寫成同一件事,其實 650 是失敗的那一輪。
第二次嘗試花了一天半,用了大約 60 個子代理。分工是這樣:
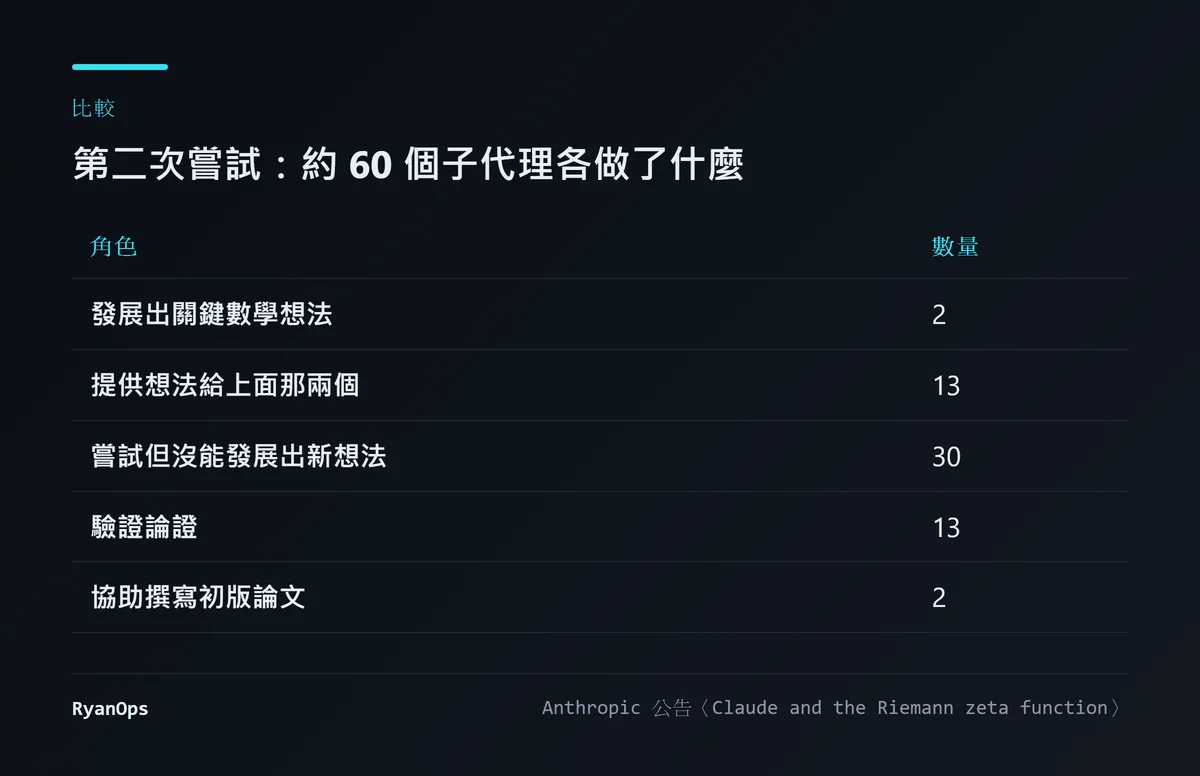 圖:第二次嘗試中子代理的分工(依 Anthropic 公告)
這張表有兩個地方值得看。
第一,真正做出關鍵想法的只有 2 個。30 個白忙一場,剛好一半。這個比例跟人類的研究團隊其實很像,大部分嘗試都不會有結果。
第二,驗證用了 13 個,跟提供想法的一樣多。它花在檢查上的人力不比花在想點子上的少。
公告列的工作量:大約 2,400 個 shell 指令、數百支 Python 腳本、數千次對照已知零點的數值檢查。兩次 Claude Code 工作階段合計大約 3,100 萬個輸出 token。八月那篇的開頭把它寫成「31 萬」,差了一百倍,這次更正。
數學上它做了什麼,我只能轉述。它把幾條既有的研究線接在一起:Montgomery 1973 年的技術(但那需要先假設黎曼猜想成立)、Aryan 以及 Baluyot、Goldston、Suriajaya、Turnage-Butterbaugh 讓這套技術不需要該假設的工作,再加上 Bombieri 2000 年的一篇論文。Anthropic 說關鍵的一步是把整個空間一起處理,並容許一個非對角的二次型。這句話我看得懂字面,看不懂它為什麼是關鍵,所以不多做解釋。
人類貢獻了什麼?
這是最妙的細節。公告說 Sumner 的輸入「大部分是鼓勵」,像是「繼續」跟「相信你自己」。Anthropic 說這幫助 Claude 克服了一開始的懷疑。
換句話說,模型一開始不相信自己做得到。公告裡有一句:「連 Claude 都對自己的發現感到意外。」還補了一句帶點自嘲的話:也許 Claude 跟我們很多人一樣,低估了 AI 進步的速度。
註腳還提到,同樣的鼓勵式提示也用在另一件事上:讓 Claude 嘗試推翻雅可比猜想。
這個細節我會放在心上。兩個月後 Anthropic 發了一份關於模型在評測中「繞過限制」的報告,把那種行為叫 persistence,持續性。同一種「不放棄」的傾向,放在數學題上是美德,放在一個被擋住的網頁前面就變成問題。
這個結果被檢查過了嗎?
這是我最想搞清楚的部分。一個 AI 說它證明了什麼,憑什麼相信?
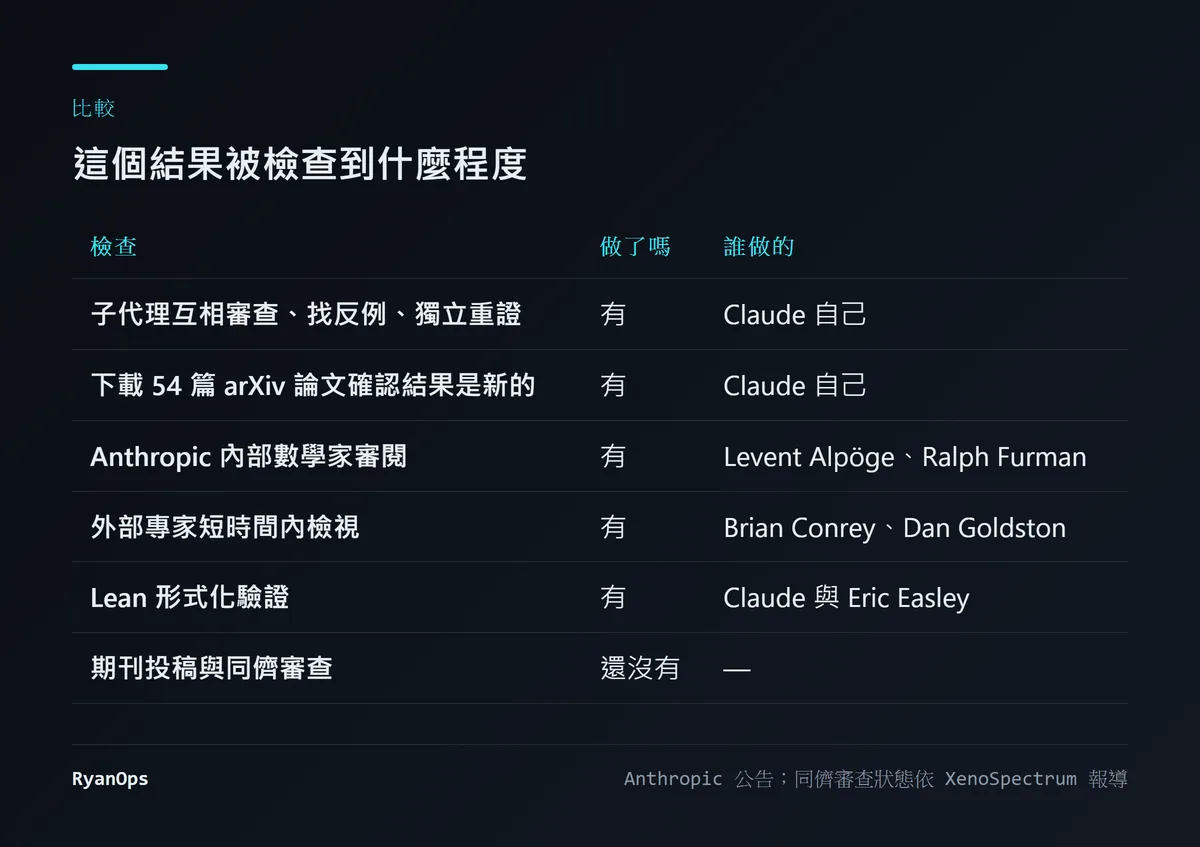 圖:這個結果目前被檢查到的程度(本文整理,依 Anthropic 公告與 XenoSpectrum 報導)
一層一層看。
模型自己做的:子代理互相審查、找反例、獨立重新證明一次,還下載了 54 篇 arXiv 論文確認這個結果是新的。然後它建議找一位人類數論學家來驗證。
Anthropic 內部兩位數學家 Levent Alpöge 跟 Ralph Furman 審閱了成果,寫了一份給專家看的簡短說明。
外部有兩位這個領域的專家 Brian Conrey 跟 Dan Goldston「在短時間內」看過論文。Conrey 就是上面那張歷史圖裡 1989 年把下界推到 40% 的人。
最後是形式化驗證。Claude 跟 Anthropic 的 Eric Easley 一起用 Lean 寫了機器可檢查的證明,放在 GitHub 上。我去看了那個儲存庫:
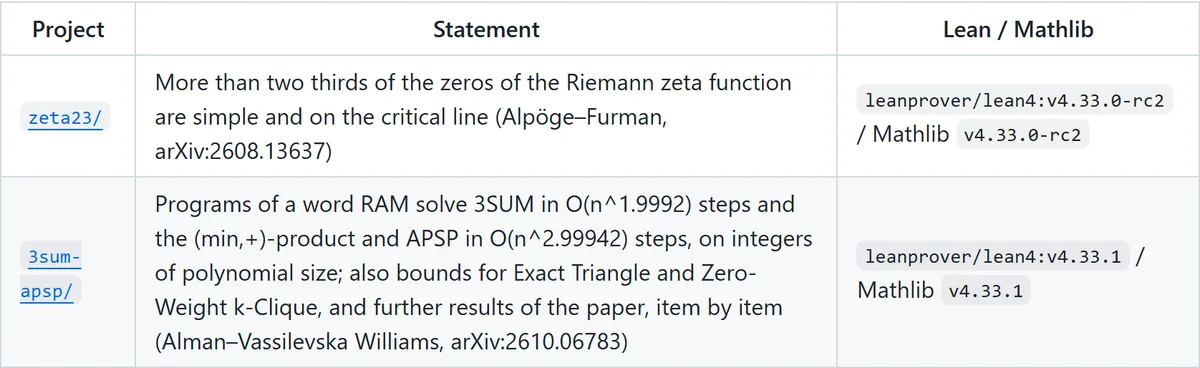 圖:Anthropic 公開的 Lean 形式化儲存庫說明(來源:github.com/anthropics/zeta-23-lean)
儲存庫的名字 zeta-23 指的就是三分之二。表裡的陳述比新聞稿多了一個詞:超過三分之二的零點是「單零點」而且在臨界線上。表裡把這個陳述標為 Alpöge–Furman,並附了一個 arXiv 編號。
README 寫了這個專案怎樣才算通過:在固定版本的工具鏈上建置成功,受信任的陳述檔之外不能有任何 sorry(Lean 裡代表「這裡先跳過」的佔位符),並且通過一個叫 comparator 的獨立檢查。
Lean 驗證能保證什麼,要講精確。它保證的是:從寫下的前提,用合法的邏輯步驟,確實推得出寫下的結論。它不保證那個結論就是大家以為的那個數學命題。陳述寫錯了,Lean 一樣會通過。這層判斷還是要靠人,上面那幾位數學家做的就是這件事。
還沒做的是傳統的那一步。XenoSpectrum 指出,這個結果還沒有投稿到期刊,也沒有經過正式的同儕審查。兩位外部專家的「短時間內檢視」,跟期刊審稿是不同性質的事。
我的判斷:以一個剛出來的數學結果來說,這個檢查程度算高,比多數預印本高。形式化證明是很強的證據。但「數學界已經接受」這句話現在還不能說。
數學界怎麼看 AI 做數學?
這不是今年唯一的案例。TechCrunch 的報導提到另外三件事:今年有好幾個 Erdős 問題被 AI 模型解開,OpenAI 公布了它內部的 Astra 模型證明的 10 個主要結果,Anthropic 另一項工作推翻了長期存在的雅可比猜想。這三件我沒有逐一去查細節,只照報導列出。
反應是分裂的。
今年六月,一群知名數學家簽署了〈萊頓宣言〉。TechCrunch 引了其中的核心主張:真正的證明應該「可歸屬於特定的作者,由他們取得發現的功勞,並為其正確性負責」。
菲爾茲獎得主 Timothy Gowers 在回應這份宣言的文章裡比較開放。他說,如果以後定理不再跟特定數學家的名字綁在一起,那也許不會比「星星不是用天文學家命名」這件事更有問題。
這次的結果剛好卡在這場爭論的正中間。模型沒有名字,是一個未發布的研究版本。形式化儲存庫把這個結果標在兩位審閱它的人類數學家名下。提出問題的人不懂數學,他的貢獻是說了幾次「繼續」。
那這個定理算誰的?
我自己的看法是,〈萊頓宣言〉擔心的「負責」這件事,在這個案例裡其實有人扛:Alpöge 跟 Furman 掛了名,等於替正確性背書。這是一個可行的做法,由人類數學家審閱、署名、負責,AI 做的事情寫清楚。它不漂亮,但它回答了「出錯找誰」。
比較難回答的是功勞。如果一個結果的關鍵想法出自 60 個子代理裡的 2 個,而這些子代理用完就消失了,「發現者」這個詞還適不適用,我不知道。
這篇的限制
- 數學內容我只能轉述,沒有能力獨立判斷證明對不對。
- 歷史下界的數字出自 XenoSpectrum 的整理,那篇自己對 2020 年的數字有 41.6% 跟 41.7% 兩種寫法。
- 過程的細節(子代理分工、token 數、鼓勵式提示)全部來自 Anthropic 自己的公告,沒有獨立來源。公告在 8 月 13 日更新過一次,換上了改寫過的論文。
- 那個模型是未發布的研究版本,外界無法重跑這個實驗。
- 其他 AI 數學成果(Erdős 問題、Astra 的 10 個結果、雅可比猜想)我只引了 TechCrunch 的一句話描述。


