Nvidia 的 Nemotron 3.5 Lightning:自家成績表 14 項沒拿到一項第一
Nvidia 在 8/11 釋出開放權重模型 Nemotron 3.5 Lightning。我把模型卡讀了一遍:它的賣點、官方成績表上輸給誰,以及你的顯卡到底跑不跑得動。
八月這篇文章的標題寫「一張 GPU 能跑、商用全免費」。兩句都不算錯,但都少了後半句。
這次重寫,我去 Hugging Face 把 Nvidia 自己放的模型卡從頭讀到尾。讀完的感想是:這個模型比新聞稿寫的誠實,也比新聞稿寫的普通。Nvidia 在自己的成績表上放了五個對手,14 項測試裡 Nemotron 3.5 Lightning 一項第一都沒拿到。
這不代表它沒用。它的賣點本來就不在分數。
它是什麼?
Nemotron 3.5 Lightning 在 2026 年 8 月 11 日釋出,放在 Hugging Face 跟 Nvidia 自己的平台上。模型卡上的規格:
- 總參數 300 億,每次推論啟用其中 30 億。這是混合專家(MoE)架構的特性,模型很大,但每個 token 只動用一小部分。
- 架構是混合式的,Mamba-2 層跟 MoE 層交錯,再加上部分注意力層。
- 上下文長度最高 100 萬 token。
- 授權是 OpenMDW License Agreement 1.1,模型卡寫明可商用。
IBTimes 當時的報導引了 Nvidia 的說法:這是一個「輕量」模型,企業可以下載、修改、使用,不用付錢給 Nvidia 也不用申請許可,而且特別為 AI 代理設計。報導還提到 CrowdStrike、CodeRabbit、Harvey 已經測試並客製過它。
用詞上有一點要講究。八月那篇的標題寫「開源」,比較精確的說法是「開放權重」:權重可以下載、可以商用,授權是 OpenMDW。這跟傳統意義的開源軟體授權不是同一回事,想搞清楚差別可以看名詞解釋裡的開放權重條目。
黃仁勳為什麼要送模型?
因為他賣的是晶片。這點他自己講得毫不遮掩:
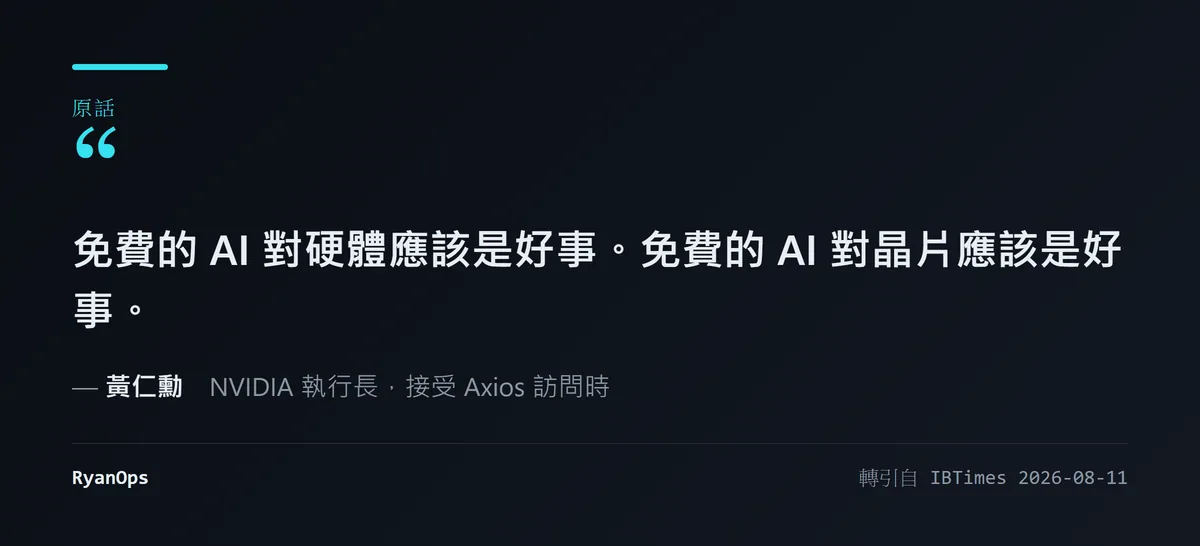 圖:黃仁勳對「免費 AI」的看法(接受 Axios 訪問時所說,轉引自 IBTimes 2026-08-11 的報導)
邏輯很直接。模型免費,用的人就多;用的人多,要跑模型的機器就多;機器裡裝的是他的 GPU。
時間上也有脈絡。7 月 24 日,黃仁勳在 X 上發了他的第一則貼文,分享一封產業公開信,呼籲政策制定者保留開放模型的取用管道,避免過早限制。他在貼文裡寫,開放模型能「強化安全與資安、加速創新與擴散,並促成技術主權」。兩週多之後這個模型就出來了。
八月那篇文章還寫了那封信的連署單位「從 25 個成長到超過 150 個」。這組數字我這次在來源裡找不到,已經刪掉。
這門生意的形狀,在別人身上看得更清楚。同一天宣布募到 11 億美元的 River AI,賣的就是幫企業微調開放權重模型,它官方範例程式碼裡的基礎模型就掛在 nvidia/ 底下,而 Nvidia 也是它的投資人。一個月後 Nvidia 宣布收購 Hugging Face,把放模型的地方也買了下來。送模型只是其中一步。
官方成績表怎麼說?
這是模型卡裡我覺得最值得看的一張表。我直接截給你:
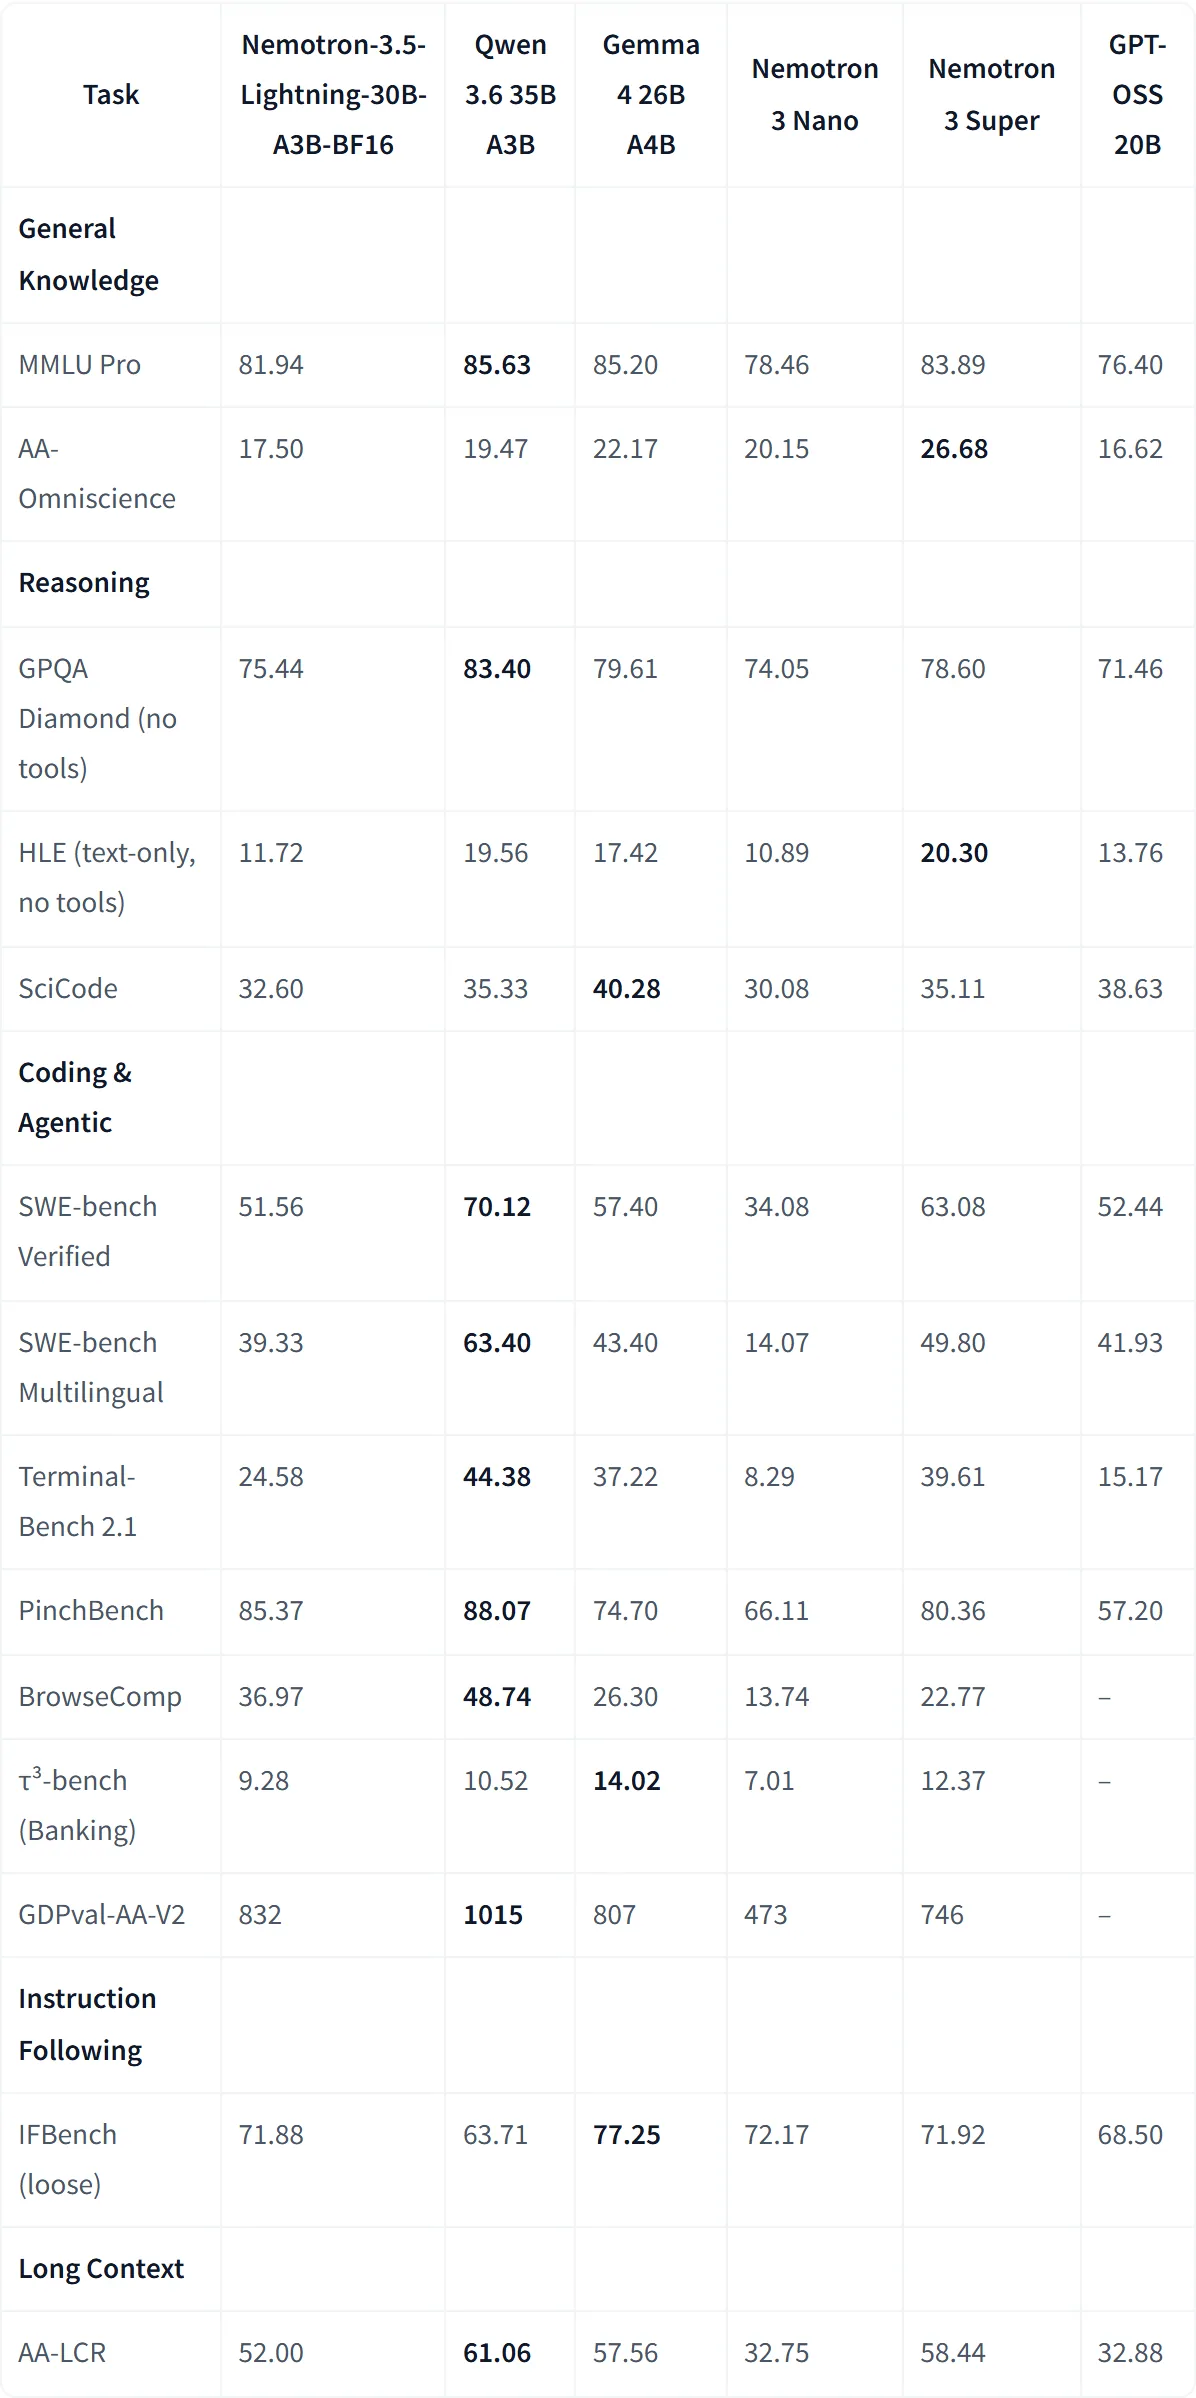 圖:Nemotron 3.5 Lightning 模型卡上的評測表,粗體是每一列的最高分(來源:huggingface.co)
粗體是每一列的最高分。我數了一下:
- Qwen 3.6 35B A3B 拿了 9 項第一。
- Gemma 4 26B A4B 拿了 3 項。
- Nvidia 自己比較大的 Nemotron 3 Super 拿了 2 項。
- Nemotron 3.5 Lightning 是 0 項。
差距不小的地方在寫程式跟代理任務。SWE-bench Verified 上 Lightning 是 51.56,Qwen 是 70.12。Terminal-Bench 2.1 是 24.58 對 44.38。這剛好是 Nvidia 說這個模型「特別為代理設計」的領域。
但這張表有另一種讀法,而且我覺得比較公平。
拿它跟自家上一代的小模型 Nemotron 3 Nano 比,進步很明顯。SWE-bench Verified 從 34.08 到 51.56,Terminal-Bench 從 8.29 到 24.58,BrowseComp 從 13.74 到 36.97。跟 OpenAI 的 GPT-OSS 20B 比也互有勝負。它在 PinchBench、BrowseComp、GDPval 這幾項也贏過 Gemma 4。
模型卡自己註明了兩件事。這些分數是 Nvidia 用自己的測試框架量的,可能跟各家自己公布的數字不同。還有,這個版本(BF16,全精度)主要是給人拿去做後續訓練跟客製化的起點,不是主要用來直接上線推論的。
我想講的是另一點:一家公司把自己輸掉的成績表原封不動放在模型卡上,這在這個產業不常見。多數新聞稿只挑贏的講。光是這一點,我對這張表上其他數字的信任度就比較高。
那它的賣點到底是什麼?
速度跟效率,至少官方是這樣定位的。
可惜這也是我能確認得最少的部分。八月那篇文章寫了三個數字:輸出速度比同級模型快最多 4 倍、任務完成快約 30%、跟 Anthropic 的 Opus 4.8 搭配使用可以把成本壓到三分之一。這三個數字,我這次在 IBTimes 的報導跟兩張模型卡上都沒找到。它們可能出自 Nvidia 的發表文章,但我沒辦法確認,所以全部拿掉了。原文還說它是從「Nemotron 3 Ultra」蒸餾來的,模型卡上沒有這個名字。卡上寫的是後訓練資料由多個模型蒸餾而來,舉的例子是 GPT-OSS-120B,資料表裡還列了 DeepSeek、Qwen、Kimi、GLM 等等。
模型卡上跟速度有關、我讀得到的只有一句設計目標:在 H100 上做互動式使用、並發數到 128 的情況下,每位使用者達到每秒 40 個 token 以上。這是目標,不是量測結果。
Nvidia 同時發表的還有 NeMo Switchyard,一套替每個任務挑選最合適、最划算模型的路由軟體。這大概才是它想講的完整故事:簡單的事交給便宜的小模型,難的才送去貴的大模型。Lightning 是那個便宜的選項。這套邏輯我覺得是通的,只是它的效果得看路由準不準,而這個我沒有數據。
你的顯卡跑得動嗎?
這是最多人關心、八月那篇也講得最含糊的問題。原文寫「一張消費級 GPU(筆電或桌機等級)」。IBTimes 的報導確實寫了它設計成能在個人電腦的單張 GPU 上跑。但模型卡上的說法精確得多,也嚴格得多。
先看官方的單 GPU 配置。全精度版本寫的是一張 H100 80GB 或 A100 80GB,而且在這種配置下上下文只驗證到 256K,要用滿 100 萬得上 8 張 H100。量化過的 NVFP4 版本列的單機選項是 DGX Spark 或 H100。這些都不是你家裡會有的東西。
消費級顯卡走的是另一條路,用 llama.cpp、Ollama、LM Studio 這類本機工具跑量化版。模型卡上有一段 Ollama 的建議,我整理成表:
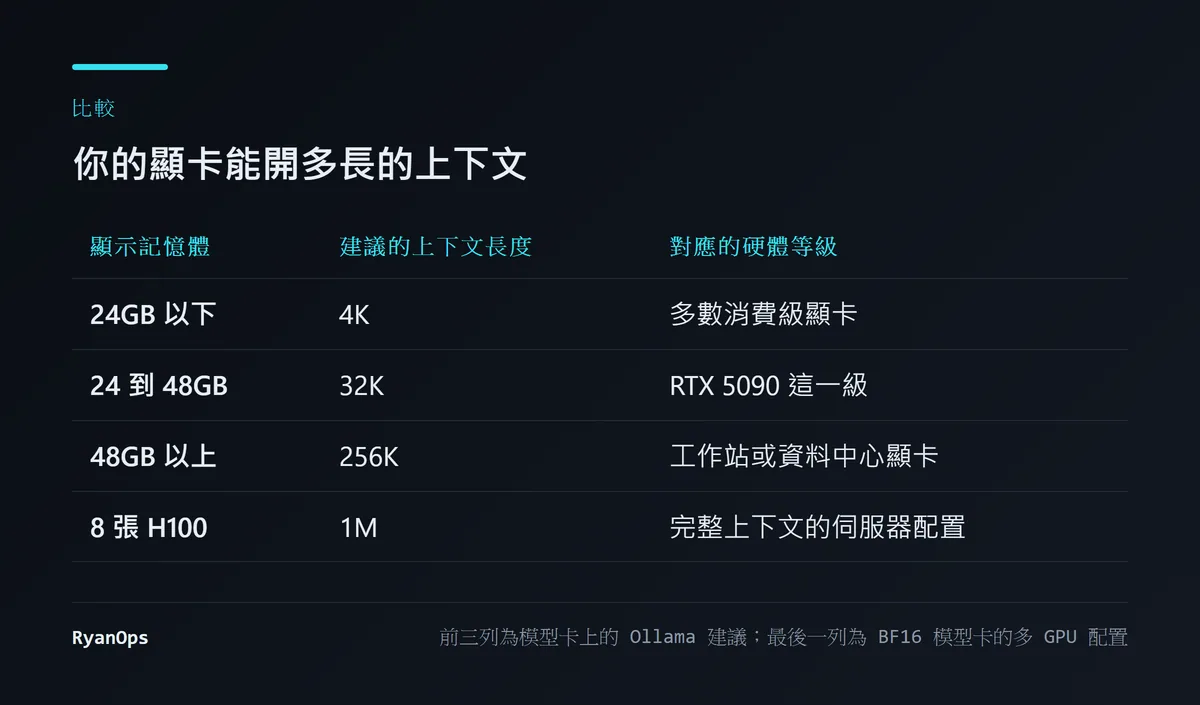 圖:不同顯示記憶體下建議的上下文長度(本文整理,依 Nemotron 3.5 Lightning 模型卡上的 Ollama 建議與多 GPU 配置)
所以「跑得動」跟「好用」是兩件事。24GB 以下的顯卡,建議的上下文只有 4K。一個號稱支援 100 萬 token、主打代理任務的模型,在你的顯卡上只能看 4,000 個 token,那跟它宣傳的用途差得很遠。代理任務動不動就要塞進整個程式碼庫跟一長串工具輸出。
再看檔案本身有多大。社群裡 unsloth 做的量化版最多人下載,我去看了它的檔案清單:
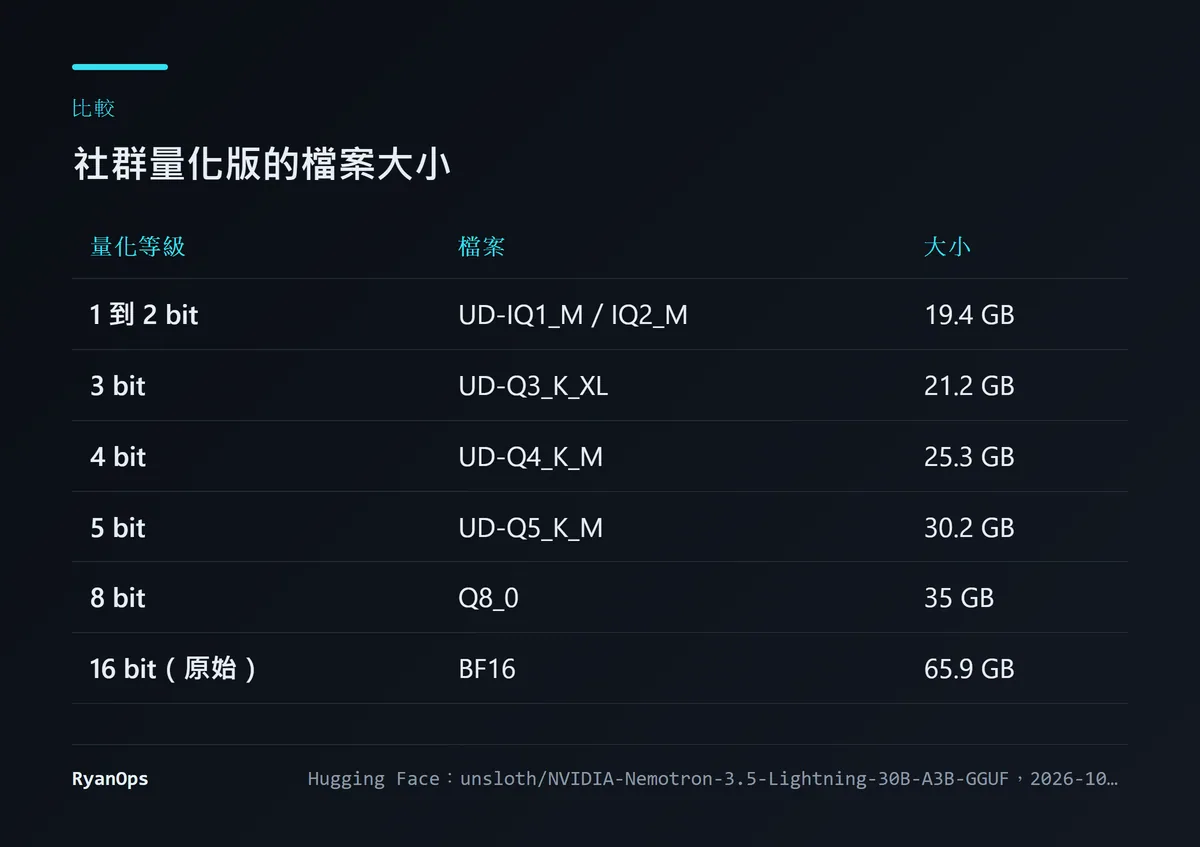 圖:unsloth 量化版的檔案大小(來源:Hugging Face 的 unsloth/NVIDIA-Nemotron-3.5-Lightning-30B-A3B-GGUF,2026-10-14 查閱)
最小的版本也要 19.4 GB。常用的 4 bit(Q4_K_M)是 25.3 GB,已經超過一張 24GB 顯卡的記憶體。壓到 1、2 bit 的版本塞得進去,但那種程度的量化通常會明顯傷到品質,而上面那張官方成績表量的是全精度版本。
我的結論是這樣。如果你手上是 24GB 的顯卡,它能跑,但你得接受很短的上下文或很兇的量化,兩者都會讓它離成績表上的數字更遠。如果你有 48GB 以上,或者一台 DGX Spark 這類機器,它才比較接近官方描述的樣子。那個頁面顯示上個月有四萬七千多次下載,所以確實很多人在試。
我自己沒有在本機跑過這個模型,以上全部是從模型卡跟檔案清單讀出來的。如果你想看一套真的以消費級顯卡為前提的本機流程,本地端 AI 動畫影片那篇比較接近。
所以該不該用它?
看你要的是什麼。
如果你要的是同尺寸裡分數最高的開放模型,照 Nvidia 自己的表,答案是 Qwen 3.6 35B A3B,不是這個。
如果你本來就在 Nvidia 的工具鏈上,要一個授權乾淨、可商用、官方有提供微調跟強化學習流程的起點,它是合理的選擇。模型卡把訓練流程寫得很細,這對要自己再訓練的團隊是實際的好處。
如果你是想在家裡的顯卡上跑一個聰明的本機模型,先看上面那兩張表再決定。
什麼會讓我改變看法?獨立機構量出來的速度數字。這個模型的全部論點都建立在「夠快、夠省」,而這恰好是我這次唯一找不到第一手數據的部分。
這次改寫更正了什麼
- 原文寫「消費級 GPU(筆電或桌機等級)」就能跑。模型卡上的單 GPU 配置是 80GB 的 H100 或 A100;消費級顯卡要靠量化版,而且上下文很短。
- 原文的三個效能數字(快 4 倍、快 30%、成本三分之一)與「由 Nemotron 3 Ultra 蒸餾」,我在這次查的來源裡找不到,已刪除。
- 原文的公開信連署數(25 到 150)找不到出處,已刪除。
- 原文稱它「開源」,這次改為「開放權重」,並寫出實際的授權名稱。
- 成績表、硬體需求、檔案大小都是這次從 Hugging Face 上直接讀的。


